
Tiefes Lernen (Deep Learning)
Deep Learning ist eine Form des Machine Learning. Wenn von künstlicher Intelligenz die Rede ist, sind meist verschiedene Anwendungen von Deep Learning gemeint. Das Prinzip von Deep Learning ist sehr einfach. Beim Deep Learning werden Repräsentationen in mehreren Schritten erzeugt. Diese Schritte werden Schichten (engl. layer) genannt, und ihr Zweck ist es, mit jeder Schicht bessere Repräsentationen zu erzeugen. Es ist nicht ungewöhnlich, mehrere hundert Schichten zu verwenden.
Beim Deep Learning sind diese Schichten in neuronalen Netzen (engl. neural networks) angeordnet. Die Bezeichnung leitet sich von den Nervenzellen des menschlichen Gehirns (Neuronen) ab. Neuronale Netze im Deep Learning sind von den Neuronen des Gehirns inspiriert. Das bedeutet jedoch nicht, dass neuronale Netze wie Nervenzellen funktionieren. Tatsächlich gibt es nur sehr wenige Ähnlichkeiten zwischen Deep Learning und der Art, wie Nervenzellen lernen. Die populärwissenschaftliche Darstellung von Deep Learning als digitale Version des Gehirns ist also falsch. Neuronale Netze mit vielen Schichten werden als deep neural networks (DNN) oder allgemeiner als Deep Learning bezeichnet.
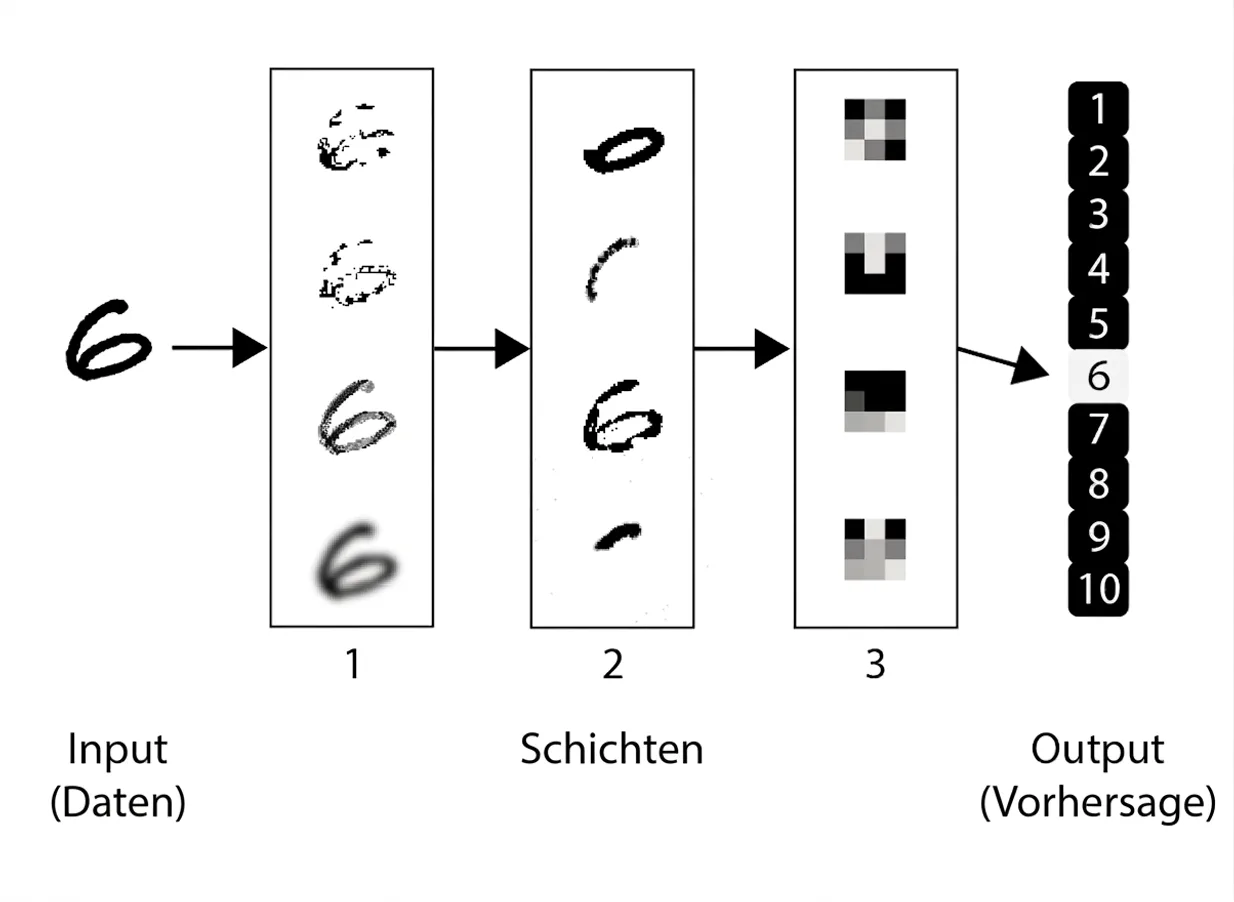
Die Aufgabe des neuronalen Netzes besteht darin, den Input (die eingespeisten Daten) in Repräsentationen zu transformieren, die sich zunehmend vom Input unterscheiden, zugleich aber informativer werden. Das neuronale Netz destilliert und filtert die Information so, dass in der letzten Schicht nur noch die nützlichen und charakteristischen Merkmale übrig bleiben. In der letzten Schicht ist die Information so weit verdichtet, dass das neuronale Netz anhand der Aktivierung in dieser Schicht entscheiden kann, um welche Ziffer es sich handelt.
Was geschieht in einer Schicht?
Jede Schicht nimmt Informationen (Zahlen) aus der vorhergehenden Schicht entgegen und verarbeitet diese Zahlen, bevor sie an die nächste Schicht weitergegeben werden. Während die Information durch die Schichten fließt, werden nützliche Repräsentationen extrahiert.
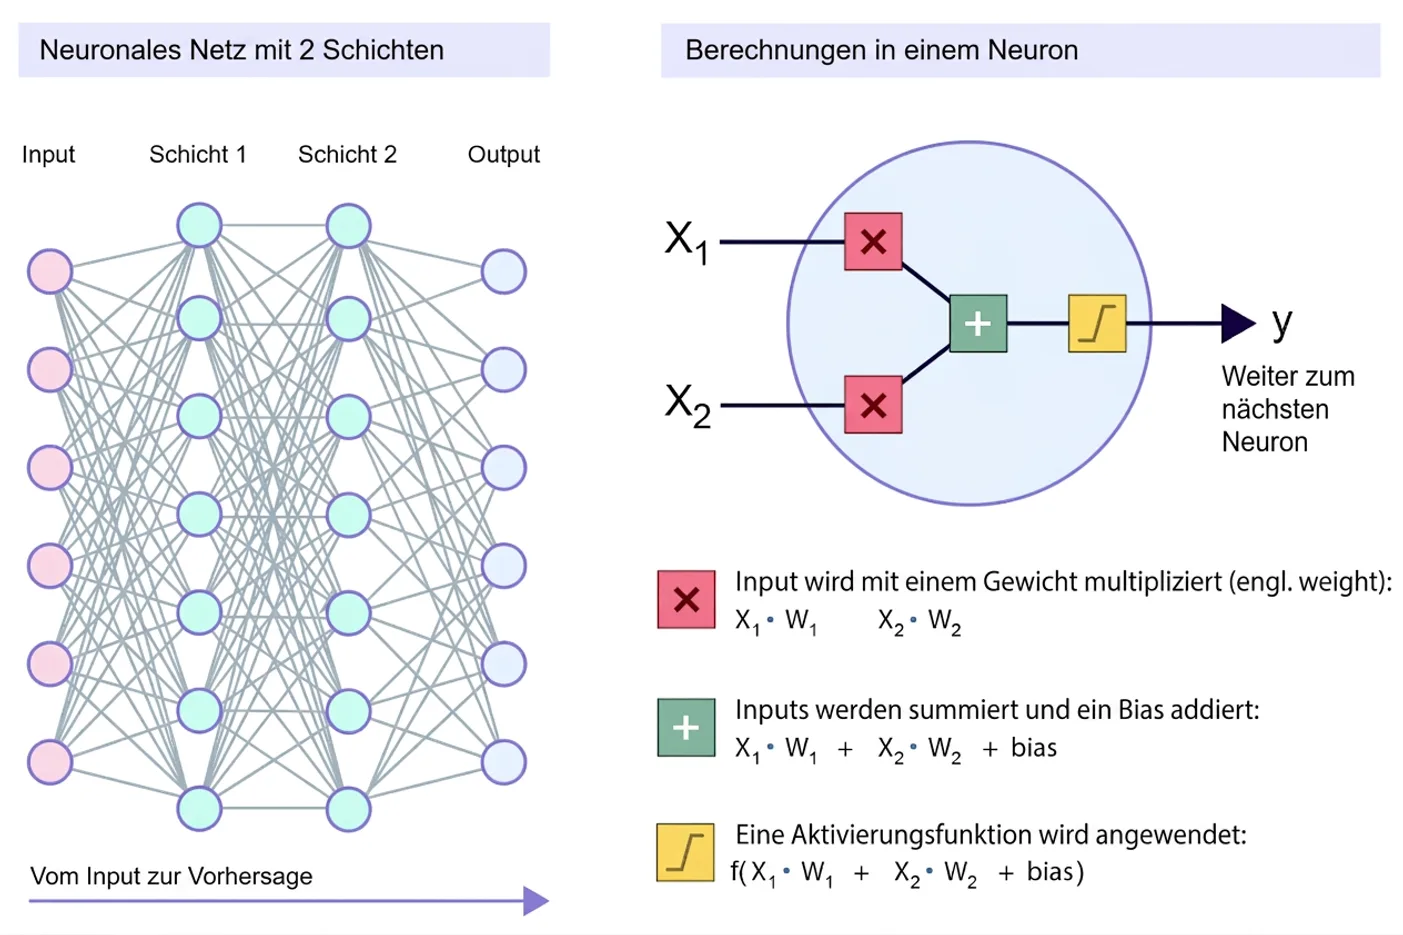
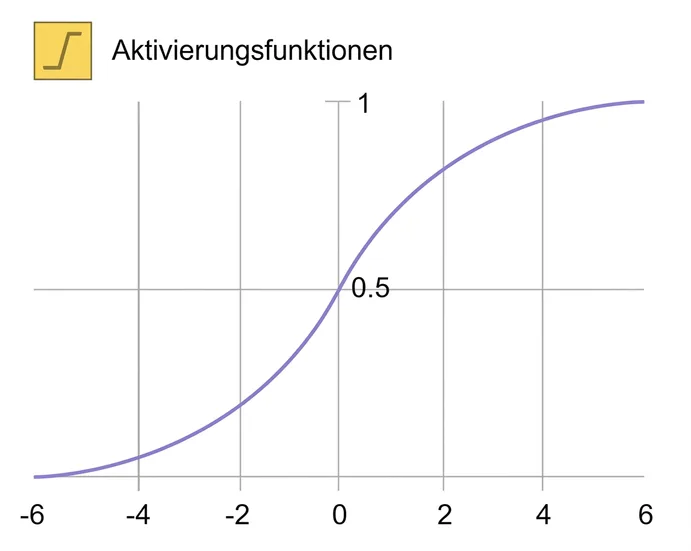
In jeder Schicht sind es Neuronen (Synonym: Knoten), die Informationen empfangen, verarbeiten und weitergeben. In der obigen Abbildung empfängt das Neuron x1 und x2, führt Berechnungen durch und gibt anschließend den Wert y weiter. Im Neuron wird jeder Input (jede eingehende Zahl) mit einem Gewicht multipliziert. Danach werden alle Inputs summiert, und ein Bias wird addiert. Das Ergebnis durchläuft anschließend eine Aktivierungsfunktion. Zweck der Aktivierungsfunktion ist es, das Endergebnis in eine leicht handhabbare Zahl umzuwandeln. Im obigen Beispiel ist die Aktivierungsfunktion eine sigmoide Funktion. Diese Funktion wandelt alle eingehenden Werte in eine Zahl zwischen 0 und 1 um. Große positive Zahlen nähern sich 1, große negative Zahlen nähern sich 0.
Die Gewichte sind für das neuronale Netz entscheidend. Mit den richtigen Gewichten funktioniert das neuronale Netz gut und bewältigt damit die Aufgabe, für die es entwickelt wurde. Die Herausforderung besteht darin, die richtigen Gewichte zu finden. Da ein neuronales Netz Millionen von Gewichten enthalten kann, wird dies zu einer sehr schwierigen Aufgabe. Noch schwieriger wird es, wenn man bedenkt, dass die Anpassung eines einzigen Gewichts das gesamte neuronale Netz beeinflussen kann. Die große Herausforderung besteht also darin, all diese Gewichte so anzupassen, dass sie für den jeweiligen Zweck optimal sind.
Die Gewichte werden mithilfe einer Loss-Funktion (oben besprochen) angepasst. Die Loss-Funktion berechnet einfach, wie groß der Unterschied zwischen der aktuellen Schätzung des neuronalen Netzes und dem wahren Wert ist. Dieser Unterschied wird Loss Score genannt. Ist der Loss Score groß, ist der Unterschied zwischen Schätzung und wahrem Wert groß, was schlecht ist. Ist der Loss Score klein, hat das neuronale Netz eine gute Schätzung abgegeben. Der Loss Score dient als Rückkopplungssignal (feedback signal), mit dem der Wert der Gewichte angepasst wird. Das bedeutet, dass das neuronale Netz seine eigene Leistung bewertet, das Ergebnis an sich selbst zurückmeldet und daraufhin die Gewichte anpasst, um seine Leistung zu verbessern. Die Gewichte werden dann in die Richtung angepasst, die den Loss Score verringert.
Jedes neuronale Netz besitzt einen Optimierer (engl. optimizer). Aufgabe des Optimierers ist es, die Rückkopplung zu steuern und die Gewichte im neuronalen Netz anzupassen. Der Optimierer verwendet einen Algorithmus, der als backpropagation algorithm bezeichnet wird.
Wenn das neuronale Netz zum ersten Mal aktiviert wird, sind die Werte aller Gewichte völlig zufällig. Das führt dazu, dass die Schätzung des neuronalen Netzes in der ersten Runde schlecht ausfällt (der Loss Score ist groß). Doch mit jedem Beispiel, an dem das neuronale Netz trainiert, passt es die Gewichte in die richtige Richtung an, und seine Leistung verbessert sich schrittweise. Wenn das neuronale Netz an Tausenden oder sogar Hunderttausenden von Beispielen trainieren kann, wird die Loss-Funktion schließlich minimiert, was bedeutet, dass das neuronale Netz seine Leistung maximiert hat.
Dieser einfache Mechanismus, bei dem jedes Neuron einen Input empfängt, eine einfache Transformation durchführt und einen Output weitergibt, erweist sich als äußerst leistungsfähig.
Ein neuronales Netz kann beliebig viele Schichten haben, und in diesen Schichten kann es beliebig viele Neuronen geben. Das Prinzip neuronaler Netze ist unabhängig von der Größe des Netzes dasselbe: Inputwerte einspeisen, sie durch die Schichten fließen lassen und schließlich in der letzten Schicht einen Output erhalten. In einem neuronalen Netz heißt die allererste Schicht input layer und die allerletzte Schicht (die Schicht vor dem label) output layer. Alle Schichten dazwischen heißen hidden layers. Während die Daten diese Schichten durchlaufen, lernt der Algorithmus, welche Muster vorhanden sind und wie diese Muster mit dem untersuchten Outcome korrelieren.
Was ist Bias?
Der Bias ist ein weiterer Parameter, der bei der Kalibrierung des neuronalen Netzes angepasst wird. Durch Anpassung des Bias lässt sich die Aktivität eines Neurons erhöhen oder verringern. Das bedeutet, dass es zwei Dinge sind, die angepasst werden, wenn sich das neuronale Netz kalibriert: Gewichte und Bias.
Das Prinzip von Deep Learning
Das neuronale Netz erzeugt Repräsentationen, während die Information durch die Schichten fließt. Wenn die Gewichte angepasst werden, werden manche Neuronen stärker, während andere schwächer werden oder sogar ganz verstummen. Das neuronale Netz steuert sich selbst mithilfe der Loss-Funktion. Deep Learning lässt sich somit als ein Prozess betrachten, bei dem Daten in mehreren Schritten gefiltert und, während sie durch die Schichten fließen, entschlüsselt werden.
Dieser Mechanismus führt dazu, dass die Schichten Schlüsselkomponenten der Daten extrahieren, und mithilfe dieser Komponenten lernt der Computer, welche Merkmale Hunde von Katzen unterscheiden.
Wenn ein Computer den Inhalt eines Bildes interpretieren soll, kann er die größeren Züge des Bildes nicht unmittelbar erkennen. Im Computer wird das Bild nämlich in ein Raster aus Zahlen umgewandelt, und diese Zahlen werden dann in das neuronale Netz eingespeist, wo die Information transformiert wird. Während der Transformation wird die wichtige Information extrahiert. Der Computer kann dann Linien, Ecken, Kreise usw. erkennen. Die Kombination verschiedener Geometrien wird anschließend genutzt, um unterschiedliche Objekte voneinander zu unterscheiden.
Warum ist Deep Learning so effektiv?
Es gibt viele Methoden zur Vorhersage. Manche Methoden sind allgemein und können auf vielen verschiedenen Arten von Daten Vorhersagen treffen, während andere Methoden spezifischer sind. Die allermeisten Methoden erfordern ein gewisses Maß an feature engineering, was bedeutet, dass die Rohdaten aufbereitet werden müssen, bevor sie analysiert werden können. Das kann beispielsweise bedeuten, dass man den Inhalt eines Fotos manuell in ein analysierbares Format umwandeln muss. Diese manuelle Arbeit ist in der Regel sehr aufwendig und kompliziert. Beim Deep Learning ist das Feature Engineering vollständig automatisiert. Das neuronale Netz erledigt dies ganz automatisch, unabhängig davon, wie die Daten aussehen. Im Gegensatz zu anderen Analysemethoden kann Deep Learning tabellarische Daten, Bilder und Videos verarbeiten.