Learning im Machine Learning (maschinelles Lernen)
Der Mensch besitzt eine bemerkenswerte Fähigkeit, einfache Repräsentationen komplexer Informationen zu bilden. Wir lernen über unsere Sinne (Sehen, Hören, Schmecken usw.), die in der Lage sind, aus allen Sinneseindrücken nützliche Repräsentationen zu erzeugen. Betrachten wir ein Foto eines Waldes, erkennen wir sofort, dass es sich um einen Wald handelt; wir müssen nicht genau analysieren, welche Farbe die Bäume haben oder wie die Blätter aussehen. Unser Gehirn extrahiert aus dem Bild die Information, die nötig ist, um zu entscheiden, ob es ein Wald ist oder nicht. Ebenso können wir feststellen, ob auf dem Foto ein Fahrrad zu sehen ist. Das Gehirn sucht nach zwei runden Objekten (den Rädern), die an einer dreieckigen Struktur (dem Fahrradrahmen) befestigt sind. Sie suchen nach den Strukturen, die für ein Fahrrad typisch sind: Räder, Rahmen, Sattel, Lenker. Diese Komponenten sind Repräsentationen des größeren Zusammenhangs: des Fahrrads.
Das Prinzip des Machine Learning, und insbesondere des Deep Learning, ist genau dasselbe, nämlich Repräsentationen in Daten zu finden. In den allermeisten Fällen verwendet man Trainingsdaten (siehe oben), für die eine gewünschte Klassifikation vorliegt. Ein Beispiel:
Sie möchten eine Software entwickeln, die auf Fotos Hunde von Katzen unterscheiden kann. Für diese Aufgabe haben Sie 5000 Fotos gesammelt, von denen etwa die Hälfte Hunde zeigt. Alle Fotos wurden (von einem Menschen) als „Hund“ oder „Katze“ beurteilt bzw. klassifiziert. Der Computer analysiert alle Fotos, um Repräsentationen zu finden, die jeweils für Hund bzw. Katze spezifisch sind.
Die Grundlage der künstlichen Intelligenz, und damit des Deep Learning, besteht darin, gute Repräsentationen von Daten zu finden. Damit ein Computer Repräsentationen erzeugen kann, muss er die Daten transformieren (umformen). Ziel der Transformation ist es, die Information zu destillieren: Rauschen wird entfernt, und wertvolle Information wird fokussiert und verstärkt. Beim Deep Learning werden die Daten in der Regel in mehreren Schritten transformiert, und bei jeder Transformation versucht der Computer, informative Repräsentationen des Inhalts zu erzeugen. Sind genügend Transformationen durchgeführt, hat der Computer gelernt, welche Repräsentationen für Katze bzw. Hund typisch sind.
Eine gute Repräsentation zeichnet sich durch zwei Eigenschaften aus: (1) Sie enthält wertvolle Information, und (2) sie ist reproduzierbar. Auf dem Foto mit dem Fahrrad sind die runden Strukturen (die Räder) sehr informativ, und es ist wichtig, sie zu finden. Außerdem ist es wichtig, die Räder jedes Mal zu finden, wenn sie auf dem Foto vorhanden sind, unabhängig von der Umgebung des Fahrrads, den Farben und der Position des Fahrrads auf dem Foto.
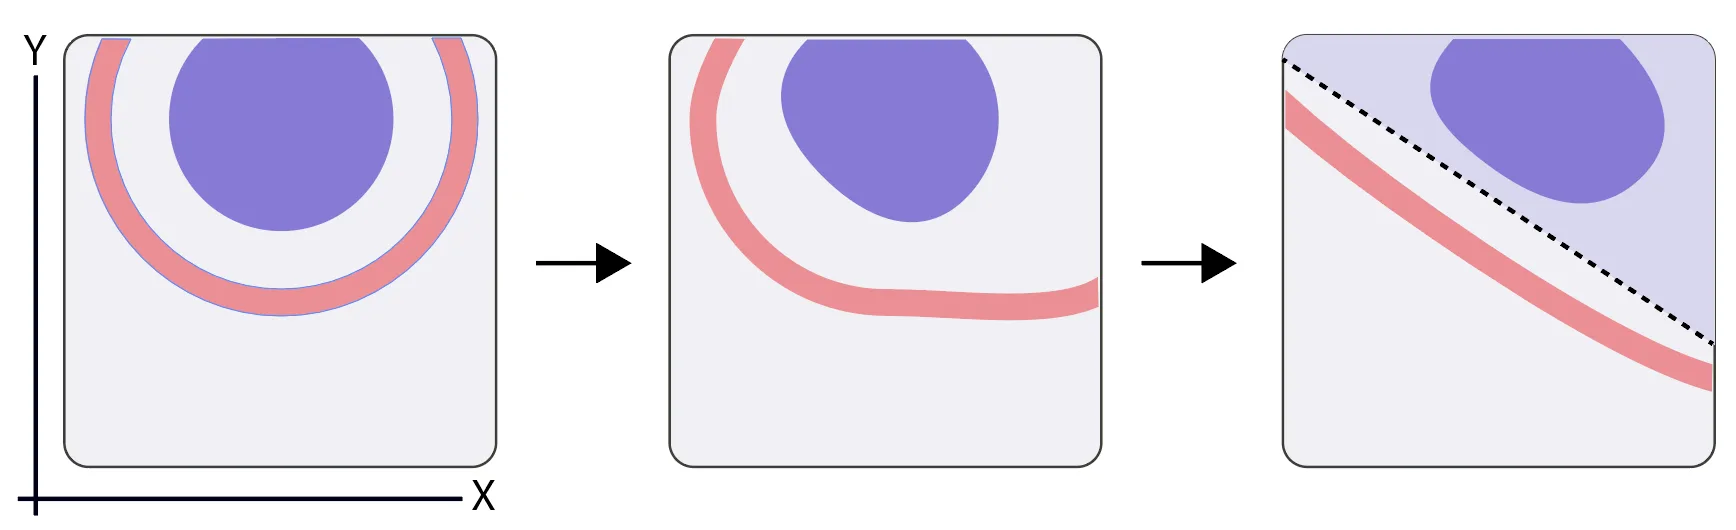
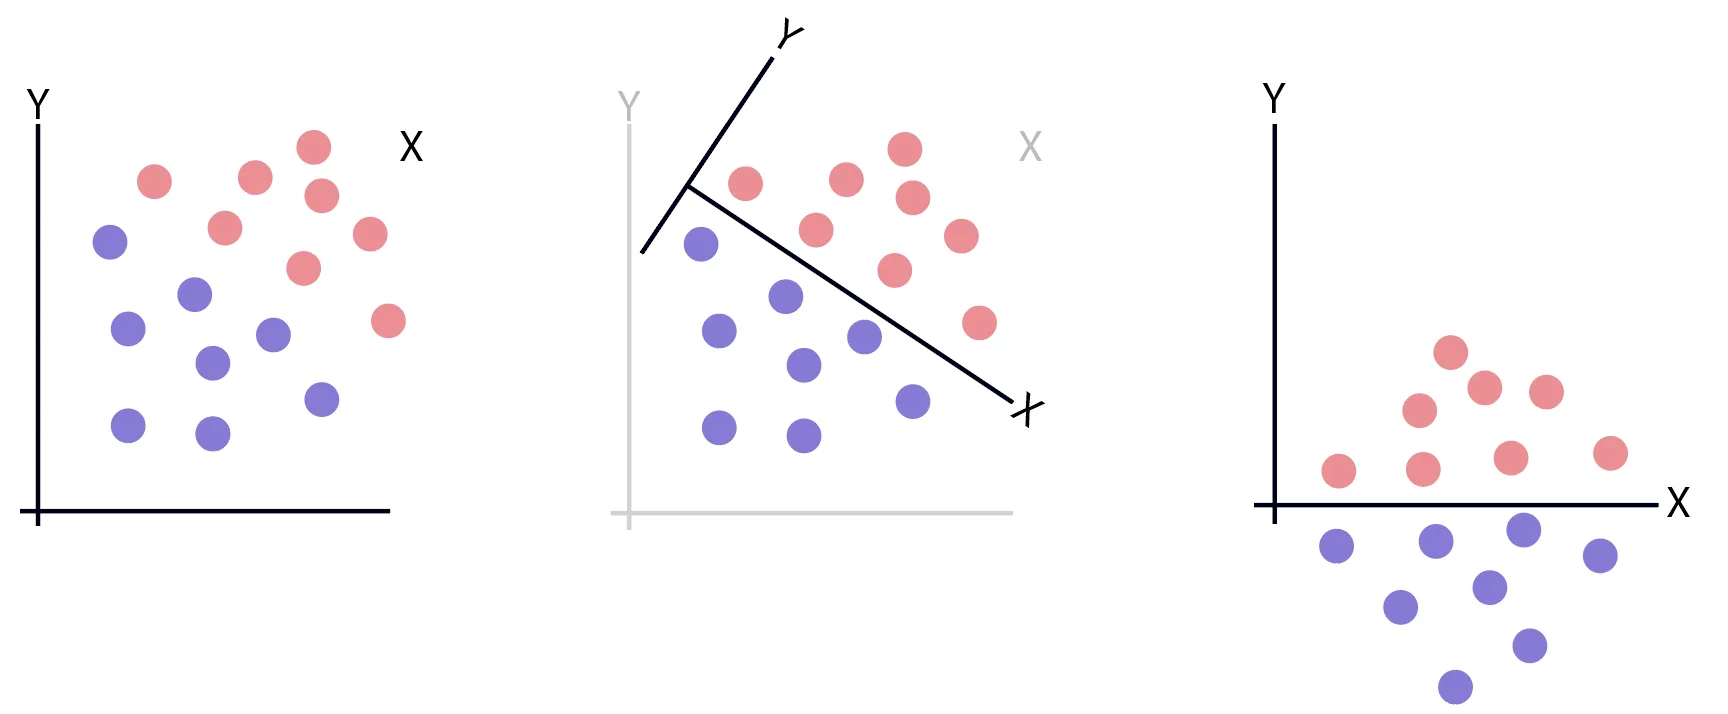
Mit Machine Learning lassen sich Repräsentationen automatisch finden. Mithilfe verschiedener Algorithmen sucht man nach nützlichen Transformationen. Die Repräsentationen werden mithilfe recht einfacher mathematischer Operationen gefunden. Diese Operationen können beispielsweise darin bestehen, dass die Maschine alle Werte herausfiltert, die größer als X sind, oder alle Koordinaten auf eine bestimmte Weise verändert (Beispiele folgen in Abbildung 1 und 2). Auch wenn die Transformationen einfach sind, zeigt sich, dass sie äußerst effektiv werden können, wenn die Maschine die richtige Rückmeldung (Feedback) erhält. Tatsächlich lassen sich die Transformationen, wenn die Maschine die richtige Rückmeldung darauf erhält, zur Lösung sehr komplexer Aufgaben einsetzen, etwa zum Übersetzen von Texten, zum Fahren von Autos, zur Interpretation von Bildern usw.
Rückkopplung (Feedback)
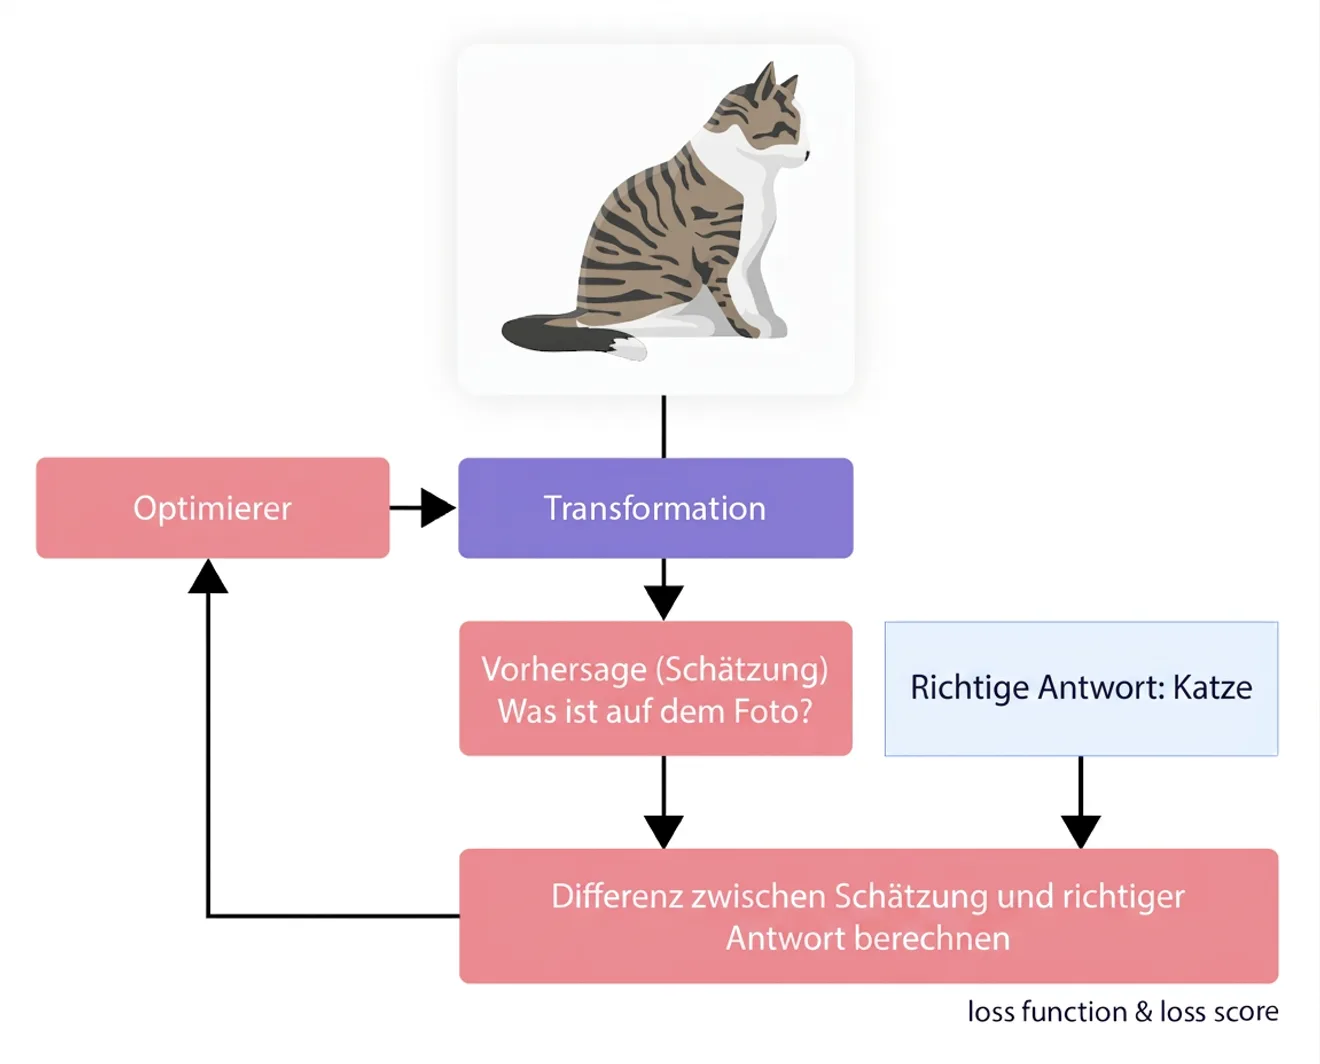
Angenommen, wir haben 5000 Fotos von Hunden und Katzen. Unser Ziel ist es, ein Programm zu erstellen, das entscheiden kann, ob auf dem Foto ein Hund oder eine Katze zu sehen ist. Zur Unterstützung haben wir einen Machine-Learning-Algorithmus, der neue Repräsentationen in Daten finden kann. Die Maschine transformiert die Daten und versucht, Repräsentationen zu finden, die für Katzen bzw. Hunde typisch sind. Die Maschine testet diese Repräsentationen, indem sie zu erraten versucht, welches Tier das Foto zeigt. Da die Maschine die Lösung (die richtige Antwort) kennt, kann sie beurteilen, ob die Vermutung gut oder schlecht war. Dies ist ein entscheidender Schritt in jedem Machine Learning. Die Maschine lernt nämlich, indem sie bewertet, wie gut ihre Vermutungen sind, und die Differenz zwischen der Vermutung der Maschine und der richtigen Antwort wird mit einer sogenannten Loss-Funktion (engl. Loss function) berechnet. Die Differenz zwischen der Vermutung und der richtigen Antwort wird als Loss Score berechnet. Die Maschine meldet den Loss Score an einen sogenannten Optimierer zurück, der die Transformation anpassen kann; Ziel der Anpassung ist eine Transformation, die den Loss Score verringert. Je kleiner der Loss Score, desto näher liegt die Vermutung an der richtigen Antwort. Auf diese Weise kann Machine Learning dazu angeleitet werden, Repräsentationen zu finden, mit denen sich bestimmen lässt, was auf dem Foto zu sehen ist.