
Begriffe und Konzepte in KI und ML
Daten
Auch wenn dieser Begriff etwas unscharf definiert ist, meint man damit in der Regel die Daten, die einem zur Verfügung stehen. Im Beispiel des Onlineshops sind die Daten Informationen über die Besucher und ihre Käufe. Daten müssen jedoch nicht in Tabellenform vorliegen; Bilder, Videos, Diagramme u. a. sind ebenfalls Daten.
Modell (Prädiktionsmodell)
Daten werden mithilfe mathematischer Funktionen untersucht, und die Zusammenfassung dieser Funktionen nennt man Modell. Man sagt, dass man Daten verwendet, um ein Modell zu erstellen. Dieses Modell kann dann beispielsweise genutzt werden, um vorherzusagen, ob neue Patienten an Krebs erkranken werden oder ob neue Besucher im Onlineshop einkaufen werden. Das Modell fasst zusammen, was der Computer durch Machine Learning gelernt hat. Die Begriffe Modell und Prädiktionsmodell sind in diesem Zusammenhang synonym.
Training
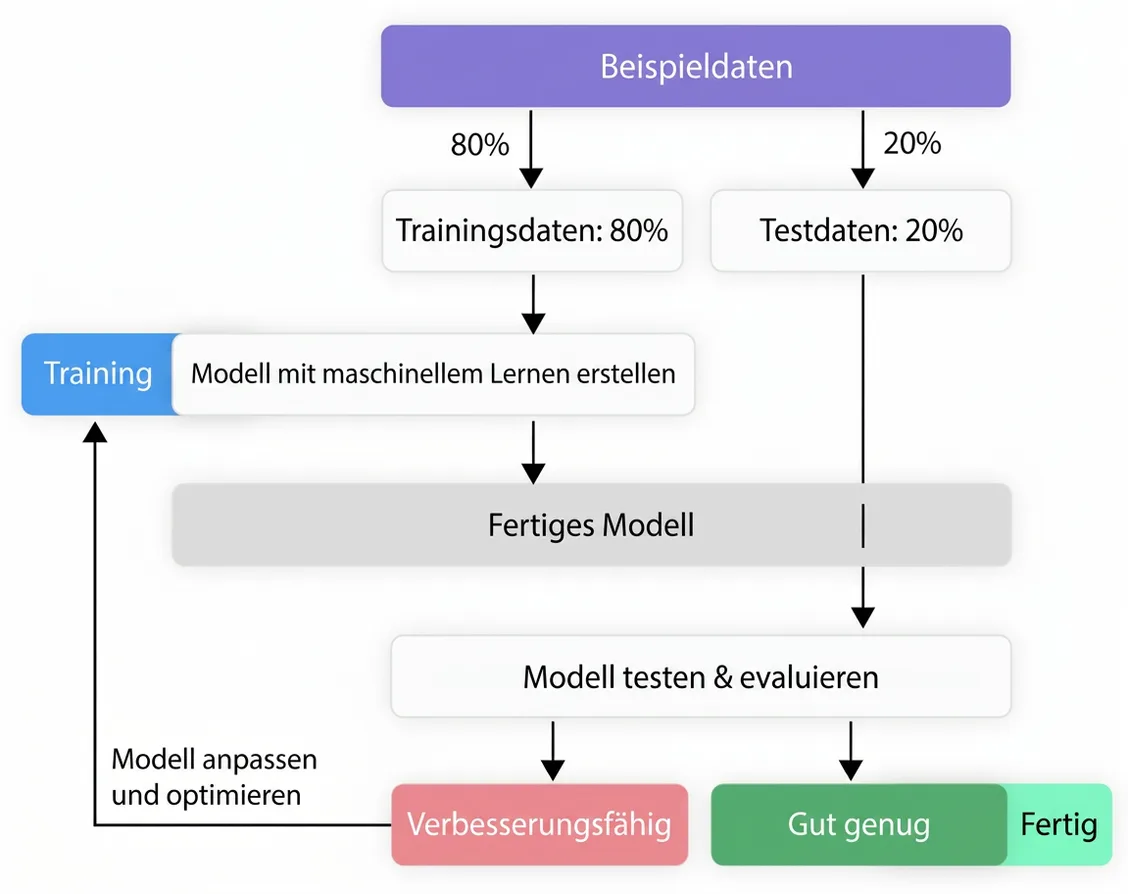
Um ein Modell zu erstellen, braucht man Beispieldaten. Im Beispiel des Onlineshops benötigten wir Daten von vielen Besuchern und deren Verhalten, bevor wir Vorhersagen für neue Besucher treffen konnten. Beispieldaten (Trainingsdaten) werden verwendet, damit das maschinelle Lernen die Muster findet, die in den Daten enthalten sind. Diese Phase heißt Training (engl. training), weil die Maschine mithilfe der Beispieldaten trainiert wird. In der Regel verwendet man 80 % aller Daten für das Training.
Testen (Testing)
Die 20 % der Daten, die nicht für das Training verwendet werden, können zum Testen genutzt werden. Beim Testen bewertet man, wie gut das Modell ist, und dies muss mit Daten geschehen, mit denen das Modell nicht trainiert wurde. Beim Testen geht es also darum, die Präzision bzw. Leistungsfähigkeit des Modells zu bewerten.
Es ist wichtig, das Modell immer mit Daten zu testen, die das Modell während der Trainingsphase nicht gesehen hat. Das Modell wird nämlich auf Daten, die es „während des Trainings gesehen“ hat, immer eine hohe Präzision aufweisen. Die Präzision auf den Testdaten wird immer niedriger sein, und genau diese Präzision interessiert uns, da sie besser anzeigt, wie das Modell auf zukünftigen Daten abschneidet. Die Aufteilung 80/20 kann je nach Situation und Daten angepasst werden.
Variable
Mit „Variable“ meint man üblicherweise die Spalten einer Tabelle. Jede Spalte beschreibt eine Eigenschaft der untersuchten Einheiten (Patienten, Besucher usw.).
Prädiktor (Feature)
Alle Variablen, die zur Vorhersage der Zielgröße verwendet werden, sind Prädiktoren. Mit anderen Worten: Ein Prädiktor ist eine Variable, die verwendet wird, um die Zielgröße vorherzusagen. Im Beispiel der Schüler sind ihre Anwesenheit in der Schule und das Einkommen der Eltern Beispiele für Prädiktoren.
Zielgröße, Outcome, Label
Die Zielgröße ist das, was man mithilfe des Modells vorherzusagen versucht. Im Beispiel der Schüler ist die Zielgröße ihre Abschlussnote. Im Beispiel des Onlineshops ist die Zielgröße, ob die Besucher Waren kaufen. Die Zielgröße ist also das, was man vorhersagen möchte.