
Regression
Mit der Regression untersucht man den Zusammenhang (die Assoziation) zwischen zwei oder mehr Variablen. In einer Regressionsanalyse wird eine Variable () durch mindestens einen Prädiktor () vorhergesagt. Terminologisch sagt man, sei von abhängig; ist daher die abhängige Variable und die unabhängige Variable.
| Aufgabe im Modell | Synonym | |
|---|---|---|
| Y | Die Variable, die vorhergesagt werden soll | Abhängige Variable, dependent variable, Outcome, Zielgröße, Zielvariable, label, target |
| X | Wird zur Vorhersage von Y verwendet | Prädiktor, predictor, feature, Kovariate, covariate |
Angenommen, wir untersuchen den Zusammenhang zwischen BMI (Body-Mass-Index) und Blutzucker. Mit der Regression können wir die eine Variable verwenden, um den Wert der anderen vorherzusagen. In diesem Fall wird der BMI zur Vorhersage des Blutzuckers verwendet. Der BMI ist somit die unabhängige Variable (Prädiktor) und die Glukose die abhängige Variable (Outcome).
Wir veranschaulichen die lineare Regression mit Daten von Pima-Indianern, die ein sehr hohes Diabetesrisiko haben. Die Daten der Pima-Indianer sind im Package mlbench enthalten. Installieren Sie mlbench, laden Sie das Package und anschließend die Daten der Pima-Indianer mit folgendem Befehl:
library(mlbench)
data(PimaIndiansDiabetes)

## Grafik des Zusammenhangs zwischen mass und glucose
ggplot(data=PimaIndiansDiabetes,
       aes(x=mass, y=glucose, color=diabetes)) +
  geom_point() +
  geom_smooth()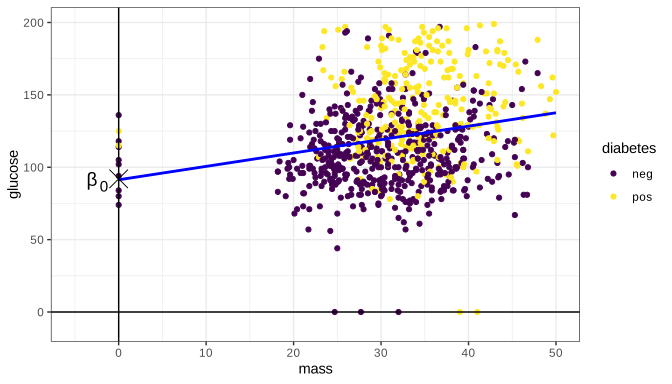
Die obige Abbildung zeigt, wie der BMI (mass) mit dem Blutzucker (glucose) assoziiert ist. In der Grafik ist eine gerade blaue Linie zu sehen, die Regressionsgerade für mass. Der Zusammenhang zwischen mass und glucose lässt sich mit einer einfachen Formel beschreiben.
- ist der Achsenabschnitt (Intercept), also der Punkt, an dem die Regressionsgerade die Y-Achse schneidet (siehe Abbildung oben).
- ist der Koeffizient für
mass, also der Wert der Steigung der Regressionsgeraden. - ist die Differenz zwischen dem vom Modell vorhergesagten Wert von und dem beobachteten Wert von . Dies ist also der Fehler des Modells (error).
Zusammengefasst handelt es sich um ein Modell, das mithilfe einer Regressionsgeraden mit der Steigung vorhersagt. Der Achsenabschnitt () interessiert uns nur sehr selten. Der Fehler des Modells () ist ein Maß dafür, wie gut das Modell ist.
Ziel ist es, eine Regressionsgerade zu erstellen, deren Steigung so angepasst wird, dass sie den Zusammenhang zwischen und abbildet. Die Steigung der Geraden hängt vom Zusammenhang zwischen mass und glucose ab. Die Steigung für mass wird auch als Koeffizient für mass bezeichnet. Wenn glucose mit zunehmendem mass ansteigt, hat die Regressionsgerade eine positive Steigung. In der obigen Abbildung ist zu erkennen, dass die Gerade eine positive Steigung hat, weshalb der Koeffizient für mass positiv ist.
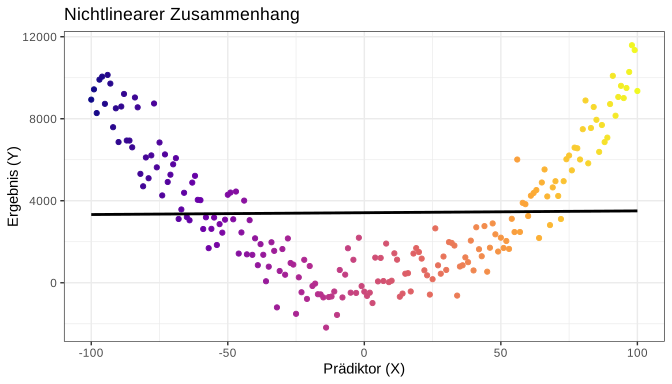
Beachten Sie, dass die Beziehung zwischen und linear sein muss, damit das lineare Modell verwendet werden kann. Ist der Zusammenhang nicht linear, kann das lineare Modell irreführend sein. Im Folgenden ein Beispiel für einen nichtlinearen Zusammenhang zwischen und . Die berechnete Regressionsgerade erfasst den Zusammenhang zwischen und nicht.
Wir fahren fort, indem wir in R ein lineares Regressionsmodell erstellen. Dies geschieht mit der Funktion lm(), die in Base R enthalten ist (Sie müssen kein Package installieren).
modell <- lm(glucose ~ mass, data=PimaIndiansDiabetes)

summary(modell)Call:
lm(formula = glucose ~ mass, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-128.970 -20.756 -3.705 19.509 81.568
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 92.2129 4.7083 19.585 < 0.0000000000000002 ***
mass 0.8965 0.1429 6.274 0.000000000589 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.2 on 766 degrees of freedom
Multiple R-squared: 0.04887, Adjusted R-squared: 0.04763
F-statistic: 39.36 on 1 and 766 DF, p-value: 0.0000000005891Aus dem obigen Ergebnis geht Folgendes hervor:
- Der Achsenabschnitt beträgt 92,2, das heißt, die Regressionsgerade schneidet die Y-Achse bei Y=92,2, was mit der grafischen Untersuchung übereinzustimmen scheint.
- , also der Koeffizient für mass, beträgt 0,8965. Das bedeutet: Steigt
massum 1 Einheit, steigtglucoseum 0,8965 Einheiten.
Berechnung der Regressionsgeraden
Grundlegend für die Regressionsanalyse ist die Berechnung der Regressionsgeraden. Die gebräuchlichste Methode ist die least-squares method (auf Deutsch Methode der kleinsten Quadrate). Least-Squares wird auch als ordinary least-squares bezeichnet. Die Methode erzeugt eine Gerade, die die Summe der Fehler (error) minimiert. In der folgenden Abbildung wurden dieselben Daten wie oben (die Pima-Indianer) im Intervall 50 bis 150 auf der x-Achse und der y-Achse vergrößert, um zu verdeutlichen, was Quadratsummen sind. In der folgenden Abbildung ist außerdem eine Regressionsgerade zu sehen.
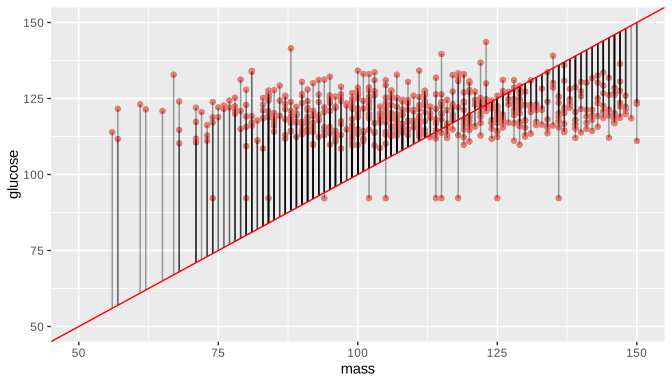
Least-Squares zielt darauf ab, eine Regressionsgerade zu erstellen, die die Summe der Fehler aller Beobachtungen minimiert. In der obigen Abbildung ist zu erkennen, dass der Abstand der Regressionsgeraden zu den Punkten stark variiert. Im Intervall 100 bis 140 auf der x-Achse liegt die Gerade nahe an den Punkten (der Fehler ist klein), außerhalb dieses Intervalls ist die Gerade weiter von den Punkten entfernt (der Fehler ist größer). Die Methode der Quadratsummen besteht darin, den gesamten (totalen) Fehler zu minimieren. Die Gerade wird hin und her gekippt, bis die Steigung die Summe aller Fehler minimiert. Bevor alle Fehler addiert werden, werden sie quadriert; damit sollen alle negativen Fehler (die der Punkte unterhalb der Geraden) zu positiven Werten werden. Die Summe aller quadrierten Fehler wird RSS (Residual Sum of Squares) genannt. Die Aufgabe des linearen Modells besteht somit darin, und zu finden, die RSS minimieren. Die Formel für RSS lautet:
Bestimmtheitsmaß (coefficient of determination): R2
Um die Stärke des Zusammenhangs zwischen und zu schätzen, kann man den coefficient of determination (Bestimmtheitsmaß) verwenden, auch genannt. Dieser Wert reicht von 0 bis 1. Ist gleich 0, besteht kein Zusammenhang, und ist gleich 1, besteht ein perfekter Zusammenhang, das heißt, kann die gesamte Variation von erklären.
Annahmen der Regression mit der Least-Squares-Methode
Die folgenden Annahmen sind erforderlich, damit Least-Squares angewendet werden kann:
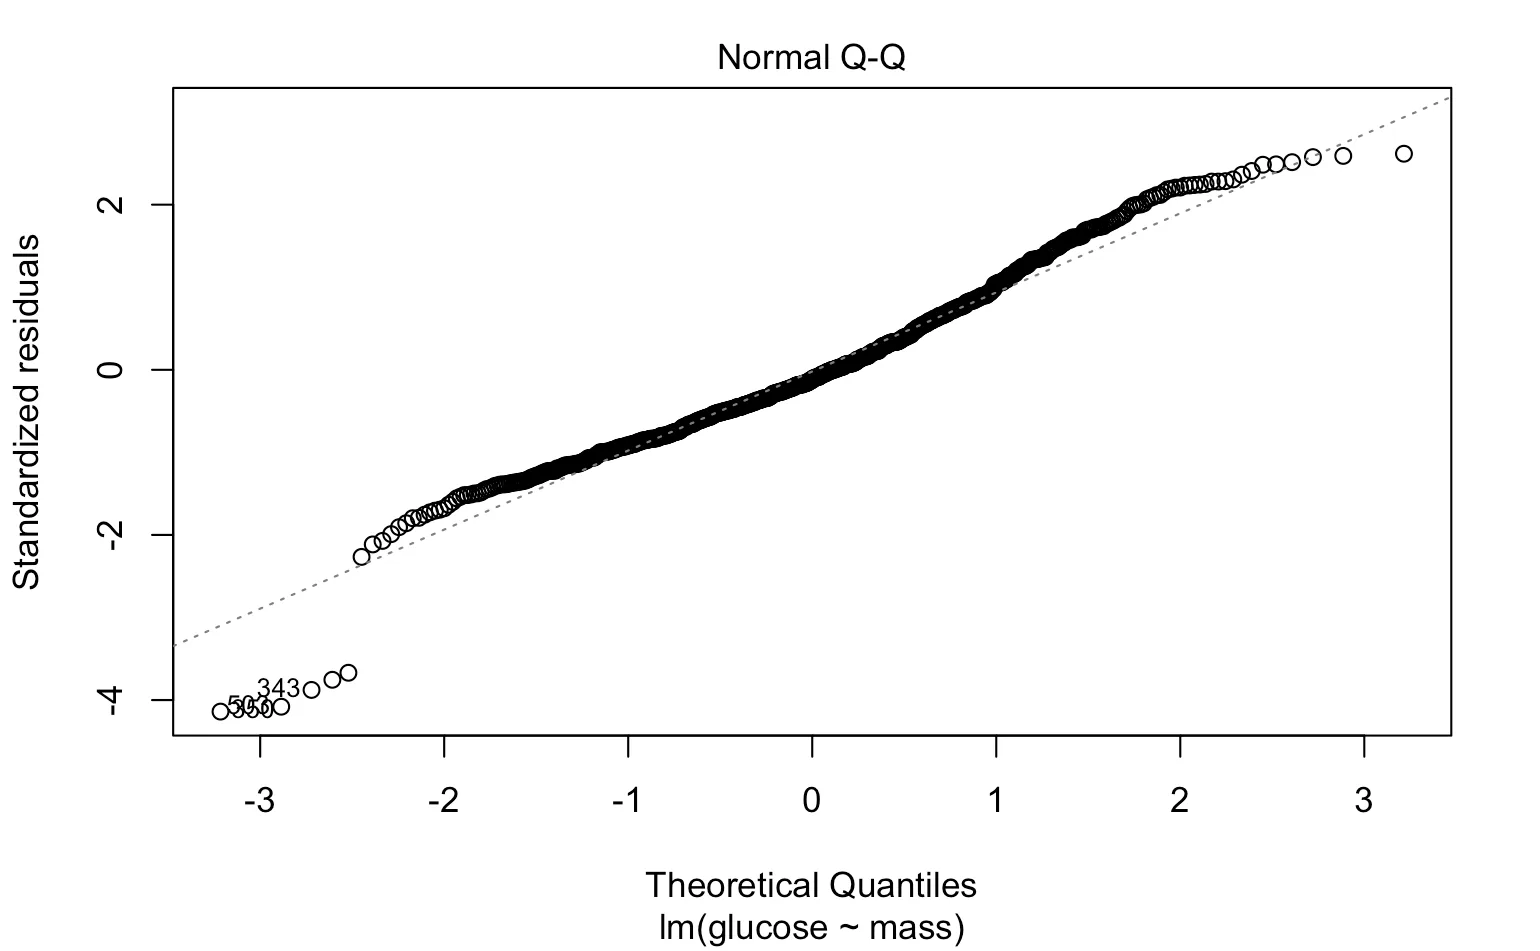
- Die Residuen müssen mit dem Mittelwert 0 normalverteilt sein. Dies lässt sich mit einem sogenannten Quantil-Quantil-Plot überprüfen. Im Quantil-Quantil-Plot sollte eine gerade Linie zu sehen sein, wenn die Annahme erfüllt ist.
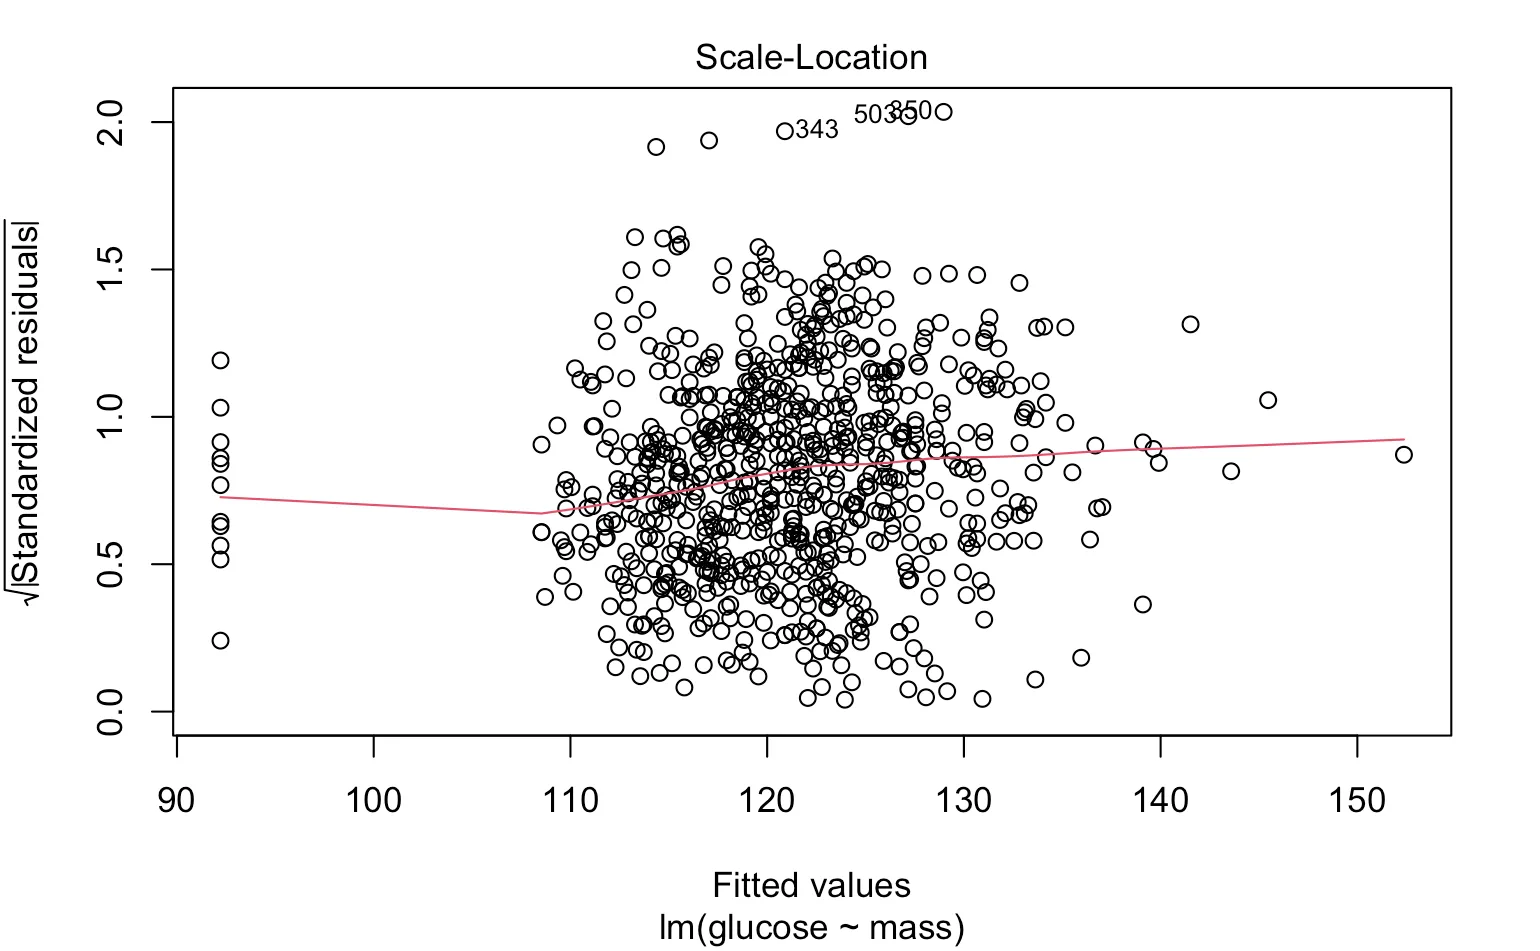
- Die Residuen müssen eine konstante Varianz aufweisen. Dies lässt sich mit einem Streudiagramm der geschätzten Residuen gegen die Fitted Values überprüfen. Das Streudiagramm sollte eine Punktwolke ohne Zusammenhang zwischen den Werten zeigen.
- Die Residuen müssen voneinander unabhängig sein. Dies ist selten ein Problem, es sei denn, dieselbe Person/Zelle/Bakterie/Einheit/usw. ist mehrmals in der Studienpopulation enthalten. Ist dieselbe Person mehrmals in der Studienpopulation enthalten (beispielsweise durch wiederholte Messungen von BMI und Glukose), sind die Residuen dieser Beobachtungen voneinander abhängig.
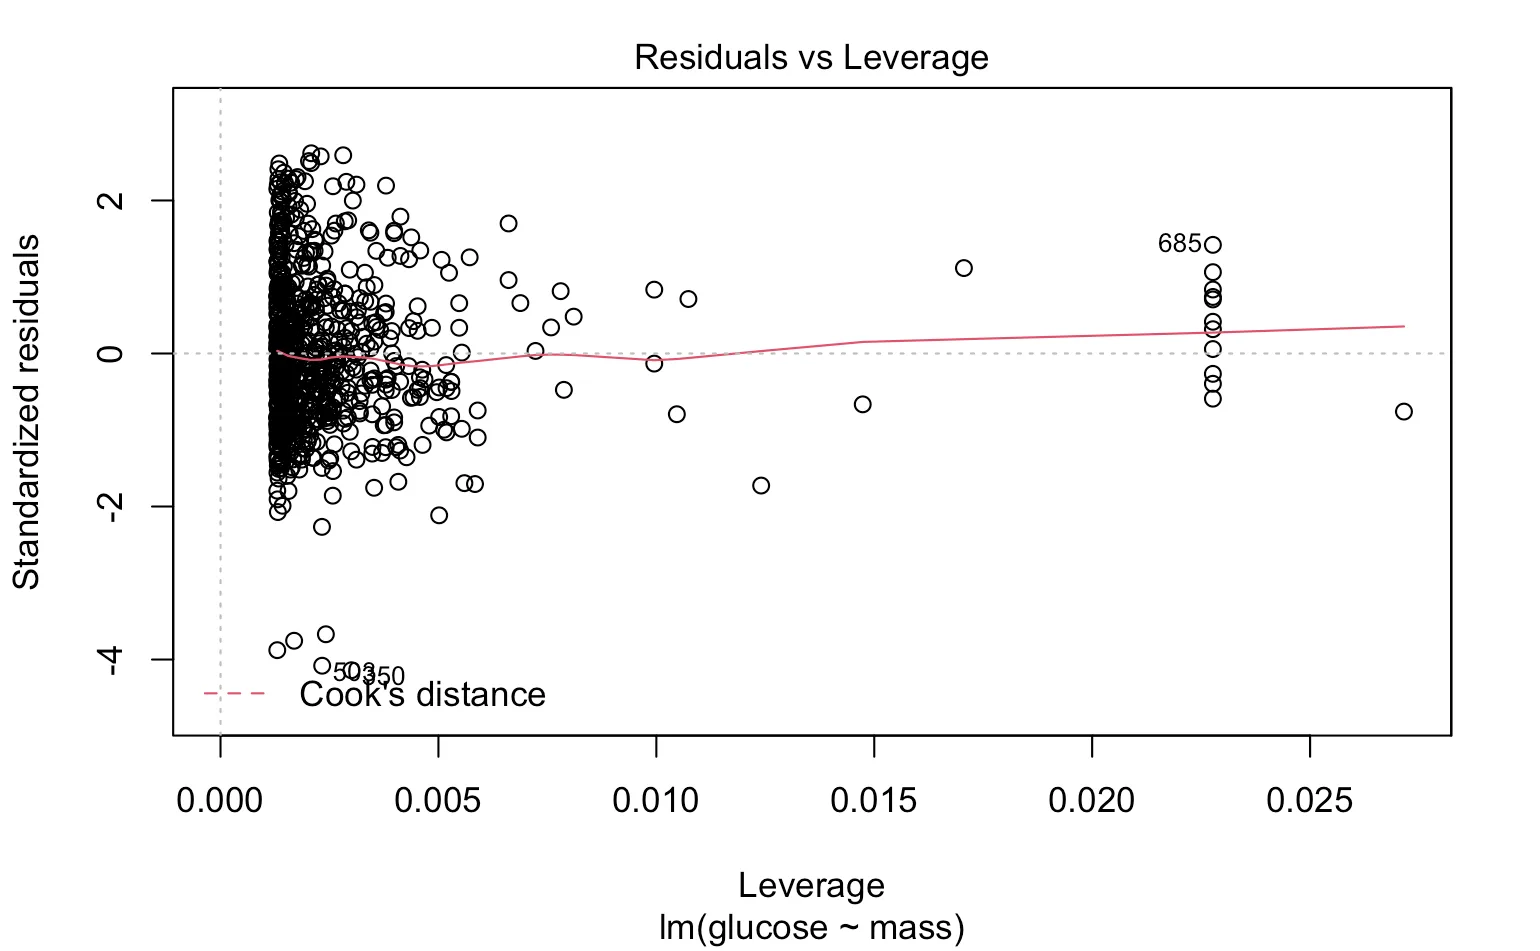
Punkt (1) und (2) lassen sich in R einfach mit folgendem Befehl untersuchen, der alle erforderlichen Grafiken ausgibt:
plot(modell)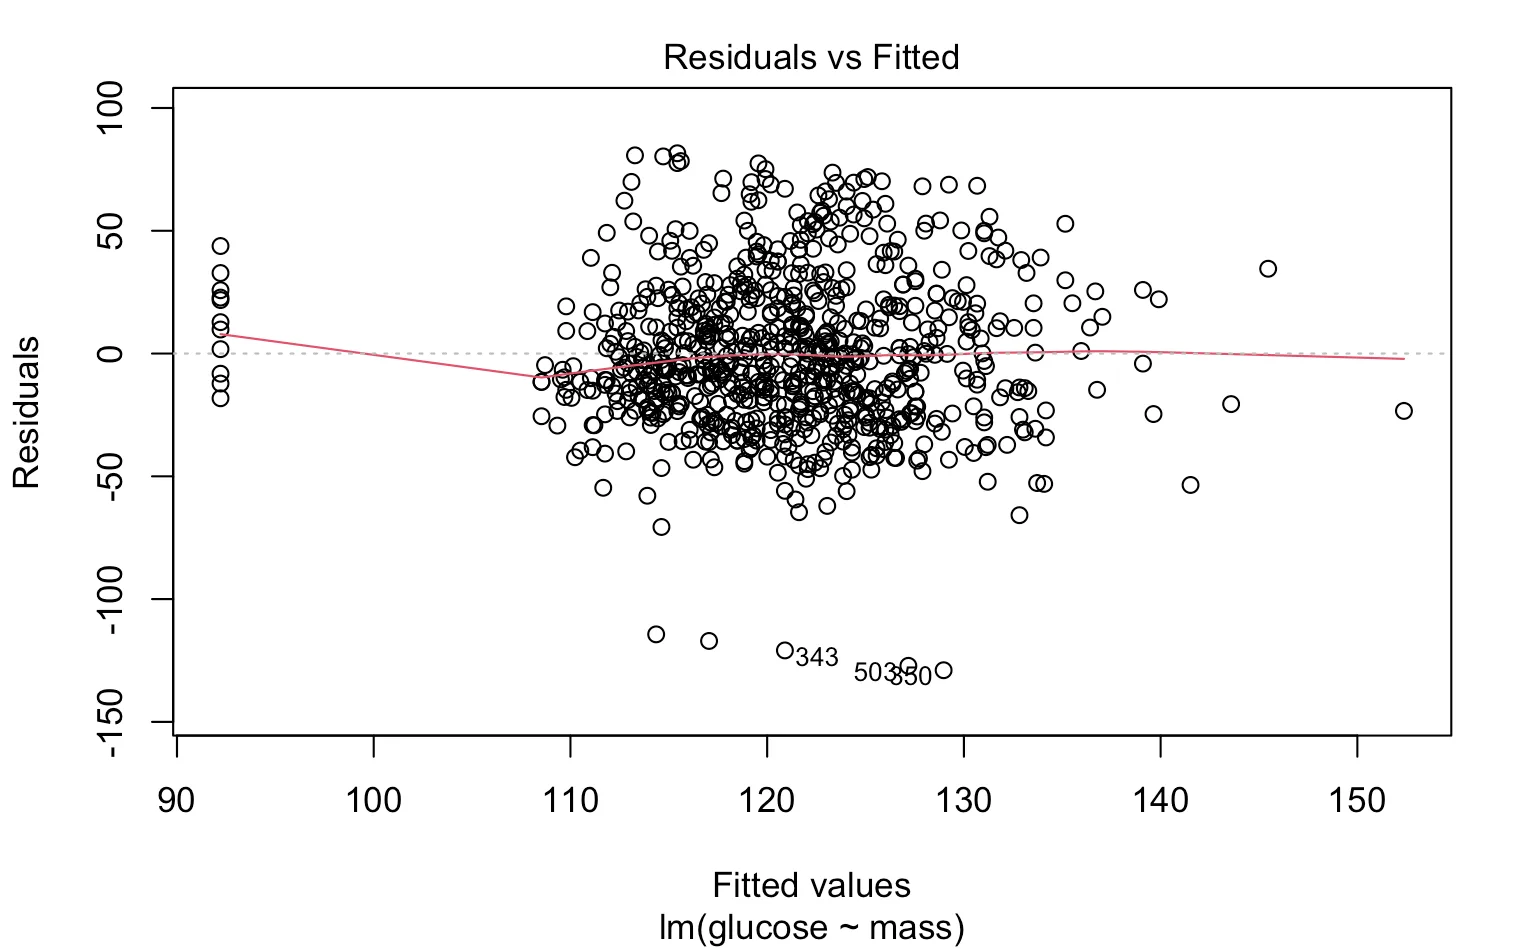
Vorhersage mit der Regression
Das Regressionsmodell kann zur Vorhersage verwendet werden. Das bedeutet, dass wir den Wert von Y für einen gegebenen Wert von X schätzen können. Es kann beispielsweise von Interesse sein vorherzusagen, wie hoch glucose bei einem gegebenen Wert von mass sein wird. Dazu erstellen wir nun ein neues Modell mit der Spezifikation glucose ~ ., was bedeutet, dass wir glucose gegen alle anderen Variablen modellieren. Anschließend verwenden wir predict() mit dem Modellobjekt (modell_2) und geben an, an welchen Daten wir das Modell testen wollen. In diesem Fall testen wir an denselben Daten, mit denen wir das Modell trainiert haben, was nicht empfohlen wird. Den vorhergesagten Wert speichern wir als neue Spalte (Predicted_Glucose) im selben Data Frame. Ganz zum Schluss geben wir die ersten 10 Zeilen mit beobachteten und vorhergesagten Werten aus.
modell_2 <- lm(glucose ~ ., data=PimaIndiansDiabetes)

PimaIndiansDiabetes$Predicted_Glucose <- predict(modell_2, newdata=PimaIndiansDiabetes)

select(PimaIndiansDiabetes, glucose, Predicted_Glucose) %>%
  slice(1:10)
glucose Predicted_Glucose
1 148 134.03797
2 85 100.53489
3 183 130.46052
4 89 106.04599
5 137 145.69693
6 116 106.94069
7 78 128.57557
8 115 98.26398
9 197 181.40914
10 125 136.97599Multiple Regression
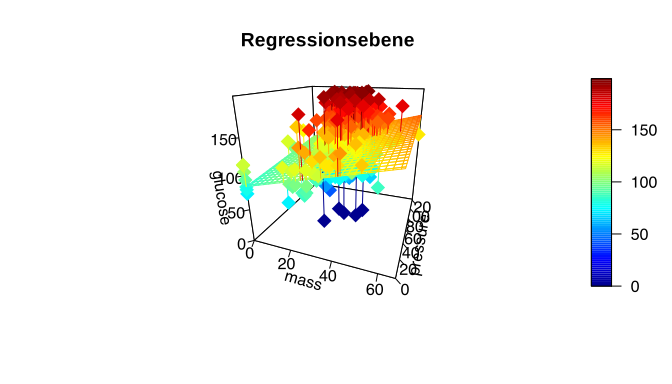
Wenn wir untersuchen wollen, wie der BMI (mass) mit der Glukose (glucose) kovariiert, und dabei auch das Alter berücksichtigen möchten, verwenden wir die multiple Regression. Die multiple Regression ist schlicht als Regression mit mindestens 2 Prädiktoren definiert. Die multiple Regression folgt denselben Prinzipien wie die bisher besprochene lineare Regression. Die Least-Squares-Methode wird wie gewohnt angewendet, in diesem Fall wird jedoch keine Regressionsgerade, sondern eine Regressionsebene durch die Datenpunkte gelegt. Diese Ebene hat ein dreidimensionales Erscheinungsbild, das unten anhand derselben Daten veranschaulicht wird. Der zweite Prädiktor ist pressure (Blutdruck).
Der Code für das Regressionsmodell lautet:
modell_2 <- lm(glucose ~ mass + pressure, data=PimaIndiansDiabetes)
summary(modell_2)Call:
lm(formula = glucose ~ mass + pressure, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-129.725 -20.893 -3.277 19.206 80.092
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 84.60294 5.48135 15.435 < 0.0000000000000002 ***
mass 0.78442 0.14834 5.288 0.000000161 ***
pressure 0.16201 0.06042 2.681 0.00749 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.08 on 765 degrees of freedom
Multiple R-squared: 0.05773, Adjusted R-squared: 0.05526
F-statistic: 23.43 on 2 and 765 DF, p-value: 0.0000000001326Die Koeffizienten werden wie folgt interpretiert.
- Steigt
massum 1 Einheit, nimmtglucoseum 0,78442 Einheiten zu. Dieser Effekt ist für pressure adjustiert. - Steigt
pressureum 1 Einheit, nimmtglucoseum 0,16201 Einheiten zu. Dieser Effekt ist fürmassadjustiert.