
Regression
In jeder Forschung und Analyse ist es sehr üblich, Informationen über mehrere Variablen zu erheben, um die Zusammenhänge zwischen ihnen zu untersuchen. Dazu können sozioökonomische Daten (Einkommen, Bildung, ethnische Zugehörigkeit usw.), anthropometrische Daten (Gewicht, Körpergröße, BMI usw.), die Krankheitsvorgeschichte (Vorliegen von Diabetes, rheumatischen Erkrankungen, Lungenerkrankungen, Krebs usw.), Biomarker (Cholesterin, CRP, Tumormarker usw.) und andere Messwerte (Blutdruck, Alter usw.) gehören. Wer den Zusammenhang zwischen diesen Variablen untersuchen möchte, findet in der Regression ein leistungsfähiges Werkzeug. Die Regression erlaubt uns Folgendes:
- Untersuchung der Beziehung (Assoziation) zwischen einer abhängigen Variablen () und einer oder mehreren unabhängigen Variablen (Prädiktoren, ).
- Untersuchung der Stärke der Beziehung (Assoziation) zwischen jedem einzelnen Prädiktor () und der abhängigen Variablen ().
- Erstellung eines Vorhersagemodells, das zur Prädiktion verwendet werden kann, das heißt, wir können auf Grundlage der Information über den Wert von vorhersagen.
In einer Regressionsanalyse wird eine Variable () durch mindestens einen Prädiktor () vorhergesagt. Terminologisch sagt man, sei von abhängig; ist daher die abhängige Variable und die unabhängige Variable.
| Aufgabe im Modell | Synonym | |
|---|---|---|
| Y | Die Variable, die vorhergesagt werden soll | Abhängige Variable, dependent variable, outcome, Endpunkt, Zielgröße, label, target |
| X | Wird zur Vorhersage von Y verwendet | Prädiktor, predictor, feature, Kovariate, covariate |
Prädiktion vs. Effektschätzung
Wie oben erwähnt, kann die Regression dazu dienen, die Beziehung zwischen Variablen zu untersuchen, die Stärke der Zusammenhänge zu analysieren und/oder Vorhersagen zu treffen. In der Praxis bedeutet das, dass wir entweder untersuchen, wie ein oder mehrere Prädiktoren mit der Zielgröße assoziiert sind, oder dass wir ein Vorhersagemodell erstellen, um einen Wert oder ein Ereignis () vorhersagen zu können. Man sollte Regressionsmodelle, die auf Prädiktion abzielen (also Vorhersagen treffen sollen), von Modellen unterscheiden, die auf Effektschätzung abzielen (also Stärke und Form der Zusammenhänge untersuchen sollen).
Prädiktion: Angenommen, wir haben Daten von 10000 Personen erhoben und diese über mehrere Jahre nachbeobachtet, um das Auftreten von Krebs zu untersuchen. Für jede Person haben wir unter anderem Angaben zu Alter, Geschlecht, Beruf, sozioökonomischem Status, Rauchen, Erkrankungen, Arzneimittelgebrauch und Wohnsituation erhoben. Wenn das Ziel darin besteht, vorherzusagen, welche Personen an Lungenkrebs erkranken werden, dann dient die Regressionsanalyse der Prädiktion.
Effektschätzung: Angenommen, wir haben Daten von 10000 Personen erhoben und diese über mehrere Jahre nachbeobachtet, um das Auftreten von Lungenkrebs zu untersuchen. Für jede Person haben wir unter anderem Angaben zu Alter, Geschlecht, Beruf, sozioökonomischem Status, Rauchen, Erkrankungen, Arzneimittelgebrauch und Wohnsituation erhoben. Wenn unser Ziel darin besteht, die Beziehung zwischen (beispielsweise) Rauchen und dem Krebsrisiko zu untersuchen, dann dient die Regressionsanalyse dazu, den Effekt eines Prädiktors (Rauchen) zu schätzen. Dabei ist es wichtig, dass der Zusammenhang zwischen Rauchen und Krebs nicht durch andere Faktoren verzerrt wird. Es kann beispielsweise sein, dass Raucher tendenziell einen niedrigeren sozioökonomischen Status haben, der ebenfalls das Krebsrisiko beeinflusst. Es wäre daher wünschenswert, den sozioökonomischen Status zu berücksichtigen (mit anderen Worten: für ihn zu adjustieren). Dies lässt sich erreichen, indem man den sozioökonomischen Status als Prädiktor in das Modell aufnimmt. Bei der Konstruktion von Regressionsmodellen zur Effektschätzung ist es wichtig, Confounder dieser Art zu berücksichtigen (siehe Kapitel Kausale Inferenz).
Einfache lineare Regression: eine abhängige Variable und ein Prädiktor
Dies ist eine kurze Wiederholung des Kapitels Lineare Regression.
Die gewöhnliche Regressionsgleichung sieht wie folgt aus:
- ist der Achsenabschnitt (Intercept), also der Punkt, an dem die Regressionsgerade die Y-Achse schneidet (siehe Abbildung oben).
- ist der Koeffizient für
mass, das heißt der Wert der Steigung der Regressionsgeraden. - ist die Differenz zwischen dem vom Modell vorhergesagten Wert von und dem beobachteten Wert von . Dies ist also der Fehler des Modells (error).
Die folgende Abbildung zeigt den Zusammenhang zwischen dem Prädiktor mass (Körpergewicht) und der Zielgröße glucose (Blutzucker).
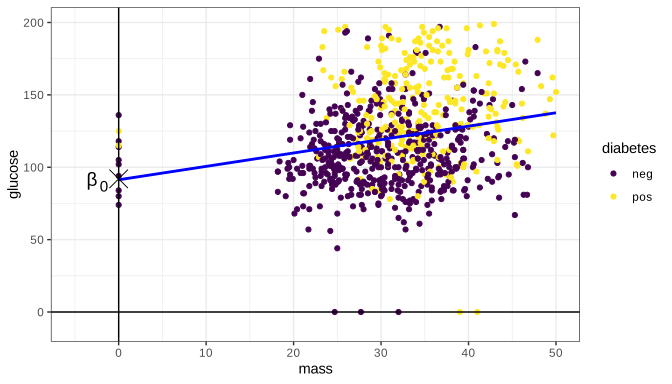
Die obige Regressionsgerade zeigt einen positiven Zusammenhang zwischen und : Wenn zunimmt, nimmt auch zu. Der visuelle Eindruck der obigen Abbildung ist somit, dass zur Vorhersage von verwendet werden kann. Wir können die Gleichung der linearen Regression nun mit den Variablen mass und glucose umschreiben:
Wenn wir den Zusammenhang zwischen mass und glucose adjustiert für das Alter analysieren möchten, ist eine multiple Regression erforderlich. Die multiple Regression dient also dazu, den Zusammenhang zwischen mindestens zwei Prädiktoren und einer Zielgröße zu untersuchen.
Multiple Regression
<!-- video: https://science.nu/wp-content/uploads/Regressionsplan.mp4 -->
Die multiple Regression ist ein Modell mit mehreren, mindestens 2, Prädiktoren. Die mathematische Formel der multiplen Regression mit zwei Prädiktoren sieht wie folgt aus:
Dieser Zusammenhang lässt sich nicht mehr mit einer geraden Regressionslinie darstellen. Der Zusammenhang zwischen und den Prädiktoren und bildet nun eine dreidimensionale Regressionsebene, wie sie in der obigen Abbildung veranschaulicht wird.
Statistische Signifikanz: Ist der Zusammenhang zwischen X und Y statistisch signifikant?
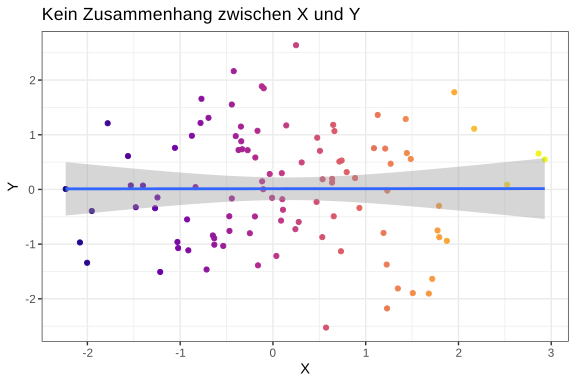
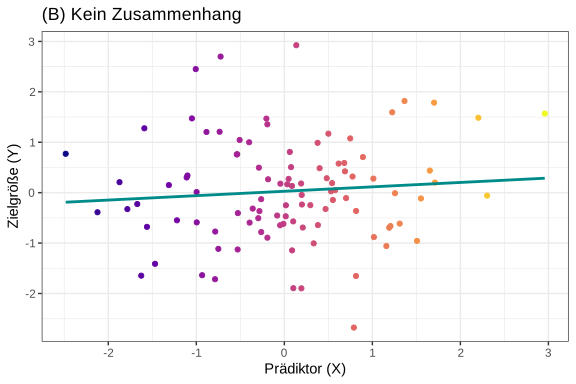
Eine zentrale Frage ist, ob der Zusammenhang zwischen und statistisch signifikant ist. Diese Frage lässt sich teilweise durch eine visuelle Beurteilung des grafischen Zusammenhangs beantworten. Visuelle Beurteilungen sind jedoch subjektiv, und zudem ist es schwierig, dreidimensionale Regressionsebenen (oder Regressionsebenen mit noch mehr Dimensionen ) zu beurteilen. Es bedarf eines formalen Maßes dafür, ob der Zusammenhang zwischen und signifikant ist. Dies geschieht im Rahmen des Hypothesentests, also durch das Aufstellen einer Nullhypothese. In diesem Zusammenhang lautet die Nullhypothese, dass kein Zusammenhang zwischen und besteht, das heißt, die Steigung (der Koeffizient) des Prädiktors ist gleich 0. Ist die Steigung 0, so besteht kein Zusammenhang zwischen und . Ein solcher Zusammenhang ist in der folgenden Abbildung dargestellt.
Signifikanztest mit dem t-Test (t-statistic)
Um zu prüfen, ob ein statistisch signifikanter Zusammenhang zwischen und besteht, müssen wir die Nullhypothese testen. Die Nullhypothese besagt, dass der Koeffizient des Prädiktors keine Steigung aufweist, das heißt, der Wert von ändert sich nicht, wenn X zu- oder abnimmt. Die Aufgabe besteht darin, die Wahrscheinlichkeit dafür zu berechnen, dass die Nullhypothese zutrifft. Liegt diese Wahrscheinlichkeit unter 5 % (p<0,05), verwerfen wir die Nullhypothese und sagen damit, dass ein Zusammenhang besteht, also ein statistisch signifikanter Prädiktor ist.
Die Nullhypothese kann mit einem t-Test geprüft werden. Der berechnete Wert heißt t-Statistik (t-statistic) und ergibt sich, indem man den Koeffizienten () durch seinen Standardfehler (standard error) teilt. Der so erhaltene t-Wert lässt sich anschließend in einen p-Wert übersetzen. Alle Statistikprogramme, auch R, führen diese Berechnungen automatisch durch. Wer ein Regressionsmodell erstellt, erhält also automatisch t-Tests und p-Werte für sämtliche Prädiktoren im Modell.
Als Nächstes erstellen wir ein Regressionsmodell und interpretieren die Ergebnisse im Detail.
Übungsbeispiele zur multiplen Regression
Es folgen zwei Übungen zur multiplen Regression, wobei der Schwerpunkt auf der Interpretation der Ergebnisse liegt. Die Übungen werden in R durchgeführt. Sie können den untenstehenden Code in R kopieren und dieselben Analysen ausführen.
Wir verwenden mehrere Packages, um die Arbeit zu erleichtern und effizienter zu gestalten. Die multiple lineare Regression ist in base R (der Standardinstallation von R) enthalten. Die Funktion heißt lm(). Darüber hinaus benötigen wir die Packages sjPlot, broom und tidyverse, um die Ergebnisse zu extrahieren und darzustellen. Wir verwenden den Datensatz PimaIndiansDiabetes (aus dem Package mlbench), der Informationen über Pima-Indianer enthält, die ein hohes Diabetesrisiko haben. Um die Packages und die Daten zu installieren und zu laden, gibt man folgende Befehle ein:
install.packages(c("sjPlot", "broom", "mlbench"))
library(sjPlot)
library(broom)
library(tidyverse)

## Daten zu Pima-Indianern
library(mlbench)
data("PimaIndiansDiabetes")

## Daten in ein Objekt mit kürzerem Namen kopieren
pima <- PimaIndiansDiabetes

## Die ersten 5 Zeilen ansehen
head(pima, 5)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
6 148 72 35 0 33.6 0.627 50 pos
1 85 66 29 0 26.6 0.351 31 neg
8 183 64 0 0 23.3 0.672 32 pos
1 89 66 23 94 28.1 0.167 21 neg
0 137 40 35 168 43.1 2.288 33 posIm nächsten Schritt erstellen wir ein Regressionsmodell. Dazu dient die Funktion lm() (linear model), die verwendet wird, wenn die abhängige Variable stetig ist. In diesem Fall ist die abhängige Variable (die Zielgröße, Y) der Blutzucker (glucose).
Bei der Funktion lm() wird das Zeichen ~ verwendet, um das Modell zu spezifizieren. Links von ~ steht die abhängige Variable (glucose), rechts davon werden alle Prädiktoren, getrennt durch +, angegeben. Das Ergebnis speichern wir im Objekt my_model. Anschließend führen wir das Objekt aus, um das Ergebnis zu sehen.
my_model <- lm(glucose ~ mass + age + insulin + pressure, data=pima)
my_modelCall:
lm(formula = glucose ~ mass + age + insulin + pressure, data = pima)
Coefficients:
(Intercept) mass age insulin pressure
68.89351 0.58340 0.72475 0.08665 0.03373Oben sehen wir unter der Überschrift Call die Spezifikation des Modells. Unter der Überschrift Coefficients sehen wir die Koeffizienten. Das war also eine recht spärliche Darstellung des Modells. Wenden wir stattdessen die Funktion summary() auf das Objekt an.
summary(my_model)Call:
lm(formula = glucose ~ mass + age + insulin + pressure, data = pima)
Residuals:
Min 1Q Median 3Q Max
-123.65 -17.78 -2.50 16.23 86.57
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 68.893507 5.491146 12.546 < 2e-16 ***
mass 0.583397 0.138432 4.214 2.81e-05 ***
age 0.724746 0.090398 8.017 4.06e-15 ***
insulin 0.086647 0.009137 9.483 < 2e-16 ***
pressure 0.033732 0.057169 0.590 0.555
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 28.52 on 763 degrees of freedom
Multiple R-squared: 0.2087, Adjusted R-squared: 0.2045
F-statistic: 50.3 on 4 and 763 DF, p-value: < 2.2e-16Damit erhalten wir mehr Informationen über das Modell. Für jeden Prädiktor werden nun der Koeffizient (Estimate), der Standardfehler (Std. Error), die t-Statistik (t value) und der p-Wert (Pr(>|t|)) angegeben. Die Ergebnisse werden wie folgt interpretiert:
- (Intercept): Der Achsenabschnitt interessiert uns nicht. Nur äußerst selten ist der Achsenabschnitt von Interesse. Er gibt an, welchen Y-Wert (glucose) man erhält, wenn alle X-Werte 0 sind, und das ist biologisch nicht sinnvoll (zum Beispiel wiegt kein Mensch 0 Kilogramm). Der Achsenabschnitt wird trotzdem immer ausgewiesen.
- Die Prädiktoren:
- mass: Steigt mass um 1 Einheit, so steigt glucose um 0,583397 Einheiten.
- age: Steigt age um 1 Einheit, so steigt glucose um 0,724746 Einheiten.
- Ebenso sind auch die übrigen Prädiktoren positiv mit glucose assoziiert, da alle Koeffizienten positiv sind.
- Alle Prädiktoren außer pressure haben signifikante p-Werte (p<0,05). Das bedeutet, dass der Zusammenhang zwischen pressure und glucose nicht statistisch signifikant ist.
- Die Assoziation jedes Prädiktors ist für alle anderen Prädiktoren adjustiert. Das bedeutet, dass jeder Koeffizient zeigt, wie der Prädiktor glucose beeinflusst, wenn die übrigen Prädiktoren konstant gehalten werden.
- R2 und Adjusted R2: R2 ist die Erklärungskraft des Modells. In diesem Fall beträgt R2 0,2087, das heißt, das Modell erklärt 20,87 % der gesamten Variation von glucose.
Es gibt weitere Funktionen und Packages, mit denen sich die Ergebnisse des Modells extrahieren und darstellen lassen. Wir beginnen mit dem Package sjPlot, das mehrere nützliche Funktionen für diesen Zweck bietet. Mit tab_model() werden die Ergebnisse des Modells in einer Tabelle dargestellt:
library(sjPlot)
tab_model(my_model)| Predictor | Estimates | 95% CI | P value |
|---|---|---|---|
| (Intercept) | 68.89 | 58.11 – 79.67 | <0.001 |
| mass | 0.58 | 0.31 – 0.86 | <0.001 |
| age | 0.72 | 0.55 – 0.90 | <0.001 |
| insulin | 0.09 | 0.07 – 0.10 | <0.001 |
| pressure | 0.03 | -0.08 – 0.15 | 0.555 |
| Observations | 768 | ||
| R2 / R2 adjusted | 0.209 / 0.205 |
In den obigen Ergebnissen wird außerdem ein Konfidenzintervall angegeben, das anzeigt, in welchem Intervall der wahre Koeffizient mit 95 % Wahrscheinlichkeit liegt. Mit 95 % Wahrscheinlichkeit liegt der Koeffizient für mass zwischen 0,31 und 0,86. Beachten Sie, dass dieses Intervall die 0 (null) nicht einschließt, was bedeutet, dass wir mit 95 % Sicherheit sagen können, dass eine Zunahme von mass zu einer Zunahme der Glukose führt. Dies steht im Einklang mit dem p-Wert, der <0,001 beträgt. Der Zusammenhang zwischen mass und Glukose ist somit statistisch signifikant. Dieser Effekt von mass ist für den Effekt der übrigen Prädiktoren (Kovariaten) im Modell adjustiert.
Der Koeffizient für mass gibt an, wie groß der Effekt einer Zunahme von mass um 1 Einheit auf glucose ist, wenn alle anderen Prädiktoren (Kovariaten) konstant gehalten werden. Dasselbe Prinzip gilt für die übrigen Prädiktoren.
Beachten Sie die Zeile Observations in der Tabelle. Sie gibt an, wie viele Beobachtungen in das Regressionsmodell eingingen. Denken Sie daran: Fehlt bei einer Beobachtung die Angabe (also liegt ein „missing“ vor) zu einem der Prädiktoren im Modell, so wird diese Beobachtung aus dem gesamten Modell ausgeschlossen. Fehlt zum Beispiel bei einer Beobachtung die Angabe zu mass, während für alle übrigen Variablen Werte vorliegen, so wird diese Person aus dem Modell ausgeschlossen, und wir verlieren eine Beobachtung.
Mit der Funktion plot_model() erhalten wir eine grafische Darstellung der Ergebnisse. Die Funktion bietet eine Vielzahl von Argumenten, mit denen Sie die Grafik anpassen können.
plot_model(my_model, show.values = T)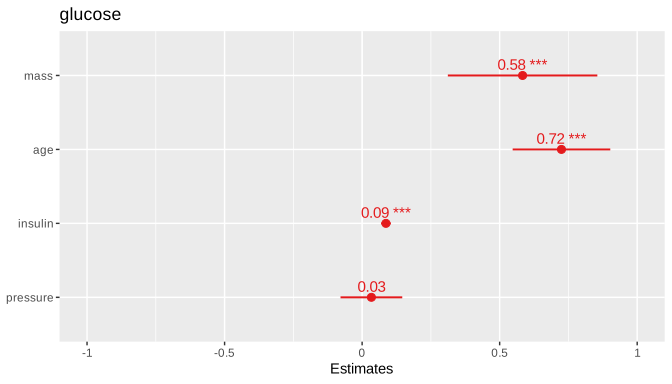
Linearität (Linearity)
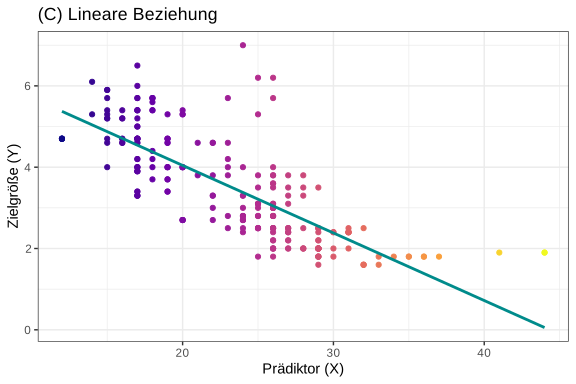
Die Anwendung der linearen Regression setzt voraus, dass jeder Prädiktor linear mit Y assoziiert ist. Die folgende Abbildung zeigt eine lineare Regressionsgerade durch (A) Daten mit nichtlinearem Zusammenhang, (B) Daten ohne Zusammenhang und (C) Daten mit linearem Zusammenhang. Im Fall (A) gelingt es dem linearen Modell nicht, einen vorhandenen Zusammenhang abzubilden. Im Fall (B) gibt es keinen nennenswerten Zusammenhang, der abgebildet werden könnte.
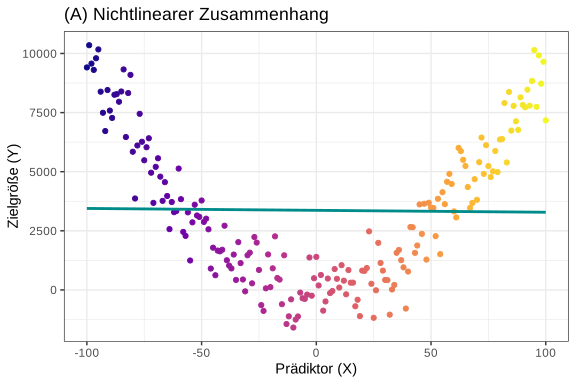
Eine Logarithmierung von X hilft nicht, den Zusammenhang im Fall (A) abzubilden, auch wenn eine Logarithmierung nichtlineare Zusammenhänge linearer machen kann. Um den Zusammenhang im Fall (A) abzubilden, ist eine flexiblere Kurve erforderlich. Methoden zum Umgang mit Nichtlinearität wurden im Kapitel Umgang mit stetigen Variablen besprochen.
Modellspezifikation: das Modell korrekt spezifizieren
Ist ein Regressionsmodell falsch spezifiziert, sind die Koeffizienten nicht verlässlich. Das Weglassen wichtiger Kovariaten oder von Interaktionen zwischen Variablen sowie das Ignorieren nichtlinearer Zusammenhänge sind häufige Ursachen für eine Fehlspezifikation des Modells. Dies kann dazu führen, dass der Effekt eines oder mehrerer Prädiktoren überschätzt, unterschätzt oder fehlinterpretiert wird. Eine Interaktion bedeutet, dass zwei (oder mehr) Prädiktoren in der Weise miteinander interagieren, dass der Effekt des einen Prädiktors vom anderen Prädiktor abhängt.
Interaktionen
Angenommen, Arzneimittel X wird zur Behandlung von Kopfschmerzen eingesetzt. Das Arzneimittel wirkt nur bei Frauen, weil die Substanz durch ein Enzym aktiviert wird, das in den Brustdrüsen vorkommt. Die Wirkung des Arzneimittels hängt also vom Geschlecht ab. Es besteht somit eine Interaktion zwischen der Wirkung des Arzneimittels und dem Geschlecht. Wird diese Interaktion nicht berücksichtigt, führt dies zu einem fehlerhaften Modell. Das fehlerhafte Modell wird wie folgt spezifiziert.
Das Modell ist fehlerhaft, weil es Geschlecht und Arzneimittel als zwei getrennte Parameter (Prädiktoren) behandelt. Das korrekte Modell wird mit der Interaktion zwischen Arzneimittel und Geschlecht spezifiziert. Die Interaktion bedeutet, dass man Arzneimittel mit Geschlecht multipliziert (mathematisch heißt das, dass die Kombination jeder Ausprägung des Geschlechts mit jeder Ausprägung des Arzneimittels als Prädiktor eingeführt wird):
Um zu beurteilen, ob die Interaktion signifikant ist, betrachtet man den p-Wert des Interaktionsterms. Jede Statistiksoftware (auch R) gibt für Interaktionsterme einen p-Wert (und ein 95-%-Konfidenzintervall) aus. Ist der Interaktionsterm signifikant (p < 0,05), so ist dies ein Beleg dafür, dass eine Interaktion zwischen den Prädiktoren besteht.
Multicollinearity (Multikollinearität)
Ziel der multiplen Regression ist es, den unabhängigen Effekt jedes einzelnen Prädiktors zu quantifizieren. Es gibt jedoch Situationen, in denen sich ein Prädiktor nicht von einem oder mehreren anderen Prädiktoren unabhängig machen lässt. Angenommen, wir untersuchen, wie der BMI (body mass indeX) den Blutzucker beeinflusst. Wir erstellen eine Regression, in der der Blutzucker die Zielgröße ist und BMI sowie Alter die Prädiktoren sind:
Nehmen wir an, der Effekt (Koeffizient) für BMI beträgt 0,5, das heißt, mit jeder Einheit, um die der BMI steigt, steigt der Blutzucker um 0,5 Einheiten. Dieser Effekt des BMI ist vom Alter unabhängig, da wir für das Alter adjustiert haben. Man kann auch sagen, dass dies der Effekt des BMI ist, wenn wir das Alter konstant halten. Würden wir eine weitere Kovariate einführen, nämlich das Gewicht, so könnte Multikollinearität auftreten. BMI und Gewicht hängen nämlich sehr stark zusammen (der BMI ist eine Funktion von Gewicht und Körpergröße), und zwar in der Weise, dass mit steigendem BMI tendenziell auch das Körpergewicht zunimmt. Man kann dann nicht behaupten, dass der Koeffizient für BMI den Effekt des BMI bei konstant gehaltenem Gewicht darstellt, da das Gewicht mit größter Wahrscheinlichkeit ebenfalls zunimmt, wenn der BMI steigt. Dies ist ein Beispiel für Multikollinearität, also den Fall, dass zwei oder mehr Prädiktoren stark miteinander korreliert sind.
Diese Art der Korrelation zwischen Prädiktoren verschlechtert die Präzision der Koeffizienten. Sie bedeutet außerdem, dass wir mehr Information als nötig verwenden. Wenn die im BMI enthaltene Information auch im Gewicht steckt und umgekehrt, genügt es, einen dieser Prädiktoren in das Modell aufzunehmen.
Das Risiko für Multikollinearität ist hoch, wenn die Korrelation (siehe Kapitel Korrelation) zwischen zwei Prädiktoren 0,9 oder höher beträgt. Multikollinearität kann jedoch auch bei geringeren Korrelationsgraden zum Problem werden. Mit dem Varianzinflationsfaktor (variance inflation factor, VIF) lässt sich Multikollinearität untersuchen.
Test auf Multikollinearität (multicolinearity)
Es gibt mehrere Maße, um auf Multikollinearität zu testen. Dies kann global für das gesamte Modell und für einzelne Prädiktoren im Modell geprüft werden. Ein gebräuchliches Maß für Multikollinearität ist der VIF (variance inflation factor). Der VIF gibt an, wie stark die Varianz eines Prädiktors infolge von Multikollinearität im Modell aufgebläht ist. Ist der VIF größer als 5, liegt Multikollinearität vor. Ist der VIF >10, sollte die Variable aus dem Modell ausgeschlossen werden.
Wir erstellen nun ein Modell mit den Daten der Pima-Indianer. Diesmal verwenden wir alle Variablen im Datensatz, um den Blutzucker (glucose) vorherzusagen. Wir laden das Package mlbench, um die Daten zu den Pima-Indianern einzulesen.
library(mlbench)
data("PimaIndiansDiabetes")
my_model <- lm(glucose ~ ., data=PimaIndiansDiabetes)
Anschließend installieren wir das Package performance und verwenden die Funktion check_model(), um den VIF grafisch und in Tabellenform auszugeben:
install.packages("performance")
library(performance)

## Grafisch
check_model(my_model, check="vif")

## In Tabellenform
multicollinearity(my_model)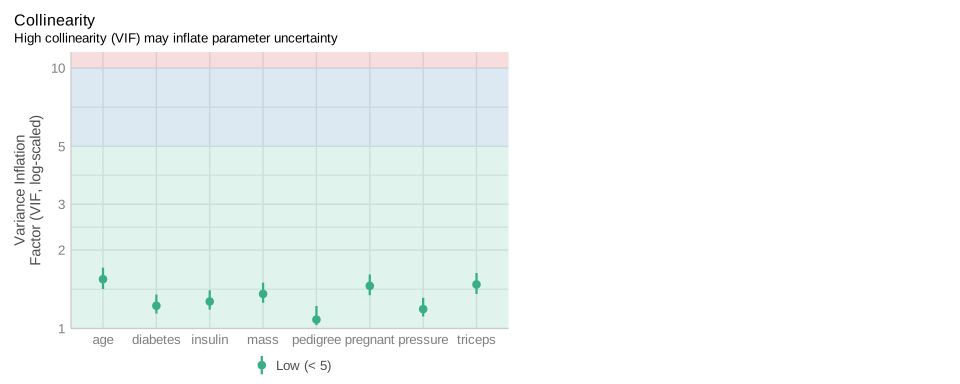
## Check for Multicollinearity

Low Correlation

     Term  VIF   VIF 95% CI Increased SE Tolerance Tolerance 95% CI
 pregnant 1.46 [1.34, 1.61]         1.21      0.69     [0.62, 0.75]
 pressure 1.19 [1.11, 1.31]         1.09      0.84     [0.76, 0.90]
  triceps 1.48 [1.36, 1.63]         1.21      0.68     [0.61, 0.74]
  insulin 1.27 [1.18, 1.40]         1.13      0.79     [0.71, 0.85]
     mass 1.36 [1.26, 1.50]         1.17      0.74     [0.67, 0.80]
 pedigree 1.08 [1.03, 1.22]         1.04      0.92     [0.82, 0.97]
      age 1.55 [1.42, 1.71]         1.24      0.65     [0.58, 0.71]
 diabetes 1.22 [1.14, 1.35]         1.11      0.82     [0.74, 0.88]
Wie oben ersichtlich, hatte kein Prädiktor einen VIF >5, sodass Kollinearität in unserem Modell kein Problem darstellt.
Kategoriale Prädiktoren (factors)
Bisher wurden ausschließlich Prädiktoren behandelt, die stetige Variablen sind. Selbstverständlich kann man auch Prädiktoren untersuchen, die kategoriale Variablen sind, etwa Geschlecht, Behandlung, Stadt, Land usw. Regressionsmodelle enthalten in der Regel sowohl stetige als auch kategoriale Prädiktoren.
Nehmen wir an, wir untersuchen, wie Alter, Gewicht und Geburtsland den Blutdruck beeinflussen. Das Modell sieht wie folgt aus:
Alter und Gewicht sind stetige Variablen. Das Geburtsland (land) ist dagegen eine kategoriale Variable mit folgenden Kategorien: (1) Schweden, (2) Nordische Länder und (3) Europa. Wenn wir das Land in das Modell aufnehmen, muss eine dieser Kategorien als Referenzkategorie dienen, und die übrigen Kategorien werden mit dieser Referenz verglichen. Interpretieren wir nun die Ergebnisse des obigen Regressionsmodells:
| Estimate | 95% CI | P values | |
|---|---|---|---|
| (Intercept) | 83.68 | 73.47 – 90.90 | <.001 |
| BMI | 0.91 | 0.76 – 1.05 | <.001 |
| Alter | 1.14 | 1.01 – 1.30 | <.001 |
| Geburtsland | |||
| Schweden | ref | ||
| Nordische Länder | 3.0 | 2.0 – 4.1 | <.001 |
| Europa | 2.1 | 1.5 – 2.7 | <.001 |
| Observations | 150 | ||
| R2 / adj. R2 | .837 / .832 |
Wir sehen, dass es Koeffizienten (Estimate) für die Nordischen Länder und Europa gibt, bei Schweden jedoch nur den Text „ref“. Das erklärt sich dadurch, dass die Kategorie Schweden die Referenzkategorie ist, mit der die Nordischen Länder und Europa verglichen werden. Die für die Nordischen Länder und Europa angegebenen Effekte beziehen sich also auf den Vergleich mit Schweden. Die Interpretation lautet dann wie folgt:
- Mit jeder Einheit, um die der BMI steigt, steigt der Blutdruck um 0,91 Einheiten, und dies ist statistisch signifikant.
- Mit jedem Jahr, das man älter wird, steigt der Blutdruck um 1,14 Einheiten, und dies ist statistisch signifikant.
- Im Vergleich zu in Schweden Geborenen haben Personen, die in den Nordischen Ländern geboren sind, einen um 3,0 Einheiten höheren Blutdruck. Dies ist statistisch signifikant (p<0,001), und der wahre Wert entspricht einem um 2,0 bis 4,1 Einheiten niedrigeren Blutdruck.
- Im Vergleich zu in Schweden Geborenen haben Personen, die in Europa geboren sind, einen um 2,1 Einheiten höheren Blutdruck. Dies ist statistisch signifikant (p<0,001), und der wahre Wert entspricht einem um 1,5 bis 2,7 Einheiten niedrigeren Blutdruck.