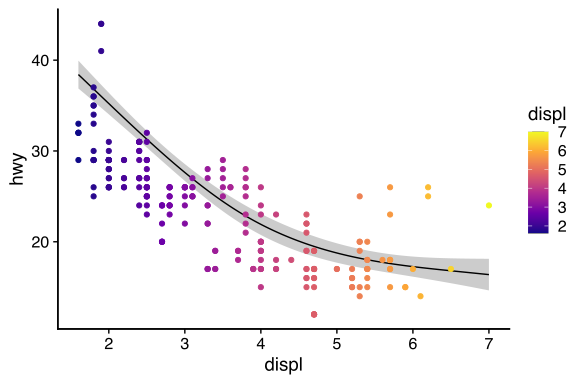
Umgang mit Prädiktoren: kategorial, kontinuierlich
Bei der Datenerhebung und bei der Entwicklung von Prädiktionsmodellen sollte man stets anstreben, kontinuierliche Variablen zu verwenden. Eine kontinuierliche Variable enthält immer (unabhängig vom Modell) mehr Information als eine kategoriale Variable, und es ist in der Regel falsch, eine kontinuierliche Variable zu kategorisieren, gleichgültig ob die Variable der Endpunkt () oder ein Prädiktor () ist. Trotzdem werden kontinuierliche Variablen häufig ohne sachliche Begründung kategorisiert.
Es gibt jedoch Situationen, in denen die Kategorisierung einer kontinuierlichen Variable gerechtfertigt ist. Angenommen, wir untersuchen, wie das Körpergewicht (kg) das Risiko beeinflusst, einen Diabetes zu entwickeln. Wir erstellen dann ein Prädiktionsmodell mit dem Körpergewicht (kg) als Prädiktor und Diabetes (ja/nein) als Endpunkt. Ist das Körpergewicht eine kontinuierliche Variable (kg), so zeigt der Regressionskoeffizient, um wie viel das Diabetesrisiko pro Kilogramm Zunahme des Körpergewichts steigt. Der Risikoanstieg, der mit einer Gewichtszunahme um 1 kg einhergeht, kann gering erscheinen und möglicherweise sogar ohne klinische Relevanz sein. Dann kann es gerechtfertigt sein, das Körpergewicht in Kategorien einzuteilen (zum Beispiel in die Kategorien Normalgewicht, Übergewicht, Adipositas). Verwendet das Prädiktionsmodell stattdessen diesen kategorisierten Prädiktor, fällt der "Effekt" (d. h. der Regressionskoeffizient) stärker aus. In diesem Fall kann es also sinnvoll sein, den Prädiktor zu kategorisieren. Dies dient jedoch ausschließlich einem didaktischen Zweck; das Modell mit dem kategorisierten Prädiktor ist praktisch immer schlechter als das Modell mit dem kontinuierlichen Prädiktor.
Prospektive Studien sollten Daten, soweit möglich, als kontinuierliche Variablen erheben. Dann besteht die Möglichkeit, die Variablen zu einem späteren Zeitpunkt zu kategorisieren.
Die Linearitätsannahme: Lockerung mit Restricted Cubic Splines und Polynomen
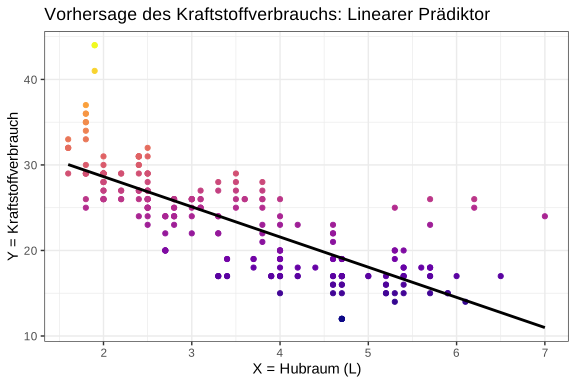
Lineare Modelle oder eng mit dem linearen Modell verwandte Modelle dominieren die Analysen zur Effektschätzung und Prädiktion. Das lineare Modell beruht auf der Annahme, dass zwischen dem Prädiktor und dem Endpunkt ein linearer Zusammenhang besteht (siehe Abbildung unten). Diese Annahme ist eine Vereinfachung aus Bequemlichkeit, da lineare Zusammenhänge mathematisch leicht zu handhaben sind. Tatsächlich ist die Natur jedoch selten vollständig linear, und es kann naiv sein, von linearen Zusammenhängen auszugehen. Dass sich Analytiker und Forschende häufig mit linearen Funktionen begnügen, liegt daran, dass diese eine akzeptable Näherung an die Wirklichkeit bieten. In der folgenden Abbildung sehen wir eine Regressionsgerade (schwarz), die zeigt, wie der Prädiktor mit dem Kraftstoffverbrauch () zusammenhängt. Aus der Abbildung geht hervor, dass die Regressionsgerade eine akzeptable Näherung an den Zusammenhang darstellt, bei niedrigen (<2) und hohen Werten (>5) von jedoch weiter von den Datenpunkten entfernt liegt (der Fehler ist größer).
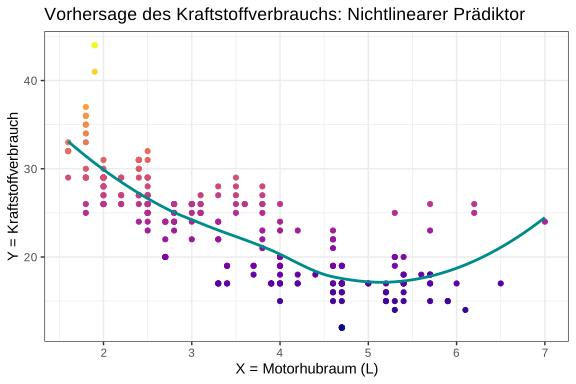
Wir wiederholen nun das obige Modell und lassen zu, dass der Prädiktor einen nichtlinearen Zusammenhang mit aufweist. Das bedeutet, dass der Zusammenhang zwischen und über den Wertebereich von variieren darf (flexibel sein darf). Das Ergebnis sieht wie folgt aus:
Legt man die Grafiken übereinander, wird deutlicher, dass das nichtlineare Modell eine höhere Präzision aufweist:
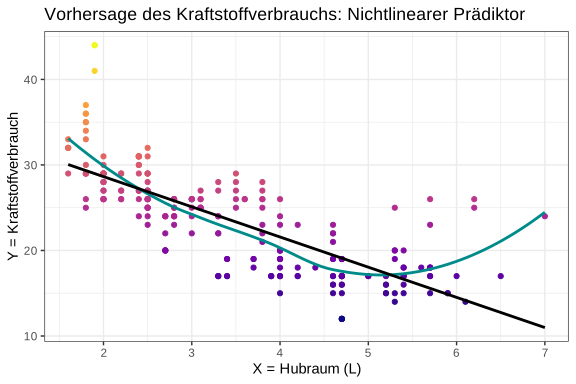
Die Linearitätsannahme sollte in der Regel hinterfragt werden. Sie lässt sich, wie im obigen Beispiel, einfach überprüfen (siehe Kapitel Lineare Regression). Die Validität des linearen Modells ist höher, wenn die Prädiktoren korrekt spezifiziert sind.
Ist der Zusammenhang zwischen und nicht linear, kann dies zu falschen Schlussfolgerungen führen. Die folgende Abbildung zeigt einen stark nichtlinearen Zusammenhang, der zu der falschen Schlussfolgerung führt, dass zwischen und kein Zusammenhang besteht; die Regressionsgerade zeigt dies, indem sie praktisch keine Steigung hat (β ≈ 0).
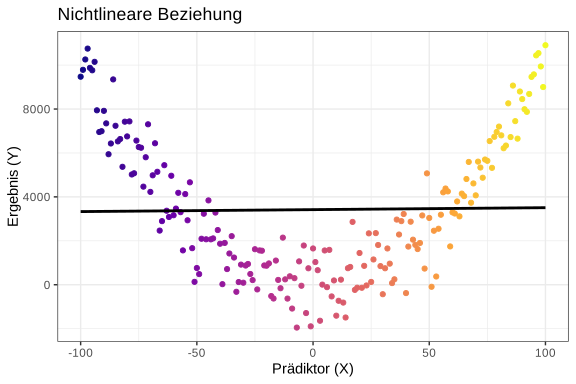
Es wird eine flexiblere Regressionslinie benötigt. Die Linearitätsannahme muss gelockert werden, damit die Regressionslinie den Daten besser folgt (sie besser vorhersagt). Die Transformation des Prädiktors war früher eine beliebte Methode. Wir logarithmieren den Prädiktor und stellen die Regressionslinie erneut dar:
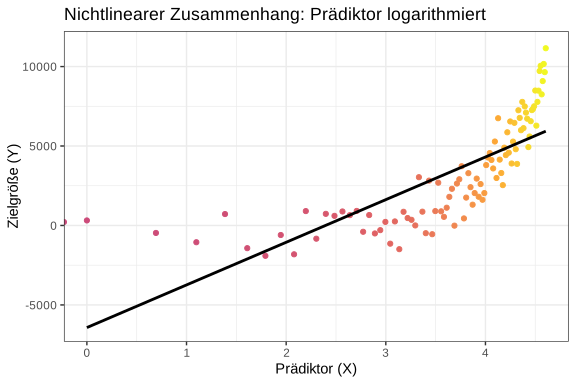
Die Transformation des Prädiktors führt im obigen Fall zu einem besseren Modell, das jedoch nicht optimal ist (siehe den Bereich < 2), und zudem wird der Koeffizient nun schwerer interpretierbar (man stelle sich vor, wir hätten das Körpergewicht in kg logarithmiert). Es ist besser, nichtlineare Funktionen von zu verwenden, die keinen linearen Zusammenhang zwischen und voraussetzen. Wir erstellen das Prädiktionsmodell erneut mit einer nichtlinearen Funktion, ohne zu logarithmieren, was folgendes Ergebnis liefert:
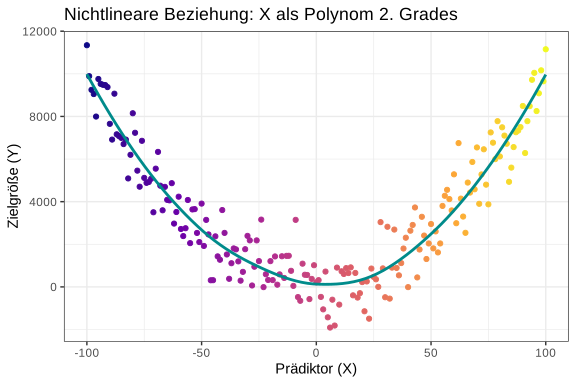
In der obigen Abbildung wurde mit einem Polynom zweiten Grades modelliert, das heißt, wurde mit multipliziert. Dies ist die einfachste Art, die Linearitätsannahme zu lockern, und bedeutet, dass man ein Polynom (engl. polynomial) verwendet, also ganzzahlige Potenzen des Prädiktors . Es gibt folgende Polynome:
- Polynom zweiten Grades:
- Polynom dritten Grades:
- Polynom vierten Grades:
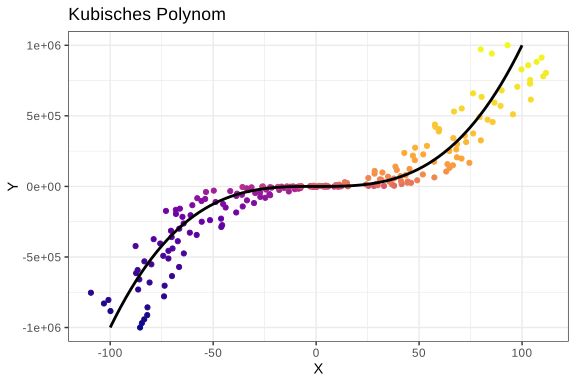
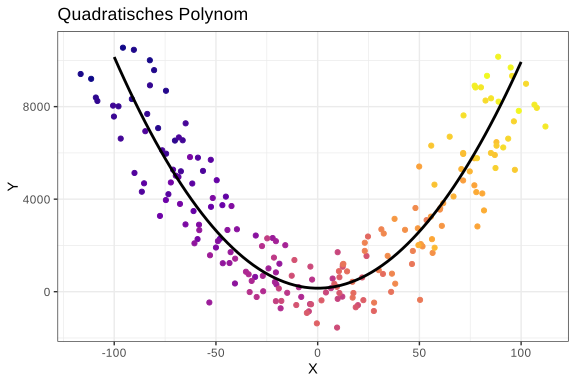
Möchte man Polynome in eine Regression aufnehmen, müssen auch alle niedrigeren Grade des Prädiktors aufgenommen werden. Soll also ein Polynom dritten Grades () für das Alter in das Modell eingehen, müssen auch und als einzelne Prädiktoren enthalten sein. Eine häufig verwendete und ebenso häufig kritisierte Methode, Polynome in Modelle aufzunehmen, besteht darin, die Polynome zu testen und sie beizubehalten, wenn die Koeffizienten statistisch signifikant sind (P < 0,05), da dies als Beleg dafür gilt, dass in den Daten eine nichtlineare Funktion vorliegt. Die Syntax für ein lineares Modell mit einem Polynom dritten Grades für den Prädiktor x lautet wie folgt:
lm(y ~ x + poly(x, 2) + poly(x, 3), data=data)Tatsächlich bezieht R die niedrigeren Grade eines Polynoms immer mit ein, auch wenn man dies nicht angibt. Das obige Modell ist daher äquivalent zu folgendem:
lm(y ~ poly(x, 3), data=data)Wir erstellen eine lineare Regression mit einem Polynom dritten Grades in den mpg-Daten. Wir verwenden das Package broom, um die Ergebnisse aus dem Modell zu extrahieren.
library(tidyverse)
data(mpg)

my_fit <- lm(hwy ~ drv + cyl + poly(displ, 3), data=mpg)

library(broom)
tidy(my_fit)| term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
| (Intercept) | 24.8304756 | 2.1392664 | 11.607005 | 0.000000 |
| drvf | 4.4553554 | 0.5050549 | 8.821528 | 0.000000 |
| drvr | 4.1892200 | 0.6871610 | 6.096417 | 0.000000 |
| cyl | -0.6548109 | 0.3682590 | -1.778126 | 0.0767217 |
| poly(displ, 3)1 | -41.8215567 | 9.8728249 | -4.236027 | 0.000033 |
| poly(displ, 3)2 | 17.0200984 | 3.2063213 | 5.308295 | 0.000000 |
| poly(displ, 3)3 | 2.0802160 | 3.0357794 | 0.685233 | 0.493896 |
Wie oben ersichtlich, ist das Polynom dritten Grades ("poly(displ, 3)3") nicht statistisch signifikant (p=0,493896), das Polynom zweiten Grades hingegen schon (p=0,000000), ebenso wie der lineare Prädiktor (p=0,000033). Polynome weisen jedoch mehrere Schwächen auf, die zu unbefriedigenden Vorhersagen führen können. Splines werden Polynomen häufig vorgezogen.
Regression Splines: lineare Splines, Cubic Splines, Restricted Cubic Splines
Ein Spline ist eine flexible Funktion, die aus mehreren Polynomen besteht. Jedes Polynom repräsentiert einen Abschnitt der Verteilung des Prädiktors , und alle Polynome sind an ihren Enden miteinander verbunden.
Die einfachste Spline-Funktion ist die lineare. Ein einfacher linearer Spline bedeutet schlicht, dass der Prädiktor in Intervalle unterteilt wurde, wodurch faktisch in mehrere Prädiktoren aufgeteilt wird. Auch wenn die einzelnen Intervalle lineare Funktionen sind, können sie zusammen eine nichtlineare Funktion bilden. In der folgenden Abbildung wurde mithilfe von zwei Knotenpunkten (engl. knots) in 3 Intervalle unterteilt. Anzahl und Lage dieser Knots lassen sich anpassen.
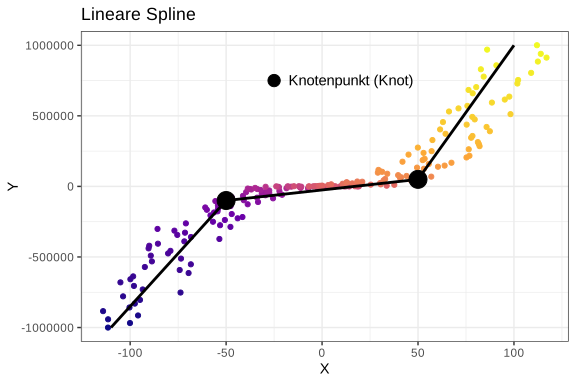
Ein einfacher linearer Spline ermöglicht die Modellierung nichtlinearer Funktionen und setzt lediglich voraus, dass der Zusammenhang zwischen und innerhalb jedes Intervalls linear ist.
Die Gleichung des ursprünglichen Modells (ohne Spline) lautet wie folgt:
Y = β0 + β1X1
Wird der Prädiktor X1 zu einem Spline mit 3 Intervallen erweitert, lautet die Gleichung:
Y = β0 + β1X1 + β2X2 + β3X3
Cubic Splines (CS)
Ein linearer Spline ist Polynomen meist vorzuziehen, leider sind lineare Splines jedoch gerade an den Knotenpunkten nicht flexibel, weshalb die Modellierung gebogener bzw. gekrümmter Zusammenhänge nicht optimal gelingt. Um dies zu überwinden, kann man Cubic Splines verwenden; sie entsprechen linearen Splines, wobei in jedem Intervall jedoch Polynome verwendet werden. Dadurch sind die Übergänge zwischen den Intervallen glatt, und Cubic Splines bilden gebogene bzw. gekrümmte Zusammenhänge besser ab (als lineare Splines). Hat ein Cubic Spline 3 Knotenpunkte (Knots), müssen insgesamt 6 Regressionskoeffizienten (β1 bis β6) geschätzt werden. Die Anzahl der zu schätzenden Koeffizienten beträgt nämlich k+3, wobei k die Anzahl der Knots ist. Die Verwendung von Cubic Splines ist daher aufwendig, da mehr Parameter geschätzt werden müssen.
Restricted Cubic Splines (RCS, Natural Splines)
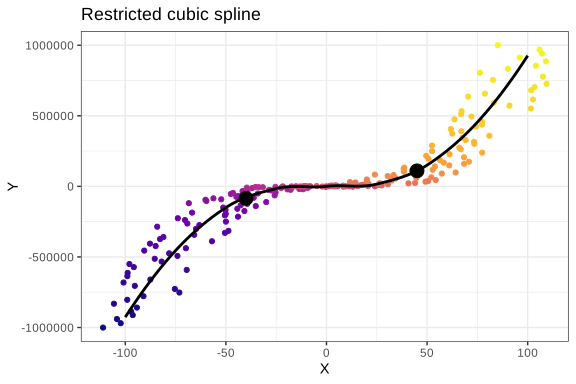
Die beste und am häufigsten verwendete Spline-Funktion ist der Restricted Cubic Spline. Diese Spline-Funktionen entsprechen Cubic Splines, die Funktion wird jedoch gezwungen, in den Randbereichen (am Anfang und am Ende der Verteilung des Prädiktors) linear zu verlaufen. Dies verbessert die Präzision des Modells. Die Verwendung von Restricted Cubic Splines kostet das Modell k+1 Parameter. Werden also 3 Knots verwendet, müssen 4 Koeffizienten geschätzt werden.
Sind Splines erforderlich?
Wird ein Prädiktor zu einer Spline-Funktion erweitert, kann man anhand des P-Werts beurteilen, ob die Spline-Funktion notwendig ist. Die Nullhypothese lautet, dass die Koeffizienten (für die einzelnen Spline-Intervalle) gleich 0 sind; ist der P-Wert < 0,05, ist dies unwahrscheinlich, und man behält die Splines bei.
Wie viele Knotenpunkte (Knots) werden benötigt?
Kennt man den Zusammenhang zwischen dem Prädiktor und dem Endpunkt und weiß, wo Krümmungen und Nichtlinearitäten vorliegen, kann man selbst festlegen, wo die Knotenpunkte platziert werden sollen. Man muss jedoch nicht wissen, wo Nichtlinearität besteht. Splines lassen sich auch ohne dieses Wissen problemlos einsetzen, sofern die Knotenpunkte gleichmäßig über den Wertebereich von verteilt werden.
In R gibt man die gewünschte Anzahl an Knotenpunkten an, und diese werden automatisch an geeigneten Stellen platziert. Man verwendet mindestens 3 Knotenpunkte (auch wenn die obigen Beispiele mit zwei Knotenpunkten illustriert wurden), und es ist selten notwendig, mehr als 6 Knotenpunkte zu verwenden. Je mehr Beobachtungen vorliegen, desto mehr Knotenpunkte können verwendet werden.
Restricted Cubic Splines können für lineare Regression, logistische Regression, Poisson-Regression, Cox-Regression usw. verwendet werden.
Man sollte großzügig von Restricted Cubic Splines Gebrauch machen, da es naiv ist, lineare Zusammenhänge vorauszusetzen. Man sollte seine Splines jedoch vorab spezifizieren, bevor das Modell aufgebaut wird. Dem vorzugreifen, indem man Zusammenhänge zwischen Variablen visualisiert (z. B. mit Korrelationsdiagrammen), wird nicht empfohlen. Besonders großzügig sollte man Splines bei Prädiktoren einsetzen, die stark mit dem Endpunkt zusammenhängen. Bei Variablen mit schwachem Zusammenhang zum Endpunkt lohnt es sich meist nicht, Freiheitsgrade zu investieren.
Im folgenden Code laden wir die Packages tidyverse, Hmisc und rms und anschließend die mpg-Daten. Das Package rms enthält Funktionen für Restricted Cubic Splines (rcs()). Um rms zu verwenden, müssen wir dem Package mitteilen, welche Verteilungen in den mpg-Daten vorliegen. Anschließend legen wir dies in options() fest. Danach erstellen wir mit ols() (der Funktion für lineare Regression im Package rms) ein Modell, in dem der Prädiktor displ mit einer Spline-Funktion modelliert wird. Der Zusammenhang wird anschließend mit ggplot() dargestellt. Beachten Sie, dass wir zwei Grafiken erstellen und sie mit cowplot() übereinanderlegen.
library(Hmisc)
library(rms)

## Verteilungen
ddist <- datadist(mpg)
options(datadist='ddist')

## Erstellt das Modell
model <- ols(hwy ~ rcs(displ, 3), data=mpg, x=T, y=T)

## Grafik der Spline-Funktion erstellen
p1 <- ggplot(Predict(model, "displ"), ylab="Y (hwy)") +theme_half_open()

## Grafik mit eingezeichneten x- und y-Werten erstellen
p2 <- ggplot(mpg, aes(x=displ, y=hwy, color=displ)) + geom_point() + scale_color_viridis_c(option = "plasma") + theme_half_open()

## Legt die Grafiken übereinander
library(cowplot)
aligned_plots <- align_plots(p1, p2, align="hv", axis="tblr")
ggdraw(aligned_plots[[1]]) + draw_plot(aligned_plots[[2]])