
Logistische Regression
Synonym: Logit-Regression, Logit-Modell
Mit der linearen Regression lassen sich stetige Zielgrößen () untersuchen, etwa Körpergewicht, Blutdruck, Einkommen oder Preis. Für binäre Zielgrößen, also Zielgrößen mit zwei Kategorien, sollte die lineare Regression jedoch nicht verwendet werden. Beispiele für binäre Zielgrößen sind solche, die als ja/nein, 0/1, krank/gesund, gut/schlecht, zufrieden/unzufrieden, wenig/viel usw. klassifiziert werden.
Es gibt mehrere Gründe, warum die lineare Regression weder für binäre Zielgrößen noch für kategoriale Zielgrößen mit mehr als 2 Kategorien eingesetzt werden sollte. Der erste Grund ist konzeptioneller Natur und lässt sich an einer kategorialen Zielgröße mit drei Ausprägungen veranschaulichen. Angenommen, wir untersuchen den Zusammenhang zwischen dem Prädiktor und einer Diagnose , die eine der folgenden Kategorien annehmen kann: Schlaganfall, Epilepsie oder Parkinson-Krankheit. Um eine lineare Regression anwenden zu können, kodieren wir diese Diagnosen mit den Zahlen 1 bis 3. Wir definieren unsere Zielgröße wie folgt:
Eine solche Definition der Zielgröße ist mit mehreren Problemen verbunden. Zunächst einmal unterstellt sie eine inhärente Rangfolge der Diagnosen, die in diesem Fall nicht existiert. Außerdem behaupten wir damit, dass der Unterschied zwischen Schlaganfall und Epilepsie (numerischer Unterschied von 1) genauso groß ist wie der Unterschied zwischen Epilepsie und Parkinson-Krankheit (numerischer Unterschied von 1), was ein unsinniger Vergleich ist.
Soll mit dem Regressionsmodell untersucht werden, wie verschiedene Prädiktoren () mit dem Risiko für diese Diagnosen (Y) zusammenhängen, führt das lineare Modell zu unplausiblen Ergebnissen. Zur Veranschaulichung erstellen wir eine lineare Regression mit Daten aus PimaIndiansDiabetes, das im Package mlbench enthalten ist. Das Package lässt sich mit dem Befehl install.packages("mlbench") installieren. In PimaIndiansDiabetes ist die Variable diabetes als neg (negative) oder pos (positive) kodiert; wir kodieren sie in 0 bzw. 1 um, damit eine lineare Regression möglich ist. In diesem speziellen Fall erstellen wir die lineare Regression direkt in ggplot() (üblicherweise wird die Funktion lm() verwendet). Mit ggplot() zeichnen wir ein Streudiagramm mit glucose auf der x-Achse und diabetes auf der y-Achse; anschließend legen wir mit geom_smooth() eine lineare Regression durch die Daten.
library(mlbench)
data("PimaIndiansDiabetes")

## Diabetes in 0 / 1 umkodieren
PimaIndiansDiabetes$diabetes <- ifelse(PimaIndiansDiabetes$diabetes=='pos', 1, 0)

## Lineares Regressionsmodell
PimaIndiansDiabetes %>%
  ggplot(aes(glucose, diabetes)) +
  geom_point(alpha = 0.5, size=3) +
  geom_smooth(method = "lm") +
  labs(title = "Linjär regression med binärt utfall",
       x = "Glucose",
       y = "Sannolikhet för diabetes")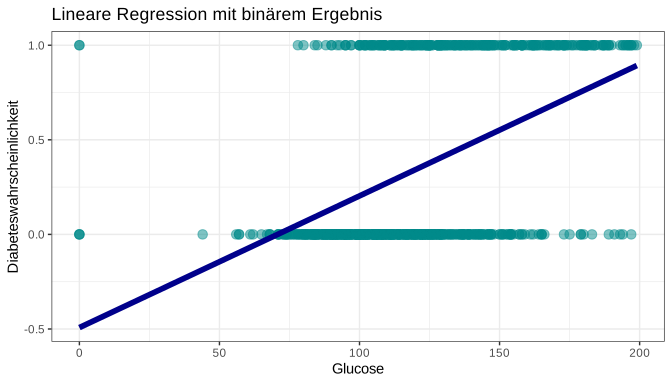
Die obige Grafik ist problematisch. Zunächst sagt das Modell bei glucose <75 negative Wahrscheinlichkeiten vorher. Eine Wahrscheinlichkeit kann jedoch niemals negativ sein. Außerdem würde das Modell bei hohen glucose-Werten (>200) eine Wahrscheinlichkeit >1 vorhersagen. Eine Wahrscheinlichkeit kann niemals größer als 1,0 sein. Es ist also offensichtlich, dass die lineare Regression für kategoriale Zielgrößen ungeeignet ist.
Die mathematische Lösung dieses Problems besteht darin, ein Regressionsmodell zu konstruieren, das unabhängig vom Wert des Prädiktors stets eine Vorhersage zwischen 0 und 1 liefert. Dazu muss die Zielgröße als Wahrscheinlichkeit (, Probabilität) behandelt werden, die immer zwischen 0 und 1 liegt. Dies gelingt mit der Funktion Logit bzw. Log-Odds :
In der obigen Formel entspricht den Odds für das Ereignis. Für das Verständnis der weiteren Ausführungen ist der Begriff der Odds zentral.
Odds
Odds sind zentral für die logistische Regression. In einer logistischen Regression ist die Zielgröße binär (0/1). Man kann dies als eine Situation betrachten, in der ein Ereignis ausbleibt (0) oder eintritt (1). Das logistische Modell berechnet die Odds dafür, dass das Ereignis eintritt. Die Odds sind die Wahrscheinlichkeit, dass etwas eintritt, geteilt durch die Wahrscheinlichkeit, dass es nicht eintritt. Im Folgenden ist dargestellt, wie die Odds für ein als ja/nein definiertes Ereignis lauten, wobei die Wahrscheinlichkeit ist.
Dies ist gleichbedeutend mit:
Beispiel 1: Wie hoch sind die Odds, bei einem Würfelwurf eine gerade Zahl (2, 4 oder 6) zu würfeln?
Antwort: Ein Würfel hat sechs Zahlen (1, 2, 3, 4, 5, 6). Die Wahrscheinlichkeit, 2, 4 oder 6 zu würfeln, beträgt 3/6. Die Wahrscheinlichkeit, nicht 2, 4 oder 6 zu würfeln, beträgt ebenfalls 3/6. Die Odds werden wie folgt berechnet:
Odds von 1,0 bedeuten, dass das Ereignis mit gleicher Wahrscheinlichkeit eintritt wie ausbleibt.
Beispiel 2: Wie hoch sind die Odds, bei einem Würfelwurf eine der Zahlen 1, 2, 3 oder 4 zu würfeln?
Antwort: Die Wahrscheinlichkeit, 1, 2, 3 oder 4 zu würfeln, beträgt 4/6, die Wahrscheinlichkeit für ein anderes Ergebnis 2/6. Die Odds berechnen sich als:
Die Odds betragen also 2,0, das heißt, die Wahrscheinlichkeit, dass das Ereignis eintritt, ist doppelt so hoch wie die Wahrscheinlichkeit, dass es nicht eintritt.
Wir kehren nun zur Diskussion des Logits zurück.
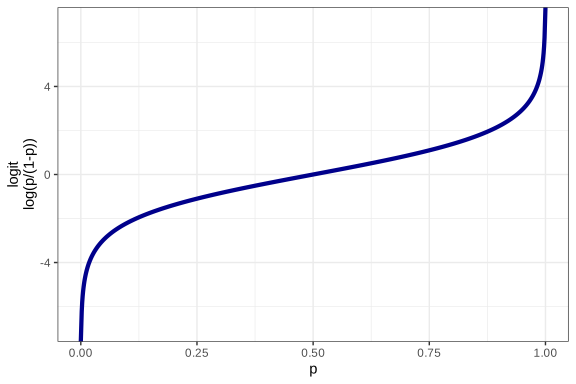
In der folgenden Abbildung ist gegen das Logit (Log-Odds) aufgetragen. Die Abbildung zeigt, dass sich Wahrscheinlichkeiten mithilfe des Logits in beliebige Odds überführen lassen.
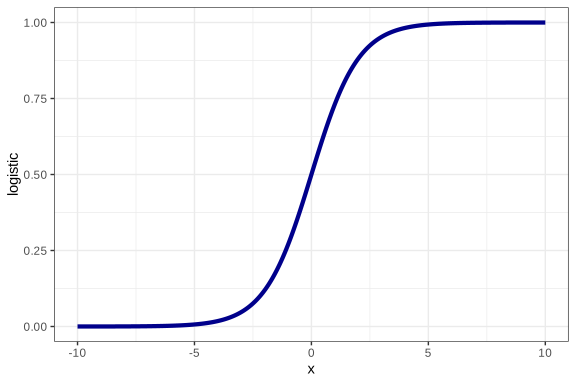
Aus den Log-Odds lassen sich mithilfe der logistischen Funktion (logistic function) Wahrscheinlichkeiten berechnen:
Der Verlauf dieser Funktion ist in der folgenden Abbildung dargestellt. Man beachte, dass die Wahrscheinlichkeit (y-Achse) unabhängig vom Wert des Prädiktors zwischen 0 und 1 liegt.
Transformiert man die Wahrscheinlichkeit mit dem Logit, erhält man einen Wert, der sich mit einer linearen Gleichung vorhersagen lässt:
Die Logit-Funktion ermöglicht es also, mit zu verknüpfen. Das Logit kann daher als Linkfunktion (link function) aufgefasst werden. In der logistischen Regression ist der Logarithmus der Odds somit eine lineare Funktion der Prädiktoren.
Wendet man diese Funktion auf dieselben Daten wie oben an (Vorhersage von Diabetes), ergibt sich für das Regressionsmodell folgende Funktion:
PimaIndiansDiabetes %>%
  ggplot(aes(glucose, diabetes)) +
  geom_point(alpha = 0.5) +
  geom_smooth(method = "glm", method.args = list(family = "binomial")) +
  labs(title = "Logistisk regression med binärt utfall",
       x = "Glucose",
       y = "Sannolikhet för diabetes")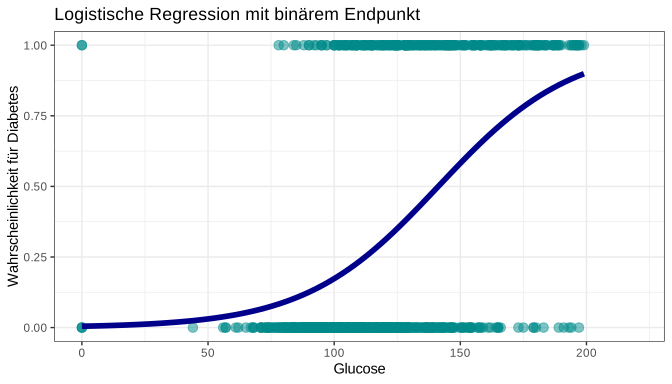
Dieses Modell liefert stets Wahrscheinlichkeiten zwischen 0 und 1.
Interpretation der logistischen Regression
Der Regressionskoeffizient () gibt an, wie sich der Logarithmus der Odds für das Ereignis ändert, wenn der Prädiktor um 1 Einheit zunimmt. Das erinnert an die lineare Regression, bei der angibt, wie sich ändert, wenn der Prädiktor um 1 Einheit zunimmt. Bei der logistischen Regression ist es also der Logarithmus der Odds für das Ereignis, der sich ändert.
Odds Ratio (Chancenverhältnis)
Wahrscheinlichkeit (Probabilität) ist ein schwer fassbares Konzept. Logarithmierte Wahrscheinlichkeiten zu interpretieren ist noch schwieriger. Deshalb transformieren wir den Regressionskoeffizienten, indem wir ihn exponenzieren und so ein Chancenverhältnis (Odds Ratio, OR) erhalten. Die Odds Ratio ist deutlich leichter zu interpretieren. Ein Beispiel:
- Für den Prädiktor erhalten wir einen Regressionskoeffizienten von 0,5. Das bedeutet: Nimmt der Prädiktor um 1 Einheit zu, steigt der Logarithmus der Odds für das Eintreten des Ereignisses um 0,5.
- Wir exponenzieren den Koeffizienten:
- Das bedeutet: Nimmt der Prädiktor um 1 Einheit zu, steigen die Odds für das Ereignis um 65 %.
Eine Odds Ratio lässt sich also in Prozent umrechnen! Dazu dient die Formel: .
Beispiel 1: Odds Ratio = 1,10. Berechnung: 100•(1,10 – 1) = 10 %. Interpretation: Mit jeder Einheit, um die der Prädiktor X zunimmt, steigen die Odds für das Ereignis um 10 %.
Beispiel 2: Odds Ratio = 0,90. Berechnung: 100•(0,9 – 1) = –10 %. Interpretation: Mit jeder Einheit, um die der Prädiktor X zunimmt, sinken die Odds für das Ereignis um 10 %.
Eine Odds Ratio (Chancenverhältnis) von 1,0 bedeutet, dass der Prädiktor nicht mit assoziiert ist, da eine Zunahme oder Abnahme von die Odds für das Ereignis nicht beeinflusst. Ist die Odds Ratio größer als 1,0, steigen die Odds für das Ereignis; ist sie kleiner als 1,0, sinken sie. Eine Odds Ratio von 1,50 bedeutet um 50 % erhöhte Odds, eine Odds Ratio von 0,5 um 50 % verringerte Odds.
Bei Verwendung der Odds Ratio ist die prozentuale Änderung der Odds jedes Mal gleich, wenn der Prädiktor um 1 Einheit zunimmt. Das liegt daran, dass die logistische Regression einen linearen Zusammenhang zwischen und log(Odds) voraussetzt.
Beispiel einer logistischen Regression
Wir erstellen eine logistische Regression mit Daten aus PimaIndiansDiabetes, das im Package mlbench enthalten ist. Installieren Sie das Package mit dem Befehl install.packages("mlbench"). In den Daten ist die Variable diabetes als pos (positive) oder neg (negative) kodiert. Die logistische Regression wird mit der Funktion glm() erstellt, die zur Basisinstallation von R gehört. GLM steht für generalized linear model (verallgemeinertes lineares Modell), das lineare Modelle mithilfe einer Linkfunktion (link function) schätzt. In der logistischen Regression sind die Log-Odds (Logit) die Linkfunktion. Das Modell wird wie folgt spezifiziert:
diabetes="pos" ~ glucose + agebedeutet, dass wir die Kategorie "pos" mithilfe der Variablen glucose und age vorhersagen wollen.family = binomial(link = logit)legt fest, welche Linkfunktion GLM verwenden soll.
library(mlbench)
data("PimaIndiansDiabetes")

min_modell <- glm(diabetes=="pos" ~ glucose + age,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)
Das Ergebnis des Modells mit der Base-R-Funktion summary():
summary(min_modell)Call:
glm(formula = diabetes == "pos" ~ glucose + age, family = binomial(link = logit),
data = PimaIndiansDiabetes)
Deviance Residuals:
Min 1Q Median 3Q Max
-2.3367 -0.7775 -0.5087 0.8367 3.1630
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -5.912449 0.462620 -12.78 < 0.0000000000000002 ***
glucose 0.035644 0.003290 10.83 < 0.0000000000000002 ***
age 0.024778 0.007374 3.36 0.000778 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Dispersion parameter for binomial family taken to be 1)
Null deviance: 993.48 on 767 degrees of freedom
Residual deviance: 797.36 on 765 degrees of freedom
AIC: 803.36
Number of Fisher Scoring iterations: 4Unter der Überschrift Coefficients werden die Regressionskoeffizienten aufgeführt. Beide Koeffizienten (siehe Estimate für glucose und age) sind positiv (>0). Zudem sind die p-Werte <0,005, die Koeffizienten sind also statistisch signifikant.
In einer wissenschaftlichen Publikation möchte man meist die Odds Ratio (OR) mit 95-%-Konfidenzintervall angeben. Dazu verwenden wir die Funktion tidy aus dem Package broom. Zur Erinnerung: Der Koeffizient entspricht den Log-Odds für Y, er muss also exponenziert werden, um die Odds Ratio zu erhalten. Mit dem folgenden Befehl fordern wir sowohl die Exponenzierung als auch das 95-%-Konfidenzintervall an:
library(broom)
tidy(min_modell, exponentiate=T, conf.int=T)
## A tibble: 3 × 7
term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 0.00271 0.463 -12.8 2.11e-37 0.00106 0.00653
2 glucose 1.04 0.00329 10.8 2.37e-27 1.03 1.04
3 age 1.03 0.00737 3.36 7.78e- 4 1.01 1.04Das obige Ergebnis wird wie folgt interpretiert:
- Estimate ist die Odds Ratio für das Ereignis Y.
- Nimmt glucose um 1 Einheit zu, steigt das Risiko für Diabetes um 4 %.
- Nimmt age um 1 Einheit zu, steigt das Risiko für Diabetes um 3 %.
- conf.low und conf.high geben ein 95-%-Konfidenzintervall an. Mit 95 % Sicherheit liegt die Odds Ratio für glucose zwischen 1,03 und 1,04; das bedeutet, dass eine Zunahme von glucose um 1 Einheit mit 95 % Sicherheit eine um 3 % bis 4 % höhere Wahrscheinlichkeit für Diabetes ergibt.
Eine Modelldiagnostik lässt sich effizient mit der Funktion check_model() aus dem Package easystats erhalten:
library(easystats)
check_model(min_modell)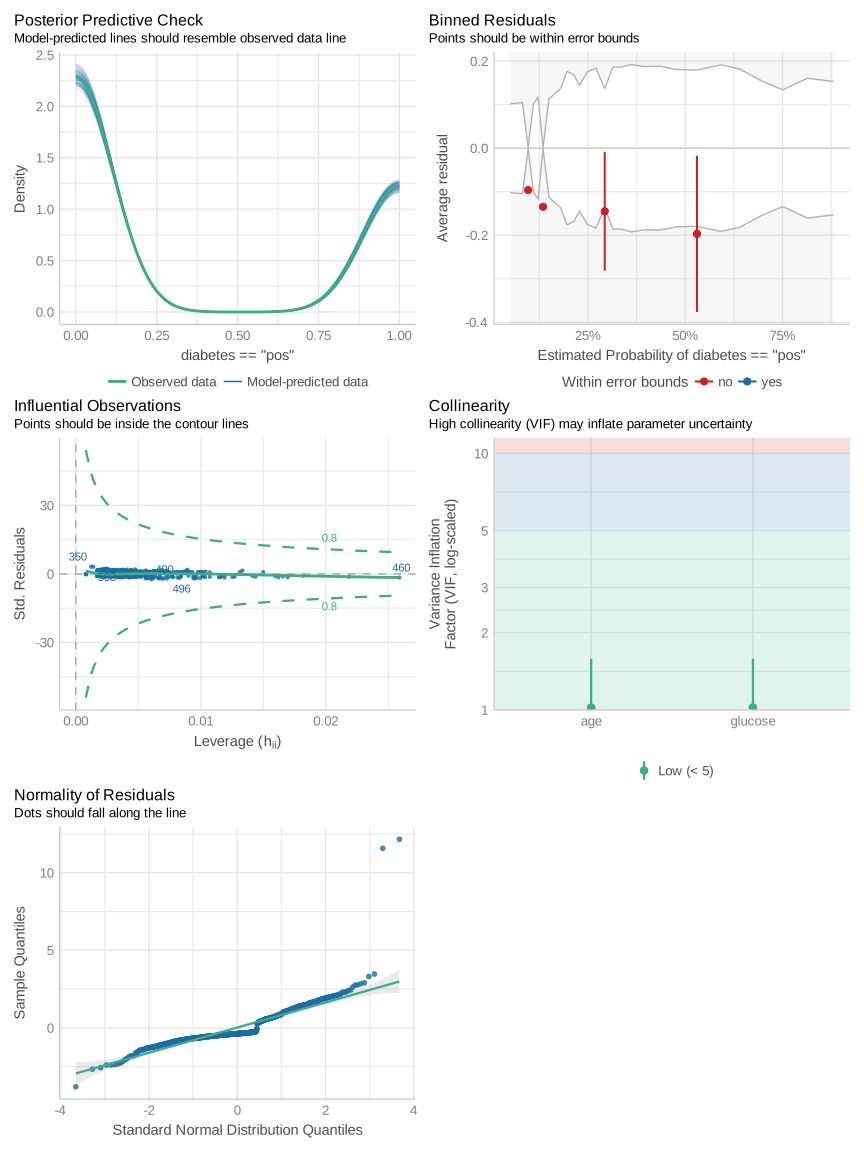
Vorhersagen mit der logistischen Regression
Mit der Funktion predict() können wir mit dem Regressionsmodell Vorhersagen treffen. Es folgen zwei Beispiele, in denen wir für eine einzelne Person eine Vorhersage treffen, indem wir einen neuen Data Frame mit den Werten der Person für glucose und age erstellen:
## Eine neue Beobachtung definieren und das Objekt "new_patient" nennen
new_patient = data.frame(age=50,
                         glucose=150)

## Die Wahrscheinlichkeit für Diabetes vorhersagen
predict(min_modell, newdata=new_patient, type="response")0.00422564Die obige Zahl ist die Wahrscheinlichkeit (), dass die Person Diabetes hat.
ROC-Kurve für das Modell
Die Vorhersagegüte des Modells wird in der Regel mithilfe einer ROC-Kurve beurteilt. Im Folgenden erstellen wir drei Varianten des Modells und vergleichen sie anhand der ROC. Man beachte jedoch, dass ein Vergleich verschiedener Modelle möglichst mit einem Resampling-Verfahren erfolgen sollte, vorzugsweise mit Kreuzvalidierung (siehe Kapitel Modelle bewerten und vergleichen).
## Ein Modell mit glucose und age
min_modell_1 <- glm(diabetes=="pos" ~ glucose + age,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

## Ein Modell mit glucose, age, insulin und pressure
min_modell_2 <- glm(diabetes=="pos" ~ glucose + age + insulin + pressure,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

## Ein Modell mit allen verfügbaren Prädiktoren in den Daten
## Der Punkt (.) ist die Kurzschreibweise für "alle Prädiktoren"
min_modell_3 <- glm(diabetes=="pos" ~ .,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

library(easystats)
plot(performance_roc(min_modell_1, min_modell_2, min_modell_3))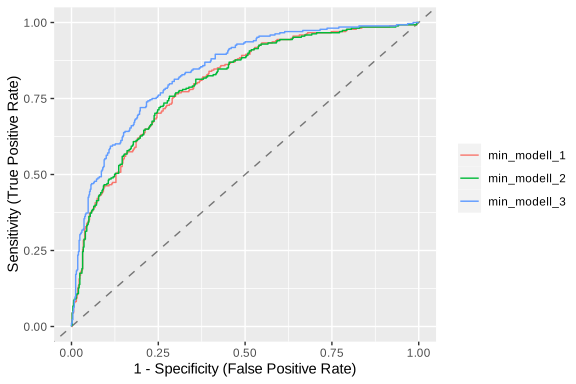
Multiple logistische Regression
Wie die obigen Beispiele zeigen, kann man mehrere Prädiktoren in das logistische Modell aufnehmen, und es akzeptiert sowohl kategoriale als auch stetige Prädiktoren. Enthält das Modell mehrere Prädiktoren, wird der Koeffizient jedes einzelnen Prädiktors als dessen "Effekt" interpretiert, wenn die übrigen Prädiktoren konstant gehalten werden. Der "Effekt" des Prädiktors ist somit derjenige, der bei Adjustierung für die übrigen Prädiktoren im Modell beobachtet wird.
Maximum-Likelihood-Schätzung (MLE): Berechnung der Regressionskoeffizienten in der logistischen Regression
Zur Erinnerung: Für das lineare Modell gibt es eine einfache Formel, um die Modellparameter (Achsenabschnitt und Regressionskoeffizienten) zu bestimmen. Die Gleichung ist diejenige Regressionsgerade, die die Daten am besten beschreibt. Sie wird ermittelt, indem die Summe aller Fehler (errors) minimiert wird (siehe Lineare Regression). Für die logistische Regression gibt es keine einfache Gleichung, die sich lösen ließe. Stattdessen muss die Software die Parameter mithilfe von Optimierungsfunktionen (optimizer functions) finden. Die gebräuchlichste Methode hierfür ist die MLE (Maximum-Likelihood-Schätzung).
Die Maximum-Likelihood-Schätzung (MLE, Maximum-Likelihood-Methode) wird allgemein verwendet, um die Parameter einer Wahrscheinlichkeitsverteilung zu schätzen. Die Methode wählt diejenigen Parameter, die die Wahrscheinlichkeit maximieren, die beobachteten Ergebnisse zu erhalten. Sie setzt voraus, dass für eine Wahrscheinlichkeitsverteilung verwendet wird; im Fall der logistischen Regression ist dies die Bernoulli-Verteilung. Ausgehend von dieser Verteilung lässt sich für die beobachteten Daten eine Likelihood-Funktion berechnen. Diese Funktion kann anschließend optimiert werden, um die Parameter zu finden, die die Daten am besten beschreiben. Die genaue Berechnung dieser Parameter geht über den Rahmen dieses Kurses hinaus.