
Mehrere Modelle vergleichen und auswählen
Wenn das Ziel darin besteht, ein Vorhersagemodell mit hoher Vorhersagekraft zu entwickeln, müssen verschiedene Modelle getestet und miteinander verglichen werden. Nur ein einziges Modell zu erstellen und zu evaluieren, ist ein Kardinalfehler, wenn das Modell für Vorhersagen eingesetzt werden soll. Um verschiedene Modelle zu evaluieren und zu vergleichen, ist ein standardisierter Arbeitsablauf erforderlich, der im folgenden Flussdiagramm zusammengefasst ist.
graph TD;
    D(1. Daten) --> |"75%"| TD(2. Trainingsdaten);
    D --> |"25%"| Test(7. Testdaten);
    TD --> Kand(3. Kandidatenmodelle) --> CV(4. Cross-Validation<br>Kreuzvalidierung)
CV --> BP(5. Beste Parameter finden)
TD --> OM(6. Modell erneut trainieren)
BP-->OM
OM-->Test
Test-->SE(8. Abschließende Evaluation)
Kandidatenmodelle (Candidate models)
Verschiedene Modelltypen werden getestet, weil wir im Voraus nicht wissen, welches Modell das beste ist. Beispiele für Modelle bei stetigen Zielgrößen sind lineare Regression, Random Forest, Gradient Boosting usw. Bei binären Endpunkten können wir logistische Regression, Random Forest, Gradient Boosting usw. testen. Tatsächlich lassen sich für jeden Modelltyp zudem verschiedene Spezifikationen des Modells testen. Man erkennt schnell, dass für jede gegebene Aufgabe eine sehr große Zahl von Modellen getestet werden kann, und das ist zeitaufwendige Arbeit. Glücklicherweise gibt es in R eine Reihe von Packages und Funktionen, die diese Arbeit erleichtern. Darauf wird später eingegangen.
Training
Sobald eine Reihe verschiedener Modelle ausgewählt wurde, werden sie auf einer Teilmenge aller Daten trainiert. Als Faustregel gilt, dass 70-80% der Daten für das Training verwendet werden ("training set"). Anschließend werden die Modelle an den Testdaten ("test set") getestet, die die übrigen 20-30% der Daten ausmachen.
Overfitting
Die Modelle an Testdaten zu evaluieren, ist ein einfacher, aber genialer Schritt. Praktisch immer zeigen Modelle in den Trainingsdaten eine hohe Vorhersagekraft, was daran liegt, dass die Modelle alle Beobachtungen der Trainingsdaten gesehen haben. Das bedeutet, dass die Modelle die Muster und Zusammenhänge in den Trainingsdaten kennen. Daraus resultiert eine fälschlich hohe Präzision in den Trainingsdaten. Die große Herausforderung besteht darin, ein Modell zu erstellen, das auf künftigen Daten (die das Modell nie beobachtet hat) eine hohe Präzision erreicht, und genau das ist der Zweck der Testdaten. Die Modelle dürfen niemals an den Testdaten trainiert werden. Die Beobachtungen in den Testdaten sind für die Modelle somit "neu". Die Präzision auf den Testdaten zeigt die zu erwartende Präzision des Modells auf neuen und künftigen Daten.
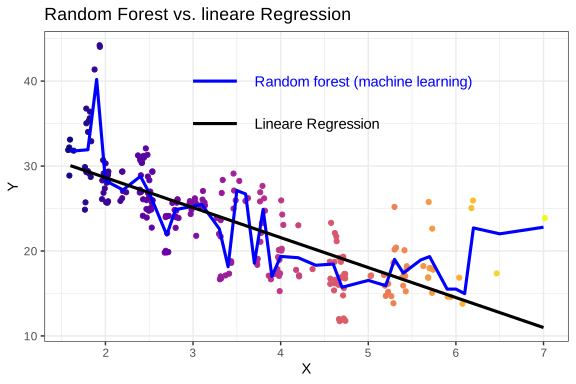
Die Bedeutung des oben Gesagten wird beim Machine Learning noch deutlicher. Die meisten Modelle im Machine Learning bilden keine linearen Zusammenhänge zwischen und . Die Modelle können sehr flexible Funktionen erzeugen, die den Daten äußerst genau folgen. Das bedeutet, dass selbst kleine, unbedeutende Abweichungen in Zusammenhängen erfasst und modelliert werden können. Dies veranschaulicht die folgende Abbildung, in der die Ergebnisse zweier Vorhersagemodelle verglichen werden. Eines davon ist die klassische lineare Regression, das andere Machine Learning mit Random Forest. Beide Modelle sind in derselben Datenmenge trainiert und getestet (Testdaten wurden nicht verwendet). Die Abbildung zeigt, dass Random Forest ein sehr flexibles Modell ist, das den Daten sehr präzise folgt. Das mag beeindruckend erscheinen, ist aber ein großer Nachteil. Das Phänomen heißt Overfitting und bedeutet, dass die Vorhersage des Modells in den Trainingsdaten hervorragend ist (aufgrund der Flexibilität des Modells), und dies führt das Modell in die Irre, wenn es an neuen Daten getestet wird, die es noch nicht beobachtet hat. Ein gutes Modell lässt sich auf die Testdaten generalisieren und zeigt eine hohe Präzision bei Beobachtungen, die es noch nicht kennengelernt hat.
Kreuzvalidierung (Cross Validation)
k-Fold Cross Validation
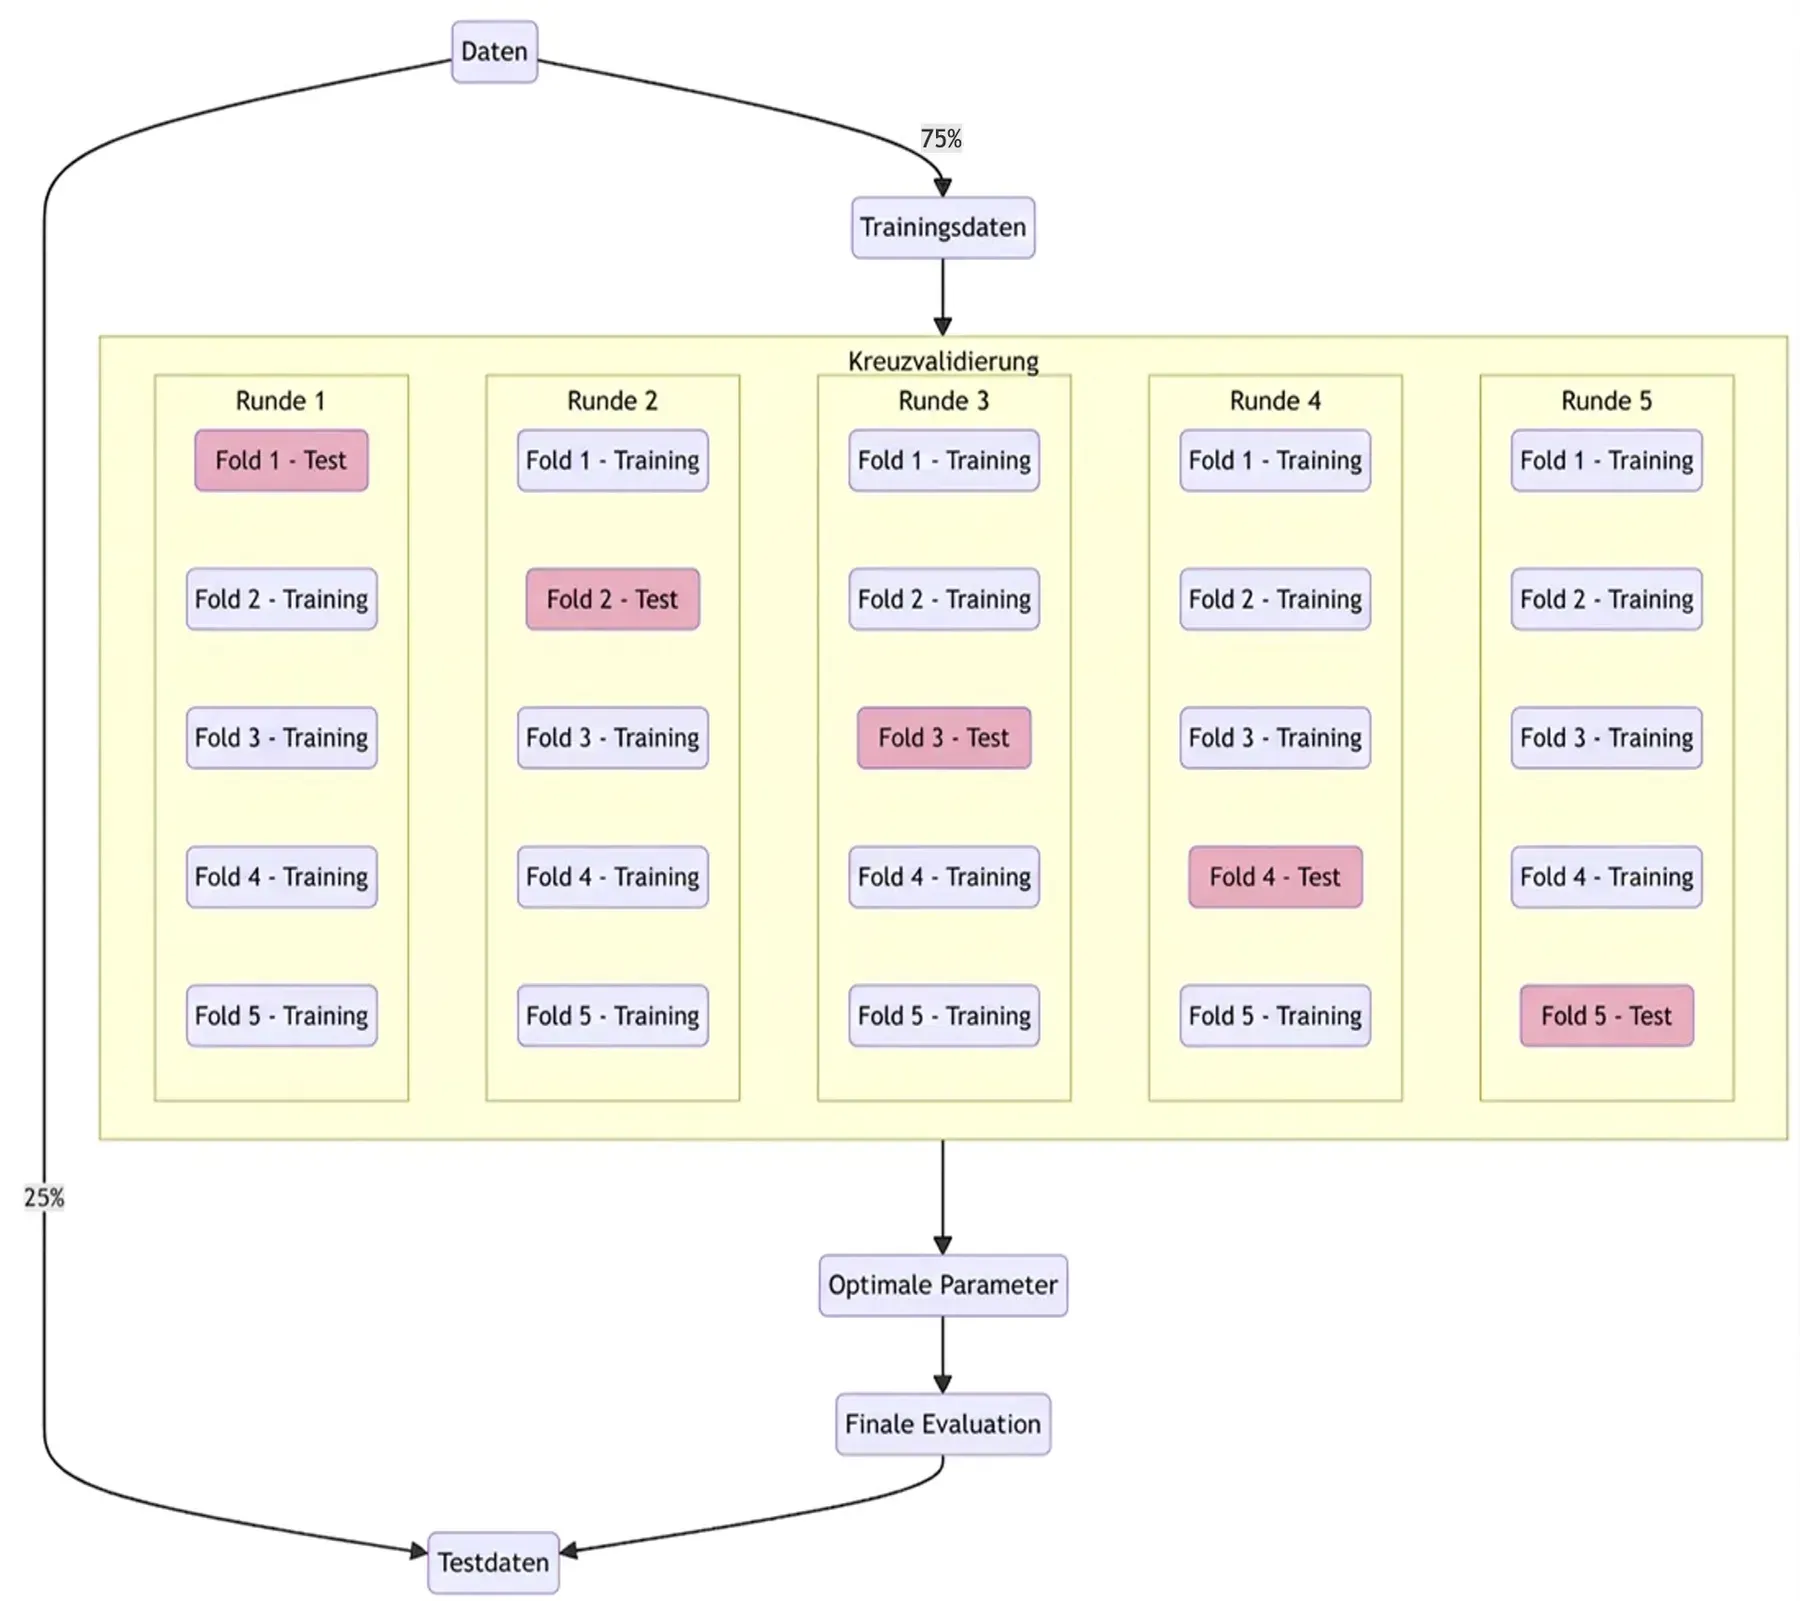
Die am häufigsten verwendete Methode zur Evaluation von Modellen in den Trainingsdaten ist die Kreuzvalidierung (Cross Validation). Das folgende Flussdiagramm zeigt, wie die Kreuzvalidierung funktioniert.
- Der ursprüngliche Datensatz wird zufällig in Trainings- und Testdaten aufgeteilt. Die Aufteilung kann beispielsweise 75% bzw. 25% betragen.
- Folds (Teilmengen): Die Trainingsdaten werden anschließend zufällig in gleich große Folds (Teile) aufgeteilt. Im folgenden Beispiel werden 5 Folds erstellt. Das Modell wird auf 4 davon trainiert und auf dem letzten Fold getestet (auf dem das Modell nicht trainiert wurde).
- Repeats (Durchgänge): Das Vorgehen aus Schritt 2 wird wiederholt, wobei nun 5 neue Folds zufällig gebildet werden. Wie in Schritt 2 erfolgt das Training auf 4 davon, und der Test wird auf dem letzten Fold durchgeführt.
Die folgende Abbildung zeigt eine Kreuzvalidierung mit 5 Folds, die 5-mal wiederholt wird. In der Praxis kann es sich lohnen, 10 Wiederholungen (Durchgänge) durchzuführen. Ziel der Kreuzvalidierung ist es, bereits in den Trainingsdaten das beste Modell zu identifizieren, indem (in jedem Durchgang) nicht alle Trainingsdaten für das Training verwendet werden. So können wir verschiedene Modelltypen evaluieren und für jedes Modell zusätzlich verschiedene Spezifikationen prüfen. Handelt es sich bei dem Modell um eine logistische Regression, können wir Regressionen mit und ohne Interaktionen, Spline-Funktionen oder andere Transformationen der Prädiktoren evaluieren. Dasselbe gilt für Machine Learning. Das bedeutet, dass wir in diesem Schritt die optimalen Parameter identifizieren können.
Das beste Modell kann anschließend auf die gesamten Trainingsdaten angewendet werden, um die Parameter erneut zu schätzen, sowie auf die Testdaten, um die Präzision des Modells auf neuen und künftigen Daten zu evaluieren.
Maße für die Vorhersagekraft des Modells (Evaluation metrics)
Um Modelle mittels Kreuzvalidierung (oder anderer Methoden) zu vergleichen, muss ein Präzisionsmaß verwendet werden. Es gibt eine Reihe verschiedener Maße, und welches für eine bestimmte Fragestellung optimal ist, variiert. Es gibt jedoch Faustregeln, die in den meisten Zusammenhängen angemessen sind. Diese werden im nächsten Kapitel besprochen.