In diesem Kapitel verwenden wir tidymodels, um verschiedene Modelle in einem Arbeitsablauf (Workflow) zu erstellen und zu vergleichen. Wie im vorigen Kapitel optimieren wir die Modelle mittels Kreuzvalidierung. Folgendes wird durchgeführt:
- Alle Modelle werden durch Resampling (Kreuzvalidierung) evaluiert.
- Zwei verschiedene Rezepte werden evaluiert.
- Drei verschiedene Modelle werden evaluiert.
- Bei zwei der Modelle werden die Hyperparameter optimiert. Bei einem der Modelle geschieht dies durch manuelle Definition eines Grids (Kombination von Hyperparametern). Beim anderen Modell lassen wir R das Grid erstellen.
Wir beginnen damit, die benötigten Packages zu laden und Daten aus einer Studie an Patienten mit Kolonkarzinom (Dickdarmkrebs) bereitzustellen.
library(tidyverse) # für die Datenverarbeitung
library(tidymodels) # Basis-Package für die Vorhersagemodellierung
library(dials) # zur Optimierung von Hyperparametern
library(finetune) # zusätzliche Funktionen zur Optimierung von Hyperparametern
Die Daten für diese Übung stammen aus dem Package survival, das Daten zu Personen mit Kolonkarzinom enthält. Wir laden survival sowie alle Datensätze mit Krebsstudien. Anschließend inspizieren wir colon, also die Daten, mit denen wir arbeiten werden.
library(survival)
data(cancer) # alle Datensätze mit Krebsstudien laden
head(colon, 10) # die ersten 10 Zeilen der Studie zum Kolonkarzinom inspizieren
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1In colon gibt es die Spalte status, die den Endpunkt der Studie darstellt. Der Wert 1 bedeutet, dass der Patient verstorben ist, der Wert 0, dass der Patient überlebt hat. Wie im vorigen Kapitel modifizieren wir die colon-Daten mit den folgenden Schritten:
- Wir kodieren
statusvon1inYesund von0inNoum und machen die Variable mit der Funktionrecode_factor()zu einem Faktor. - Wir kodieren
sexso um, dass dort Kvinna (Frau) und Man (Mann) statt 0 bzw. 1 steht. - Wir entfernen die Spalten
time,idundstudy, da wir sie in unserem Modell nicht verwenden. - Variablen mit
0/1werden auf geschickte Weise mitmutate(across())inNo/Yesumkodiert. Beachten Sie, dass wir mitacross()mehrere Spalten auswählen können, auf die die Funktionrecode_factor()angewendet werden soll; die jeweilige Spalte wird in der Funktion anschließend durch.xrepräsentiert. Siehe Zeile 5 unten.
colon2 <- colon |>
  mutate(status = recode_factor(status, "1"="Yes", "0"="No"),
         sex = recode_factor(sex, "0"="Kvinna", "1"="Man")) |>
  select(-time, -id, -study) |>
  mutate(across(c(obstruct, adhere, perfor, surg, node4), ~recode_factor(.x, "0"="No", "1"="Yes")))

## Daten inspizieren
head(colon2, 10)
rx sex age obstruct perfor adhere nodes status differ extent surg node4 etype
1 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 2
2 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 1
3 Lev+5FU Man 63 No No No 1 No 2 3 No No 2
4 Lev+5FU Man 63 No No No 1 No 2 3 No No 1
5 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 2
6 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 1
7 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 2
8 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 1
9 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 2
10 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 1Fehlende Daten erfassen und imputieren
Als Nächstes untersuchen wir das Vorkommen fehlender Daten (Missing Data) in colon2. Dazu verwenden wir die Funktion vis_miss() aus dem Package visdat:
library(visdat)
vis_miss(colon2)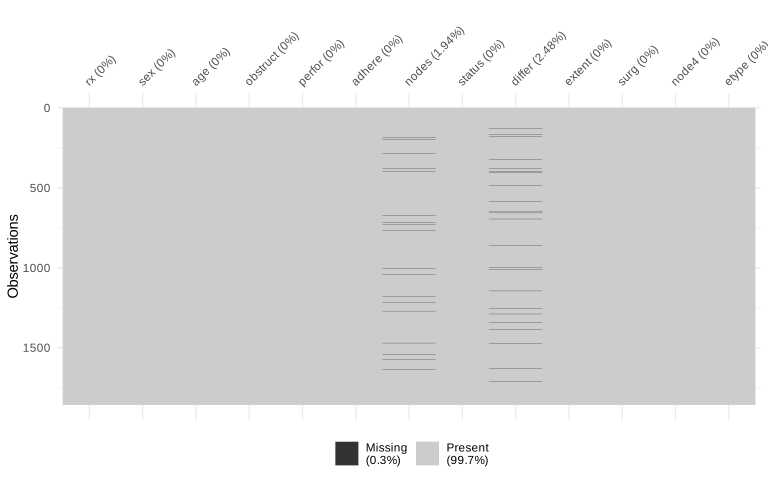
Wie das Ergebnis oben zeigt, erhalten wir eine Abbildung, in der die Spalten und Zeilen von colon2 in einem Rechteck visualisiert werden. Es zeigt sich, dass insgesamt 0,3 % aller Werte in colon2 fehlen. Obwohl dies ein ungewöhnlich niedriger Anteil ist, imputieren wir diese Werte dennoch mit der Funktion missRanger() aus dem gleichnamigen Package. Das Ergebnis übergeben wir an colon3, das nun ein Data Frame ohne fehlende Daten ist (alle fehlenden Werte wurden imputiert).
library(missRanger)
colon3 <- missRanger(data=colon2, maxiter=10, pmm.k = 5)

vis_miss(colon3)
Trainingsdaten, Testdaten und Resampling (Kreuzvalidierung) erstellen
Wir teilen colon3 nun in Trainingsdaten (70 % der Daten) und Testdaten (30 %) auf. Da die Studie das Ereignis Tod untersucht, stratifizieren wir die Aufteilung nach dem Endpunkt (strata=status), sodass der Anteil der Verstorbenen in Trainings- und Testdaten gleich groß ist.
## Erstellt Trainingsdaten und Testdaten, zuerst mit set.seed()
set.seed(1)

colon_split <- initial_split(colon3, strata=status, prop=0.7)
colon_train <- training(colon_split)
colon_test  <- testing(colon_split)

## Erstellt die Kreuzvalidierung der Trainingsdaten
my_cross_validation <- vfold_cv(colon_train,
                                v = 5,
                                repeats=10,
                                strata = status)
Beachten Sie, dass wir set.seed(1) angegeben haben; dadurch wird der Einfluss des Zufalls bei der Erzeugung von Test- und Trainingsdaten ausgeschaltet. Somit können wir bei jeder Verwendung von initial_split() exakt dieselben Beobachtungen in Trainings- und Testdaten erzeugen. Das kann wünschenswert sein, um exakt reproduzierbare Ergebnisse zu erhalten.
Rezepte erstellen
Wir erstellen zwei Rezepte. Das erste Rezept nennen wir base_recept. Den Kommentaren im Code unten können Sie entnehmen, welche Preprocessing-Schritte durchgeführt werden. Das zweite Rezept heißt extended_recipe; es baut auf base_recept auf, enthält aber zusätzlich step_pca(). Falls Sie mit der Methode PCA nicht vertraut sind, genügt es vorerst festzuhalten, dass PCA ein Verfahren ist, das die Anzahl numerischer Prädiktoren reduziert, was mitunter zu besseren Modellen führt.
## Grundrezept
base_recipe <- recipe(status ~ ., data=colon_train) |>
  # Normalisierung numerischer Prädiktoren
  step_normalize(all_numeric()) |>
  # Erstellt Dummy-Variablen aus kategorialen Variablen
  step_dummy(all_nominal_predictors()) |>
  # Schafft Toleranz für neue Variablenausprägungen in den Testdaten
  step_novel(all_nominal_predictors())

## Erweitertes Rezept auf Basis von base_recipe
extended_recipe <-
  base_recipe |>
  step_pca(all_numeric_predictors())
Modelle erstellen
Wir erstellen drei Modelle mit folgenden Einstellungen:
Logistische Regression.
- Hyperparameter: keine.
- Methode: GLM (gewöhnliche logistische Regression)
Random Forest.
Hyperparameter: 2. Wir erstellen unser Grid manuell mit der Funktion
crossing().Methode: Ranger-Package.
Xtreme Gradient Boosting.
- Hyperparameter: 8. Wir erstellen unser Grid mit der Funktion
grid_latin_hypercube()., die ausgehend von der Anzahl zulässiger Kombinationen (size=n) maximiert, welche Kombinationen untersucht werden. - Methode: Ranger-Package.
- Hyperparameter: 8. Wir erstellen unser Grid mit der Funktion
## 1. LOGISTISCHE REGRESSION =====================================
glm_spec <-
  logistic_reg() %>%
  set_engine('glm') %>%
  set_mode('classification')

## 2. RANDOM FOREST ============================================
rf_spec <- rand_forest(mtry = tune(),
                       trees = tune()) |>
  set_engine("ranger") |>
  set_mode("classification")

## Mit der Funktion crossing() wird ein Grid manuell erstellt.
## Manuell angeben, welche Werte für jeden Parameter getestet werden sollen
rf_grid <- crossing(mtry = c(3, 6, 9),
                    trees=c(100, 200))

## 3. XTREME GRADIENT BOOSTING ================================
## Modell definieren
xgb_spec <-
  boost_tree(tree_depth = tune(),
             mtry = tune(),
             trees = tune(),
             learn_rate = tune(),
             min_n = tune(),
             loss_reduction = tune(),
             sample_size = tune(),
             stop_iter = tune()) %>%
  set_engine('xgboost') %>%
  set_mode('classification')

## Ein Grid mit grid_latin_hypercube() erstellen
xgb_grid <- grid_latin_hypercube(
  trees(),
  min_n(),
  learn_rate(),
  loss_reduction(),
  tree_depth(),
  sample_prop(),
  stop_iter(),
  finalize(mtry(), colon_train),
  size = 10)
Workflow erstellen
Wir erstellen nun mit der Funktion workflow_set() eine Sammlung von Workflows. Dabei werden zwei Listen angelegt. Die erste Liste ist preproc; dort werden die Rezepte angegeben. Das nächste Argument ist models; dort werden die Modelle angegeben. Das Argument cross wird auf TRUE gesetzt, da alle Modelle mit allen Rezepten getestet werden sollen.
Wir müssen unsere Grids mit der Funktion option_add() zu unserem Workflow hinzufügen. Dabei wird angegeben, welches Grid zu welchem Workflow hinzugefügt werden soll. Wie unten ersichtlich, setzt sich der Name jedes Workflows aus seinem Preprocessor und seinem Modell zusammen, getrennt durch einen Unterstrich (zum Beispiel base_xgb).
my_wf <-
   workflow_set(
      preproc = list(base = base_recipe,
                     extended = extended_recipe),
      models = list(glm = glm_spec,
                    rf = rf_spec,
                    xgb = xgb_spec),
      cross = TRUE
   ) %>%
   # Fügt eine bestimmte Grid Search zu einem bestimmten Workflow hinzu
   option_add(id = "base_xgb",     grid = xgb_grid) %>%
   option_add(id = "extended_xgb", grid = xgb_grid) %>%
   option_add(id = "base_rf",      grid = rf_grid) %>%
   option_add(id = "extended_rf",  grid = rf_grid)
Modelle ausführen
Zum Ausführen der Modelle verwenden wir Parallelisierung, das heißt, wir nutzen nach Möglichkeit mehrere Kerne des Computers. Die Parallelisierung erfordert die Packages doParallel und parallel. Das Package tictoc dient dazu, die Zeit zu messen, die für die Ausführung aller Modelle benötigt wird.
Denken Sie daran, nicht alle Kerne Ihres Computers zu verwenden. Lassen Sie stets 2 Kerne für andere Prozesse des Computers frei. Im folgenden Beispiel hat der Computer 8 Kerne, daher werden 6 Kerne für die Berechnungen verwendet. Die Anzahl der Kerne wird mit der Funktion makePSOCKcluster() festgelegt.
library(doParallel)
library(parallel)
library(tictoc)

## Parallelisierung starten
mitt_kluster <- makePSOCKcluster(6)
registerDoParallel(mitt_kluster)
tic()

## Modelle ausführen
my_wf_results <-
   workflow_map(object=my_wf,
                "tune_grid",
                seed = 1,
                resamples = my_cross_validation,
                metrics = yardstick::metric_set(roc_auc),
                verbose = TRUE,
                control   = control_grid(save_pred = TRUE,
                           parallel_over = "everything",
                           save_workflow = TRUE)
                )

## Parallelisierung beenden
stopCluster(mitt_kluster)
toc()
i No tuning parameters. `fit_resamples()` will be attempted
i 1 of 6 resampling: base_glm
✔ 1 of 6 resampling: base_glm (24.4s)
i 2 of 6 tuning: base_rf
✔ 2 of 6 tuning: base_rf (2m 52.9s)
i 3 of 6 tuning: base_xgb
✔ 3 of 6 tuning: base_xgb (6m 40.6s)
i No tuning parameters. `fit_resamples()` will be attempted
i 4 of 6 resampling: extended_glm
✔ 4 of 6 resampling: extended_glm (11.6s)
i 5 of 6 tuning: extended_rf
✔ 5 of 6 tuning: extended_rf (3m 51.6s)
i 6 of 6 tuning: extended_xgb
✔ 6 of 6 tuning: extended_xgb (17m 25.1s)
1893.746 sec elapsedDer Durchlauf dauerte 1893 Sekunden.
Modelle vergleichen
Mit der Funktion autoplot() erhalten wir einen schnellen Überblick darüber, wie gut die Modelle den Endpunkt vorhersagen, gemessen an dem gewählten Gütemaß (AUC ROC).
autoplot(my_wf_results)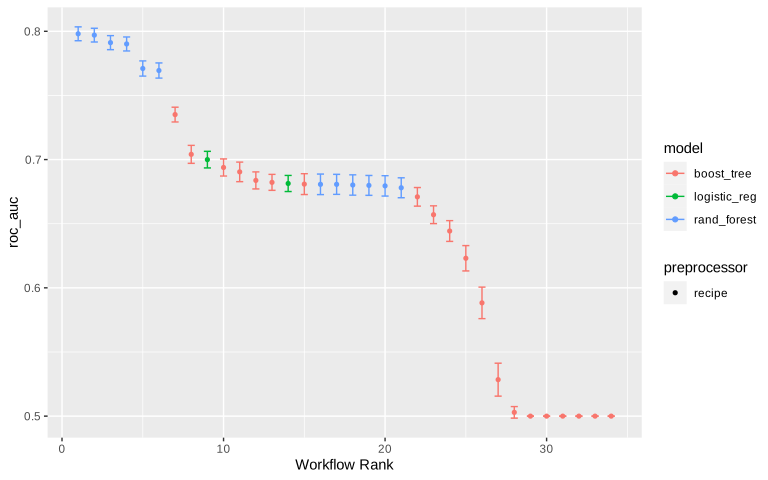
Die besten Modelle können wir mit folgendem Code extrahieren
rank_results(my_wf_results,
             rank_metric = "roc_auc",
             select_best = TRUE) %>%
   select(rank, mean, model, wflow_id, .config)
rank mean model wflow_id .config
<int> <dbl> <chr> <chr> <chr>
1 1 0.798 rand_forest base_rf Preprocessor1_Model6
2 2 0.735 boost_tree base_xgb Preprocessor1_Model01
3 3 0.700 logistic_reg base_glm Preprocessor1_Model1
4 4 0.694 boost_tree extended_xgb Preprocessor1_Model02
5 5 0.681 logistic_reg extended_glm Preprocessor1_Model1
6 6 0.681 rand_forest extended_rf Preprocessor1_Model1Das beste Modell ist der Random Forest mit dem Grundrezept (base_rf). Die beste Konfiguration heißt Preprocessor1_Model6.
Um zu sehen, um welche Konfiguration es sich handelt, schreiben wir:
best_model <- my_wf_results %>%
  extract_workflow_set_result("base_rf") %>%
  select_best(metric = "roc_auc")

best_model
mtry trees .config
9 200 Preprocessor1_Model6Das Modell hat mtry = 9 und trees = 200.
Zur Erinnerung: Das Training erfolgte mit Kreuzvalidierung, sodass das Modell nie auf allen Trainingsdaten trainiert wurde (ein Fold wurde jeweils zum Testen des Modells verwendet, siehe Kreuzvalidierung). Das beste Modell wird daher ein letztes Mal auf allen Trainingsdaten trainiert:
my_finalized_wf <-
  my_wf_results |>
  extract_workflow("base_rf") |>
  finalize_workflow(best_model) |>
  last_fit(split = colon_split,
           metrics = yardstick::metric_set(roc_auc))
Das Objekt my_finalized_wf enthält das endgültige Modell. Mit der Funktion collect_metrics() können wir Informationen darüber extrahieren, wie gut das Modell auf den Testdaten abschneidet. Beachten Sie, dass wir die Testdaten nicht angeben müssen, da tidymodels die Testdaten automatisch verwendet (das Objekt my_finalized_wf hat Zugriff auf die Testdaten, weil wir oben split=colon_split angegeben haben).
collect_metrics(my_finalized_wf) .metric .estimator .estimate .config
roc_auc binary 0.792 Preprocessor1_Model1Die Fläche unter der ROC-Kurve beträgt 0,793.
Wir können nun die Vorhersagen selbst betrachten, indem wir die Funktion collect_predictions() verwenden:
pred_data <- collect_predictions(my_finalized_wf## A tibble: 558 × 6
id .pred_Yes .pred_No .row status .config
<chr> <dbl> <dbl> <int> <fct> <chr>
1 train/test split 0.873 0.127 2 Yes Preprocessor1_Model1
2 train/test split 0.0959 0.904 4 No Preprocessor1_Model1
3 train/test split 0.559 0.441 8 Yes Preprocessor1_Model1
4 train/test split 0.578 0.422 13 Yes Preprocessor1_Model1
5 train/test split 0.560 0.440 14 Yes Preprocessor1_Model1
6 train/test split 0.327 0.673 20 No Preprocessor1_Model1
7 train/test split 0.292 0.708 21 No Preprocessor1_Model1
8 train/test split 0.333 0.667 22 No Preprocessor1_Model1
9 train/test split 0.454 0.546 30 No Preprocessor1_Model1
10 train/test split 0.605 0.395 32 Yes Preprocessor1_Model1Die ROC-Kurve wird mit folgendem Code erstellt:
pred_data %>%
  roc_curve(status, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal() +
  theme_bw()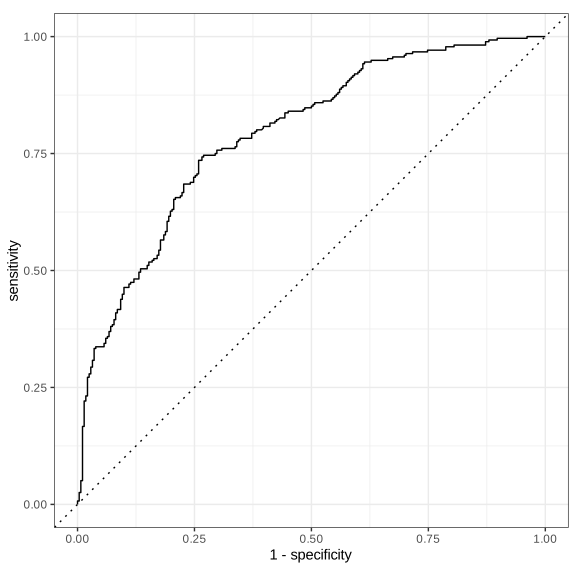
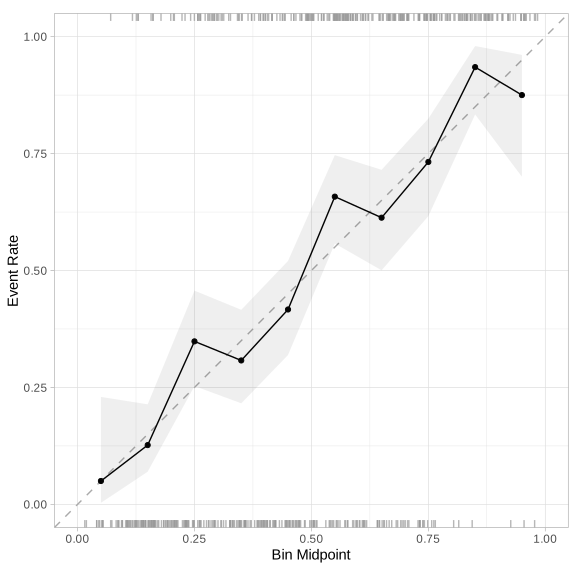
Um zu klären, ob das Modell gut kalibriert ist, verwenden wir die Funktion cal_plot_breaks() aus dem Package probably. Beachten Sie, dass diese Funktion die Entwicklungsversion von probably voraussetzt. Diese wird mit folgendem Befehl installiert:
install.packages("remotes")
remotes::install_github("tidymodels/probably")
library(probably)

pred_data %>%
  cal_plot_breaks(status, .pred_Yes)