
In diesem Kapitel verwenden wir tidymodels, um einen vollständigen Arbeitsablauf zu erstellen, der die Wahl des Prädiktionsmodells, die Optimierung der Hyperparameter mittels Kreuzvalidierung sowie die Auswahl und Evaluation des besten Modells umfasst. Zunächst laden wir mit den folgenden Befehlen drei Packages:
## tidymodels für die Prädiktionsmodellierung laden
library(tidymodels)

## tidyverse für die Datenaufbereitung laden
library(tidyverse)

## vip laden, um die Variable Importance zu extrahieren
library(vip)
Die Daten für diese Übung stammen aus dem Package survival, das Daten zu Personen mit Kolonkarzinom enthält. Wir laden survival sowie alle Datensätze mit Krebsstudien. Anschließend inspizieren wir colon, also die Daten, mit denen wir arbeiten werden.
## Das survival-Package laden
library(survival)

## Alle Datensätze mit Krebsstudien laden
data(cancer)

## Die ersten 10 Zeilen der Studie zum Kolonkarzinom inspizieren
head(colon, 10)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1In colon gibt es die Spalte status, die den Endpunkt der Studie darstellt. Der Wert 1 zeigt an, dass der Patient verstorben ist, und der Wert 0, dass der Patient überlebt hat. Wir modifizieren die colon-Daten in den folgenden Schritten:
- Wir kodieren
status1inYesund0inNoum und machen die Variable mit der Funktionrecode_factor()zu einem Faktor. - Wir kodieren
sexso um, dass dort Kvinna und Man statt 0 bzw. 1 steht. - Wir entfernen die Spalten
time,idundstudy, da wir sie in unserem Modell nicht verwenden werden. - Variablen mit
0/1werden auf geschickte Weise mitmutate(across())inNo/Yesumkodiert. Beachten Sie, dass wir mitacross()mehrere Spalten auswählen können, auf die wir die Funktionrecode_factor()anwenden möchten; die jeweilige Spalte wird dann in der Funktion durch.xrepräsentiert. Siehe Zeile 5 unten.
colon2 <- colon |>
  mutate(status = recode_factor(status, "1"="Yes", "0"="No"),
         sex = recode_factor(sex, "0"="Kvinna", "1"="Man")) |>
  select(-time, -id, -study) |>
  mutate(across(c(obstruct, adhere, perfor, surg, node4), ~recode_factor(.x, "0"="No", "1"="Yes")))

## Daten inspizieren
head(colon2, 10)
rx sex age obstruct perfor adhere nodes status differ extent surg node4 etype
1 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 2
2 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 1
3 Lev+5FU Man 63 No No No 1 No 2 3 No No 2
4 Lev+5FU Man 63 No No No 1 No 2 3 No No 1
5 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 2
6 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 1
7 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 2
8 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 1
9 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 2
10 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 1Beachten Sie, dass wir von nun an colon2 verwenden.
Trainingsdaten, Testdaten und Resampling (Kreuzvalidierung) erstellen
Wir teilen colon2 nun in Trainingsdaten (70 % der Daten) und Testdaten (30 %) auf. Da die Studie das Ereignis Tod untersucht, stratifizieren wir die Aufteilung, sodass der Anteil der Verstorbenen in Trainings- und Testdaten gleich groß ist. Das ist wünschenswert, damit das Modell unter realistischen Bedingungen trainiert und getestet wird. Bei vielen Beobachtungen ist der Anteil der Verstorbenen in Trainings- und Testdaten mit hoher Wahrscheinlichkeit ohnehin gleich groß (da Trainings- und Testdaten vollständig zufällig gebildet werden). Diese Funktion ist daher besonders nützlich, wenn die Zahl der Beobachtungen gering ist; sie stellt dann sicher, dass die Zufallsauswahl in Trainings- und Testdaten gleich große Anteile an Todesfällen aufweist.
## Trainingsdaten und Testdaten erstellen, zuerst mit set.seed()
set.seed(1)
colon_split <- initial_split(colon2, strata=status, prop=0.7)
colon_train <- training(colon_split)
colon_test  <- testing(colon_split)

## Kreuzvalidierung der Trainingsdaten erstellen
my_cross_validation <- vfold_cv(colon_train,
                                v = 5,
                                repeats=10,
                                strata = status)
Beachten Sie außerdem, dass wir set.seed(1) angegeben haben, was man auf Deutsch als Setzen eines Startwerts (Seed) bezeichnet. Setzt man in diesem Zusammenhang einen Seed, schaltet man den Zufall in der Funktion aus, die nach set.seed() ausgeführt wird. In diesem Fall bedeutet das lediglich, dass wir bei jeder Wiederholung der Aufteilung exakt dieselben Beobachtungen in Trainings- und Testdaten erhalten. Das ist wünschenswert, um reproduzierbare Ergebnisse zu erhalten. Sie können in set.seed() eine beliebige Zahl verwenden.
Resampling bedeutet, dass dieselbe Datenmenge wiederholt verwendet wird, um ein Modell zu trainieren und zu evaluieren. Hier wird eine Form des Resamplings verwendet, die als Kreuzvalidierung bezeichnet wird (siehe Kreuzvalidierung). Die Kreuzvalidierung erfolgt in den Trainingsdaten mithilfe der Funktion vfold_cv(), die die Trainingsdaten zufällig in 5 gleich große Teile (Folds) aufteilt; jedes Modell wird in allen Folds außer einem trainiert, und dieser eine Fold dient zum Testen des Modells. Dies wird für jedes Modell 10-mal wiederholt (repeats=10), sodass alle Modelle in zufällig gewählten Teilen der Trainingsdaten trainiert und evaluiert werden. Das Modell, das in der Kreuzvalidierung am besten abschneidet, ist mit größter Wahrscheinlichkeit auch auf den Testdaten das beste (und damit das beste Modell).
Ein Modell und eine Methode spezifizieren
Im nächsten Schritt spezifizieren wir ein Modell, nämlich Extreme Gradient Boosting (XGBoost). Dazu verwenden wir die Funktion boost_tree(), in der sämtliche Hyperparameter auf tune() gesetzt werden; das bedeutet, dass sie mittels Resampling optimiert werden sollen. Die Methode spezifizieren wir mit set_engine() und die Art der Prädiktion mit set_mode(). Anschließend geben wir das Modellobjekt (xgb_spec) aus.
xgb_spec <-
  boost_tree(mtry = tune(),
             tree_depth = tune(),
             trees = tune(),
             learn_rate = tune(),
             min_n = tune(),
             loss_reduction = tune(),
             sample_size = tune(),
             stop_iter = tune()) |>
  set_engine('xgboost') |>
  set_mode('classification')

xgb_spec
Boosted Tree Model Specification (classification)
Main Arguments:
trees = tune()
min_n = tune()
tree_depth = tune()
learn_rate = tune()
loss_reduction = tune()
sample_size = tune()
stop_iter = tune()
Computational engine: xgboostDie Hyperparameter in xgboost sind folgende:
- mtry: Die Anzahl der Prädiktoren, die bei jeder Aufteilung (Split) während der Erstellung der Baummodelle zufällig gezogen werden.
- trees: Die Anzahl der Bäume im Ensemble. Standard: 15.
- min_n: Die Mindestanzahl an Datenpunkten in einem Knoten, die erforderlich ist, damit der Knoten weiter aufgeteilt wird. Standard: 1.
- tree_depth: Die maximale Tiefe des Baums (d. h. Anzahl der Splits). Standard: 6.
- learn_rate: Die Rate, mit der sich der Boosting-Algorithmus von Iteration zu Iteration anpasst. Standard: 0,3.
- loss_reduction: Die Verringerung der Verlustfunktion, die für eine weitere Aufteilung erforderlich ist. Typ: double, Standard: 0,0.
- sample_size: Der Anteil der Daten, der dem Anpassungsverfahren zugeführt wird. Typ: double, Standard: 1,0.
- stop_iter: Die Anzahl der Iterationen ohne Verbesserung, nach denen abgebrochen wird. Typ: integer, Standard: Inf.
Grid Search
Im nächsten Schritt definieren wir eine Matrix mit Kombinationen von Hyperparametern. Solche Matrizen werden als Grid bezeichnet. Ziel der Kreuzvalidierung ist es, diese Matrix nach dem besten Modell zu durchsuchen, was als Grid Search bezeichnet wird. Ein Grid lässt sich mit verschiedenen Funktionen erstellen, darunter grid_latin_hyperube(). Diese Funktion erzeugt Kombinationen, die, abhängig von der Anzahl zugelassener Kombinationen, einen „möglichst großen Bereich“ abdecken.
xgb_grid <- grid_latin_hypercube(
  trees(),
  min_n(),
  learn_rate(),
  loss_reduction(),
  tree_depth(),
  sample_prop(),
  stop_iter(),
  finalize(mtry(), colon_train),
  size = 20)
Unser Grid umfasst insgesamt 50 verschiedene Kombinationen von Hyperparametern (size=50), d. h., wir testen 50 verschiedene Modelle. Beachten Sie, dass der Parameter mtry (Anzahl der Variablen) in der Funktion finalize() spezifiziert wird; das liegt daran, dass mtry nicht jeden beliebigen Wert annehmen kann (die Anzahl der Spalten könnte zu gering sein).
xgb_grid trees min_n learn_rate loss_reduction tree_depth sample_size stop_iter mtry
<int> <int> <dbl> <dbl> <int> <dbl> <int> <int>
1 55 24 4.15e- 2 2.28e- 2 6 0.358 14 10
2 413 32 1.35e- 5 5.05e- 6 14 0.887 17 7
3 1843 33 7.88e- 3 2.08e- 8 2 0.491 15 7
4 1214 27 9.13e- 8 1.57e- 3 4 0.227 10 5
5 1495 26 3.26e-10 5.35e- 7 4 0.596 15 6
6 476 20 5.08e-10 1.33e- 8 13 0.828 11 2
7 1117 8 5.41e- 3 2.92e- 7 8 0.731 17 12
8 351 4 3.27e- 4 2.31e- 9 10 0.864 12 12
9 310 35 9.31e- 9 1.98e+ 1 13 0.809 12 4
10 1450 40 1.34e- 6 2.03e-10 9 0.245 4 13
11 1269 35 1.13e- 8 4.29e- 1 4 0.615 4 7
12 990 22 8.24e- 2 2.13e- 5 11 0.532 8 2
13 128 23 5.87e-10 3.18e- 9 10 0.786 18 9
14 1347 13 5.02e- 9 8.81e- 2 12 0.722 7 9
15 94 38 6.35e- 7 9.03e- 5 7 0.168 5 4
16 1745 21 9.00e- 3 3.48e- 4 3 0.385 14 5
17 1791 6 1.93e- 4 1.23e- 6 10 0.413 3 12
18 1399 15 2.79e- 7 3.69e- 5 5 0.675 9 10
19 672 12 6.34e- 5 9.73e- 1 6 0.777 14 1
20 1531 12 2.25e-10 4.90e+ 0 3 0.266 15 11
21 893 19 1.54e- 6 1.15e+ 1 9 0.539 6 10
22 264 36 5.98e- 8 3.36e+ 0 14 0.208 10 8
23 233 38 1.25e- 9 2.41e- 3 9 0.998 6 3
24 1657 10 1.40e- 3 7.56e- 8 3 0.315 19 5
25 928 6 2.55e- 9 7.20e- 1 6 0.338 13 8
26 1418 33 2.85e- 4 1.40e- 7 1 0.970 11 6
27 1059 7 1.71e- 8 2.38e- 6 7 0.709 8 1
28 835 30 3.09e- 6 5.97e-10 8 0.131 3 8
29 162 9 2.75e- 8 1.66e-10 13 0.759 16 6
30 519 2 9.92e- 5 4.33e- 3 6 0.427 11 11
31 1153 23 3.08e- 5 1.07e- 4 13 0.922 7 2
32 1966 5 7.63e- 6 1.85e+ 0 2 0.398 8 10
33 1171 18 3.14e- 9 3.13e-10 12 0.652 9 1
34 1312 28 9.25e-10 2.25e- 4 12 0.576 13 3
35 590 20 5.51e- 5 1.34e- 9 15 0.189 18 6
36 699 25 3.85e- 8 1.04e- 2 8 0.289 13 11
37 389 14 5.52e- 2 7.44e- 6 7 0.474 16 11
38 1632 3 6.07e- 6 1.62e- 6 2 0.893 10 12
39 614 27 8.39e- 4 3.97e- 2 11 0.115 12 13
40 1011 16 4.35e- 7 1.07e+ 1 11 0.505 19 6
41 530 16 4.86e- 4 6.27e- 9 5 0.211 7 3
42 869 39 2.56e- 3 2.60e- 7 14 0.557 19 8
43 1821 16 2.37e- 7 2.43e- 1 9 0.678 20 4
44 799 29 4.12e- 6 1.63e- 2 5 0.935 6 3
45 1916 31 2.44e- 5 9.56e- 2 4 0.136 20 4
46 32 11 2.04e- 2 4.02e- 8 12 0.964 5 7
47 1713 8 1.74e- 7 6.99e- 9 15 0.838 9 3
48 1945 36 1.66e- 2 1.35e- 5 3 0.640 5 9
49 1567 18 1.50e-10 4.94e- 4 2 0.457 17 8
50 740 29 1.93e- 3 1.16e- 3 8 0.318 18 11Ein Rezept erstellen
Im nächsten Schritt erstellen wir ein Rezept, in dem wir den Endpunkt der Studie sowie die zu verwendenden Prädiktoren definieren. Außerdem legen wir fest, welche Preprocessing-Schritte durchgeführt werden sollen. Siehe die erläuternden Kommentare.
xgb_recipe <- recipe(status ~ ., data=colon_train) |>
  # step_normalize normalisiert alle kontinuierlichen Prädiktoren
  step_normalize(all_numeric()) |>
  # step_dummy erstellt Dummy-Variablen aus allen kategorialen Variablen. Dies ist für xgboost erforderlich
  step_dummy(all_nominal_predictors()) |>
  # step_novel ist eine Methode, die benötigt wird, um den Fall zu behandeln, dass
  # die Testdaten Ausprägungen kategorialer Variablen enthalten, die in den Trainingsdaten nicht vorkamen
  step_novel(all_nominal_predictors())
Einen Workflow erstellen
Anschließend erstellen wir einen Workflow mit dem Rezept und dem Modell:
xgb_wf <- workflow() |>
  add_recipe(xgb_recipe) |>
  add_model(xgb_spec)

xgb_wf
══ Workflow ═══════════════════════════════════════════════════════════════════════════════════════════
Preprocessor: Recipe
Model: boost_tree()
── Preprocessor ───────────────────────────────────────────────────────────────────────────────────────
3 Recipe Steps
• step_normalize()
• step_dummy()
• step_novel()
── Model ──────────────────────────────────────────────────────────────────────────────────────────────
Boosted Tree Model Specification (classification)
Main Arguments:
mtry = tune()
trees = tune()
min_n = tune()
tree_depth = tune()
learn_rate = tune()
loss_reduction = tune()
sample_size = tune()
stop_iter = tune()
Computational engine: xgboostDie Modelle trainieren
Danach erfolgt das Training (d. h., die Modelle werden erstellt). Beachten Sie das Argument metrics = yardstick::metric_set(roc_auc): Es bedeutet, dass wir aus dem Package yardstick die Funktion metric_set verwenden und sie auf roc_auc (Fläche unter der ROC-Kurve) setzen. Zum Vergleich der Modelle wird somit die Fläche unter der ROC-Kurve herangezogen.
xgb_res <- tune_grid(
  xgb_wf,
  resamples = my_cross_validation,
  grid      = xgb_grid,
  metrics   = yardstick::metric_set(roc_auc),
  control   = control_grid(save_pred = TRUE,
                           parallel_over = "everything",
                           save_workflow = TRUE))
Das Training parallelisieren
Wenn Sie den obigen Schritt beschleunigen möchten, können Sie die Ausführung auf mehrere Prozessorkerne des Rechners parallelisieren. Dazu dienen die Packages parallell und doParallell. Um die Laufzeit zu messen, verwenden wir das Package tictoc. Der Code für eine parallelisierte Berechnung auf 6 Kernen lautet wie folgt:
## Packages laden (vergessen Sie nicht, die Packages zu installieren)
library(tictoc)
library(parallel)
library(doParallel)

## Einen Cluster in R mit 6 Kernen erstellen, damit die Ausführung auf 6 Kernen erfolgt
mitt_kluster <- makePSOCKcluster(6)

## Ihren Cluster aktivieren
registerDoParallel(mitt_kluster)

## Die Uhr starten
tic()

## Die Berechnung ausführen
xgb_res <- tune_grid(
  xgb_wf,
  resamples = my_cross_validation,
  grid      = xgb_grid,
  metrics   = yardstick::metric_set(roc_auc),
  control   = control_grid(save_pred = TRUE,
                           parallel_over = "everything",
                           save_workflow = TRUE))

## Den Cluster stoppen
stopCluster(mitt_kluster)

## Die Uhr stoppen
toc()
Die Modelle evaluieren
Die Ergebnisse werden anschließend mit der Funktion collect_metrics() inspiziert. Sie erstellt eine Tabelle mit Informationen zu den Hyperparametern jedes Modells sowie zu dessen Ergebnissen in der Kreuzvalidierung. Die Spalte mean zeigt die mittlere ROC AUC während der Kreuzvalidierung. Wir sortieren alle Modelle nach absteigender ROC AUC (das beste Modell steht ganz oben):
collect_metrics(xgb_res) %>% arrange(desc(mean)) mtry trees min_n tree_depth learn_rate loss_reduct…¹ sampl…² stop_…³ .metric .esti…⁴ mean n std_err
1 12 985 8 6 0.0719 9.45e- 7 0.695 4 roc_auc binary 0.743 50 0.00337
2 6 1713 2 2 0.0432 2.83e-10 0.517 7 roc_auc binary 0.733 50 0.00323
3 2 794 5 3 0.0567 4.73e- 7 0.904 14 roc_auc binary 0.732 50 0.00334
4 6 716 5 9 0.000956 1.62e- 2 0.880 9 roc_auc binary 0.727 50 0.00399
5 9 159 6 5 0.00270 2.68e- 6 0.796 16 roc_auc binary 0.712 50 0.00411
6 4 1394 9 13 0.000000417 1.68e- 9 0.862 13 roc_auc binary 0.707 50 0.00425
7 1 447 4 15 0.0000679 2.17e+ 0 0.986 7 roc_auc binary 0.705 50 0.00383
8 6 857 12 7 0.00000888 1.19e-10 0.745 12 roc_auc binary 0.704 50 0.00430
9 9 1207 12 4 0.000126 3.87e- 2 0.946 6 roc_auc binary 0.698 50 0.00415
10 10 1280 14 12 0.00000152 1.17e- 8 0.666 6 roc_auc binary 0.695 50 0.00452
## … with 40 more rows, and abbreviated variable names ¹loss_reduction, ²sample_size, ³stop_iter, ⁴.estimator
## ℹ Use `print(n = ...)` to see more rowsUm zu untersuchen, wie sich die verschiedenen Hyperparameter auf die ROC-AUC ausgewirkt haben, schreiben wir den folgenden, recht komplexen Code:
xgb_res_plot <-
  xgb_res |>
  collect_metrics() |>
  filter(.metric == "roc_auc") |>
  select(mean, mtry:sample_size) |>
  pivot_longer(mtry:sample_size,
               values_to = "value",
               names_to = "parameter") |>
  ggplot(aes(value, mean, color = parameter)) +
  geom_point(alpha = 0.8, show.legend = FALSE) +
  facet_wrap(~parameter, scales = "free_x") +
  labs(x = NULL, y = "AUC")

xgb_res_plot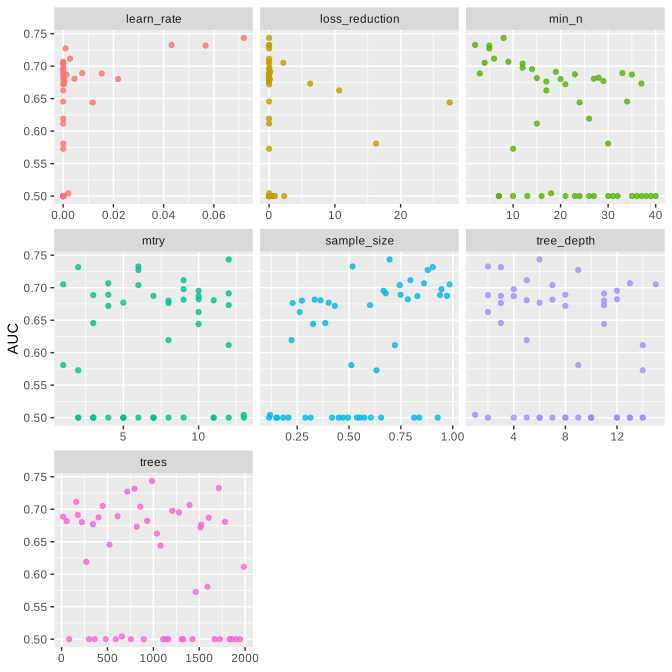
Um die 5 besten Modelle in absteigender Reihenfolge anzuzeigen, verwenden wir show_best():
show_best(xgb_res, "roc_auc") mtry trees min_n tree_depth learn_rate loss_reduction sample_size stop_…¹ .metric .esti…² mean n
1 12 985 8 6 0.0719 9.45e- 7 0.695 4 roc_auc binary 0.743 50
2 6 1713 2 2 0.0432 2.83e-10 0.517 7 roc_auc binary 0.733 50
3 2 794 5 3 0.0567 4.73e- 7 0.904 14 roc_auc binary 0.732 50
4 6 716 5 9 0.000956 1.62e- 2 0.880 9 roc_auc binary 0.727 50
5 9 159 6 5 0.00270 2.68e- 6 0.796 16 roc_auc binary 0.712 50
## … with abbreviated variable names ¹stop_iter, ².estimatorUm das beste Modell zu extrahieren, verwenden wir select_best():
best_model <- select_best(xgb_res, "roc_auc")
best_model
mtry trees min_n tree_depth learn_rate loss_reduction sample_size stop_iter .config
1 12 985 8 6 0.0719 0.000000945 0.695 4 Preprocessor1_Model09Abschließend passen wir das beste Modell erneut an den gesamten Trainingsdatensatz an (ohne Kreuzvalidierung) und evaluieren es auf den Testdaten. Dies geschieht mit der Funktion last_fit(), der wir colon_split übergeben, das sowohl Trainings- als auch Testdaten enthält.
final_model <-
  xgb_res %>%
  extract_workflow("xgb_wf") %>%
  finalize_workflow(best_model) %>%
  last_fit(split = colon_split,
           metrics = yardstick::metric_set(roc_auc))
Die Vorhersagegüte dieses Modells auf den Testdaten kann nun evaluiert werden:
collect_metrics(final_model) .metric .estimator .estimate .config
roc_auc binary 0.707 Preprocessor1_Model1Die ROC AUC des besten Modells betrug 0,707.
Die Vorhersagen auf den Testdaten können wir mit folgendem Code extrahieren:
collect_predictions(final_model) id .pred_Yes .pred_No .row status .config
1 train/test split 0.720 0.280 2 Yes Preprocessor1_Model1
2 train/test split 0.120 0.880 4 No Preprocessor1_Model1
3 train/test split 0.475 0.525 8 Yes Preprocessor1_Model1
4 train/test split 0.940 0.0603 13 Yes Preprocessor1_Model1
5 train/test split 0.905 0.0946 14 Yes Preprocessor1_Model1
6 train/test split 0.503 0.497 20 No Preprocessor1_Model1
7 train/test split 0.436 0.564 21 No Preprocessor1_Model1
8 train/test split 0.612 0.388 22 No Preprocessor1_Model1
9 train/test split 0.562 0.438 30 No Preprocessor1_Model1
10 train/test split 0.831 0.169 32 Yes Preprocessor1_Model1
## … with 548 more rowsEine ROC-Kurve lässt sich einfach mit folgendem Code erstellen:
collect_predictions(final_model) %>%
  roc_curve(status, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal() +
  theme_bw()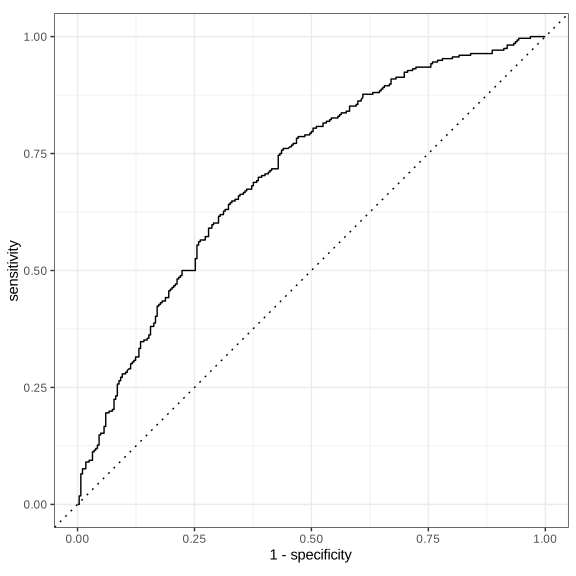
Variable Importance
Die Bedeutung der Variablen (relative Variable Importance) können wir mit dem Package vip wie folgt extrahieren:
library(vip)

final_model %>%
  extract_fit_parsnip() %>%
  vip(geom = "point")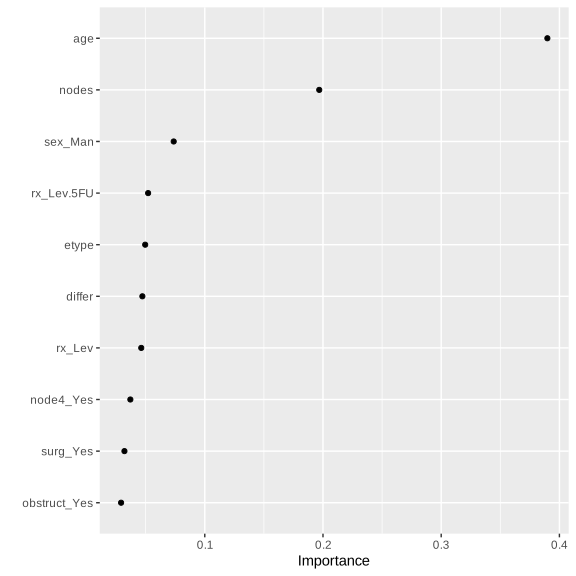
Literatur
Hvitfeldt E, Frick H (2022). censored: 'parsnip' Engines for Survival Models. R package version 0.1.1, https://github.com/tidymodels/censored.
Kuhn M, Vaughan D (2022). parsnip: A Common API to Modeling and Analysis Functions. https://github.com/tidymodels/parsnip, https://parsnip.tidymodels.org/.
Vaughan D, Couch S (2022). workflows: Modeling Workflows. https://github.com/tidymodels/workflows, https://workflows.tidymodels.org.