
In diesem Kapitel werden Daten von Pima-Indianern verwendet. Diabetes ist bei Pima-Indianern häufiger, und in diesen Daten wurden 768 Personen hinsichtlich Diabetes, Blutzucker usw. untersucht. Die Daten befinden sich im Package mlbench. Sie müssen mlbench zunächst installieren und anschließend die Daten laden. Außerdem erstellen wir eine Kopie der Daten als Objekt pima.
## mlbench installieren und laden
install.packages("mlbench")
library(mlbench)

## Daten laden
data(PimaIndiansDiabetes)

## Daten kopieren
pima <- PimaIndiansDiabetes

## Daten inspizieren
head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 pos
2 1 85 66 29 0 26.6 0.351 31 neg
3 8 183 64 0 0 23.3 0.672 32 pos
4 1 89 66 23 94 28.1 0.167 21 neg
5 0 137 40 35 168 43.1 2.288 33 pos
6 5 116 74 0 0 25.6 0.201 30 negDie letzte Spalte (diabetes) gibt an, ob die Person Diabetes hat (pos) oder nicht (neg). Im nächsten Schritt kodieren wir die Spalte diabetes um, sodass sie Yes oder Nein statt pos bzw. neg enthält.
pima$diabetes = recode_factor(pima$diabetes,
                              'pos'='Yes',
                              'neg'='No')

head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 Yes
2 1 85 66 29 0 26.6 0.351 31 No
3 8 183 64 0 0 23.3 0.672 32 Yes
4 1 89 66 23 94 28.1 0.167 21 No
5 0 137 40 35 168 43.1 2.288 33 Yes
6 5 116 74 0 0 25.6 0.201 30 NoTrainingsdaten und Testdaten erstellen
Anschließend verwenden wir die Funktion initial_split(), um Trainingsdaten und Testdaten zu erstellen. Wir geben prop=0.7 an, damit 70 % der Daten für das Training verwendet werden. Mit den Funktionen training() und testing() extrahieren wir dann Trainingsdaten und Testdaten in separate Dateien.
## Trainings- und Testdaten erstellen
pima_split <- initial_split(pima, strata=diabetes, prop=0.7)
pima_train <- training(pima_split)
pima_test  <- testing(pima_split)
Beachten Sie, dass wir im obigen Code strata=diabetes angegeben haben. Das bedeutet, dass unser Split nach der Spalte diabetes stratifiziert wird, wodurch der Anteil von Yes und No in Trainingsdaten und Testdaten gleich groß ist. Das ist wünschenswert, damit der Anteil der Personen mit Diabetes in Trainingsdaten und Testdaten gleich groß ist.
Modell und Methode spezifizieren
Zunächst spezifizieren wir, welchen Modelltyp wir verwenden möchten. Dies geschieht mit Funktionen aus dem Package parsnip. Wir legen zuerst fest, dass wir eine logistische Regression verwenden möchten, was wir mit der Funktion logistic_reg() in parsnip tun. Wenn wir nur den Funktionsnamen schreiben und den Code ausführen, erhalten wir folgendes Ergebnis:
logistic_reg()Logistic Regression Model Specification (classification)
Computational engine: glmDaraus geht hervor, dass ein logistisches Modell für eine Klassifikation (classification) spezifiziert wurde, das heißt, die Zielvariable ist kategorial. Die Schätzung erfolgt mit glm (generalized linear model), der klassischen Form der logistischen Regression. Die Methode („Engine“) GLM ist also die Standardmethode für die logistische Regression in Tidymodels. Wir können jedoch auch andere Methoden für die logistische Regression angeben. Dazu fügen wir die Funktion set_engine() hinzu und geben eine Methode an. Alle Optionen für logistic_reg() finden Sie hier in der Dokumentation.
Bisher haben wir unsere Spezifikation noch nicht gespeichert. Im Folgenden spezifizieren wir eine logistische Regression mit GLM, die für die Klassifikation verwendet werden soll. Letzteres wird mit der Funktion set_mode() festgelegt. Diese Funktion ist besonders wichtig, wenn das Modell sowohl für die Klassifikation (Vorhersage kategorialer Zielvariablen) als auch für die Regression (Vorhersage kontinuierlicher Zielvariablen) verwendet werden kann. Wir speichern die Spezifikation im Objekt log_mod.
log_mod <-
  logistic_reg() |>
  set_engine("glm") |>
  set_mode("classification")

log_mod
Logistic Regression Model Specification (classification)
Computational engine: glmEine Formel spezifizieren
Als Nächstes spezifizieren wir die eigentliche Formel mit der Funktion fit() und fügen sie dem Objekt log_mod hinzu. Beachten Sie, dass die Formel diabetes ~ . bedeutet, dass wir ein Modell erstellen, in dem diabetes die Zielvariable ist und alle anderen Variablen Prädiktoren sind, was durch den Punkt (.) angegeben wird:
log_fit <-
  log_mod |>
  fit(diabetes ~ ., data=pima_train)

## Ergebnis ausgeben
log_fit
parsnip model object
Call: stats::glm(formula = diabetes ~ ., family = stats::binomial,
data = data)
Coefficients:
(Intercept) pregnant glucose pressure triceps insulin mass pedigree age
8.591e+00 -1.499e-01 -3.117e-02 1.470e-02 5.995e-06 1.321e-03 -1.056e-01 -7.798e-01 -2.357e-02
Degrees of Freedom: 536 Total (i.e. Null); 528 Residual
Null Deviance: 694.2
Residual Deviance: 500.4 AIC: 518.4Ergebnisse extrahieren
Übersichtlicher wird das Ergebnis mit der Funktion tidy() aus dem Package broom. Wir setzen die Argumente exponentiate und conf.int auf TRUE, um exponenzierte Koeffizienten sowie Konfidenzintervalle zu erhalten:
tidy(log_fit, exponentiate=T, conf.int=T) term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 5382. 0.873 9.84 7.85e-23 1040. 32053.
2 pregnant 0.861 0.0386 -3.88 1.05e- 4 0.797 0.928
3 glucose 0.969 0.00431 -7.24 4.61e-13 0.961 0.977
4 pressure 1.01 0.00648 2.27 2.32e- 2 1.00 1.03
5 triceps 1.00 0.00843 0.000711 9.99e- 1 0.984 1.02
6 insulin 1.00 0.00102 1.29 1.97e- 1 0.999 1.00
7 mass 0.900 0.0192 -5.51 3.52e- 8 0.866 0.933
8 pedigree 0.458 0.365 -2.14 3.27e- 2 0.222 0.930
9 age 0.977 0.0109 -2.16 3.04e- 2 0.956 0.998Die Spalte estimate ist die Odds Ratio (Chancenverhältnis). Die Spalten conf.low und conf.high sind die untere bzw. obere Grenze des 95-%-Konfidenzintervalls.
Vorhersagen
Im nächsten Schritt wird das Modell verwendet, um Vorhersagen für die Testdaten (pima_test) zu treffen. Dies geschieht mit der Funktion predict(). Das Ergebnis wird in einer neuen Spalte in pima_test gespeichert. Die neue Spalte heißt predicted:
pima_test$predicted <- predict(log_fit,
                               new_data = pima_test,
                               type="prob")
Wenn wir pima_test betrachten, sehen wir, dass die neue Spalte tatsächlich aus zwei Spalten besteht, nämlich .pred_Yes und .pred_No. Es handelt sich also um eine „verschachtelte“ (nested) Spalte, da sie aus mehreren Spalten besteht.
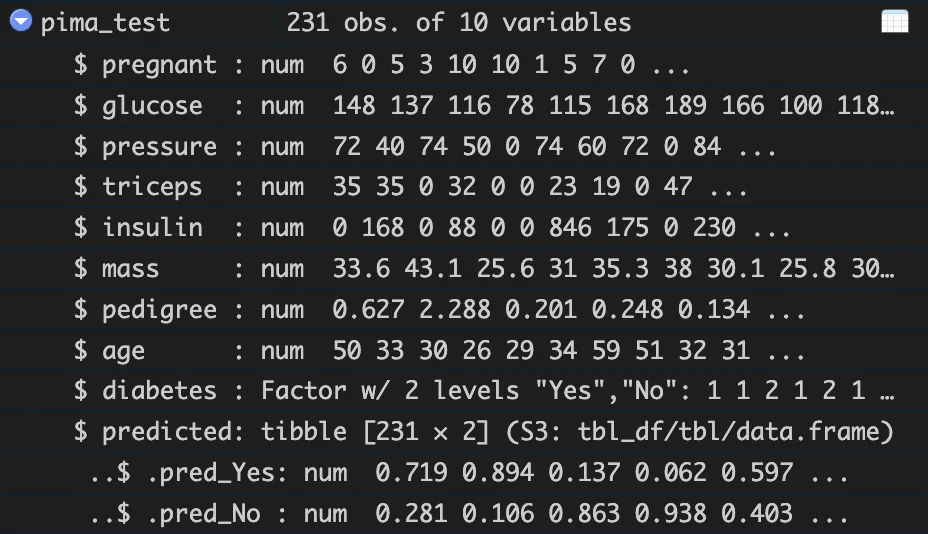
Verschachtelte Spalten sind zwar eine effiziente Form der Speicherung, in diesem Fall aber etwas unpraktisch. Daher lösen wir die Spalten mit der Funktion unnest() wie folgt in separate Spalten auf:
pima_test <- unnest(pima_test, predicted)

## Daten inspizieren
head(pima_test)
pregnant glucose pressure triceps insulin mass pedigree age diabetes .pred_Yes .pred_No
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <fct> <dbl> <dbl>
1 6 148 72 35 0 33.6 0.627 50 Yes 0.719 0.281
2 0 137 40 35 168 43.1 2.29 33 Yes 0.894 0.106
3 5 116 74 0 0 25.6 0.201 30 No 0.137 0.863
4 3 78 50 32 88 31 0.248 26 Yes 0.0620 0.938
5 10 115 0 0 0 35.3 0.134 29 No 0.597 0.403
6 10 168 74 0 0 38 0.537 34 Yes 0.885 0.115
7 1 189 60 23 846 30.1 0.398 59 Yes 0.760 0.240
8 5 166 72 19 175 25.8 0.587 51 Yes 0.658 0.342
9 7 100 0 0 0 30 0.484 32 Yes 0.361 0.639
10 0 118 84 47 230 45.8 0.551 31 Yes 0.384 0.616Die Spalten .pred_Yes und .pred_No sind die vom logistischen Regressionsmodell vorhergesagten Wahrscheinlichkeiten für die Ausprägungen Yes bzw. No. Die Summe der Wahrscheinlichkeiten für Yes und No beträgt immer 1,0.
Das Modell evaluieren
Betrachten wir nur die Wahrscheinlichkeit für Yes (.pred_Yes), können wir beispielsweise festlegen, dass wir Diabetes vorhersagen, wenn die Wahrscheinlichkeit >0,5 ist (größer als 0,5). Die Grenze 0,5 wird in vielen Packages und Funktionen häufig als Standard verwendet, weil Werte >0,5 bedeuten, dass das Eintreten des Ereignisses (hier Diabetes) wahrscheinlicher ist als sein Ausbleiben. Diese Grenze wird oft als Decision Threshold bezeichnet. Selbstverständlich kann man den Decision Threshold auf 0,4; 0,35; 0,2 oder noch tiefer senken. Je niedriger der Schwellenwert, desto mehr Personen mit Diabetes werden erkannt, desto mehr Personen erhalten aber auch falsch-positive Diagnosen. Es gibt einfache Funktionen, um Sensitivität und Spezifität für eine große Zahl von Decision Thresholds zu bestimmen. Mit der Funktion roc_curve() berechnen wir Sensitivität und Spezifität für über 200 Decision Thresholds:
pima_test %>%
  roc_curve(diabetes, .pred_Yes)
.threshold specificity sensitivity
<dbl> <dbl> <dbl>
1 -Inf 0 1
2 0.00171 0 1
3 0.0133 0.00667 1
4 0.0176 0.0133 1
5 0.0190 0.0200 1
6 0.0210 0.0267 1
7 0.0260 0.0333 1
8 0.0279 0.0400 1
9 0.0282 0.0467 1
10 0.0297 0.0533 1
....Die Fläche unter der ROC-Kurve lässt sich mit folgendem Code automatisch berechnen:
pima_test %>%
  roc_auc(diabetes, .pred_Yes)
.metric .estimator .estimate
roc_auc binary 0.840Die AUC ROC beträgt 0,840.
Die ROC-Kurve erhält man mit folgendem Code:
pima_test %>%
  roc_curve(diabetes, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal()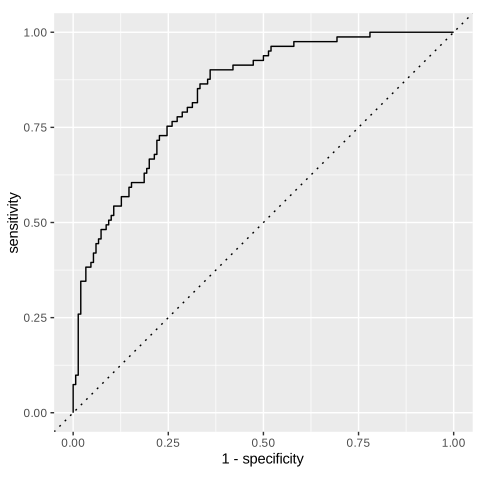
Interessehalber können wir das Modell noch einmal erstellen, diesmal jedoch mit Extreme Gradient Boosting (XGBoost), einem sehr leistungsfähigen Modell. XGBoost ist über die Funktion boost_tree() verfügbar. Es hat Hyperparameter (zum Beispiel tree_depth), die eigentlich optimiert werden müssten, was in diesem Beispiel jedoch nicht geschieht. Der Einfachheit halber erhalten die Hyperparameter jeweils einen einzigen Standardwert. In Zeile 13 erstellen wir einen neuen Data Frame namens resultat, der nur die Spalte diabetes aus pima_test enthält. In Zeile 16 verwenden wir unser XGBoost-Modell, um die Wahrscheinlichkeit für Diabetes vorherzusagen, und das Ergebnis wird in die Spalte predicted2 in resultat geschrieben. In Zeile 21 lösen wir die verschachtelte Spalte predicted2 mit unnest auf. Anschließend werden AUC-ROC und ROC-Kurve berechnet.
## Modell und Methode spezifizieren
xgb_mod <-
  boost_tree(tree_depth = 4,
             trees = 600,
             learn_rate = 0.005,
             min_n = 5,
             sample_size = 0.5) |>
  set_engine('xgboost') |>
  set_mode('classification') |>
  fit(diabetes ~ ., data=pima_train)

## Einen Data Frame mit den tatsächlichen Diagnosen erstellen
resultat <- data.frame(diabetes = pima_test$diabetes)

## Diagnose vorhersagen
resultat$predicted2 <- predict(xgb_mod,
                               new_data = pima_test,
                               type="prob")

## Spalte predicted2 entschachteln (unnest)
resultat <- unnest(resultat, predicted2)

## ROC AUC
resultat %>%
    roc_auc(diabetes, .pred_Yes)

## ROC-Kurve
resultat |>
  roc_curve(diabetes, .pred_Yes) |>
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal()
.metric .estimator .estimate
roc_auc binary 0.844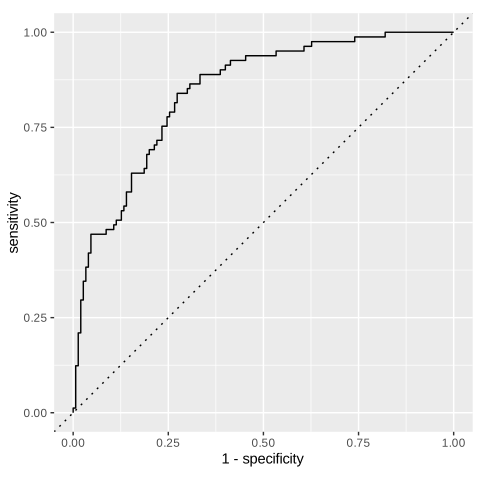
Die ROC für XGBoost ohne Hyperparameter-Tuning betrug 0,844 gegenüber 0,840 für die logistische Regression.
Variable Importance
Machine-Learning-Verfahren dieser Art verfügen über eingebaute Methoden, um die relative Bedeutung der Prädiktoren zu vergleichen. Dies wird als Relative Variable Importance bezeichnet. Mit dem Package vip (variable importance) lässt sich diese Information wie folgt aus Tidymodels-Objekten extrahieren:
library(vip)
xgb_mod %>% vip(geom = "point")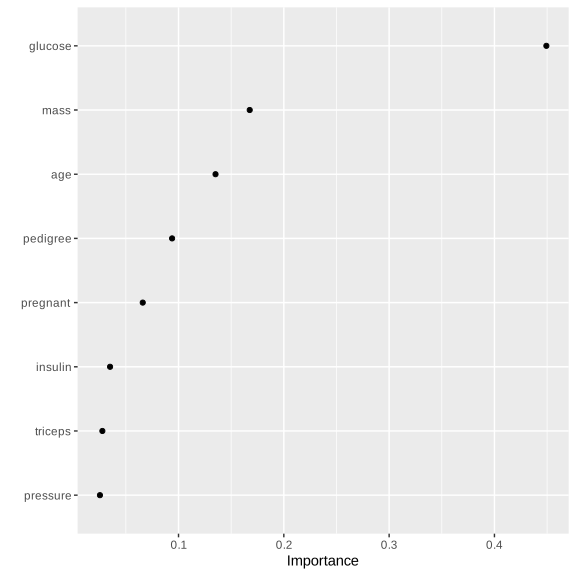
Fragen und Antworten
Wo finde ich die Liste der verfügbaren Modelle und Methoden? Hier klicken, um zur Dokumentation von parsnip zu gelangen.