
Korrelation ist nicht Regression
Den Zusammenhang (die Assoziation, die Beziehung) zwischen zwei oder mehr Variablen zu untersuchen, ist in jeder Forschung und Analyse üblich. In diesem Fall sind die Begriffe Zusammenhang, Assoziation und Beziehung synonym. Beispiele für Zusammenhänge, die untersucht werden können, sind der Zusammenhang zwischen Cholesterin und Myokardinfarkt oder zwischen BMI (Body Mass Index) und Blutzucker. Hat man die Assoziation zwischen Variablen untersucht, lassen sich folgende Fragen beantworten:
- Besteht eine Beziehung zwischen den Variablen?
- Wie stark ist die Beziehung zwischen den Variablen?
- Wie sieht die Beziehung aus?
Um Assoziationen zwischen Variablen zu untersuchen, verwendet man meist Korrelation und Regression. Mit der Korrelation lässt sich untersuchen, wie stark ein linearer Zusammenhang zwischen zwei Variablen ist. Die Regression ist ein leistungsfähigeres Werkzeug: Mit ihr kann man nämlich untersuchen, wie stark der Zusammenhang ist, man kann mehr als zwei Variablen gleichzeitig betrachten, und man kann das Ergebnis zur Prädiktion (für Vorhersagen) nutzen. Prädizieren bedeutet, dass man ein statistisches Modell verwendet, um den Wert einer Variablen, deren Wert unbekannt ist, anhand von Variablen mit bekannten Werten vorherzusagen. Variablen, die zur Prädiktion verwendet werden, nennt man Prädiktoren. Die Variable, die vorhergesagt werden soll, wird mathematisch mit bezeichnet und hat mehrere Synonyme, z. B. Endpunkt, Zielgröße, Outcome, abhängige Variable, Label usw.
Angenommen, wir untersuchen die Beziehung zwischen BMI (Body Mass Index) und Blutzucker. Mit der Korrelation können wir klären, wie stark die Beziehung zwischen BMI und Blutzucker ist. Mit der Regression können wir zusätzlich zur Stärke der Beziehung auch beschreiben, wie der Zusammenhang aussieht, und lernen, den Blutzucker für verschiedene BMI-Werte zu prädizieren (vorherzusagen).
Korrelation und Regression: Kausalität oder Assoziation?
Kausalität wurde bereits behandelt. Einzelheiten finden Sie im Kapitel Kausale Inferenz (Kausalität).
Der Begriff Kausalität ist in jeder Forschung und Analyse zentral. Ein kausaler Zusammenhang zwischen zwei Faktoren bedeutet, dass der eine Faktor den anderen beeinflusst. Zwischen den Faktoren besteht also eine Beziehung von Ursache und Wirkung. Es gibt einen kausalen Zusammenhang zwischen LDL-Cholesterin und dem Risiko für eine koronare Herzkrankheit. Das bedeutet, dass mit steigendem LDL-Cholesterin das Risiko für eine koronare Herzkrankheit zunimmt. Der Zusammenhang zwischen LDL-Cholesterin und koronarer Herzkrankheit ist somit kausal. Wie im Kapitel Kausale Inferenz (Kausalität) erörtert, ist dieses Thema recht kompliziert. Der zentrale Grundsatz lautet, dass eine mathematische Assoziation (ob mit Korrelation, Regression oder Machine Learning nachgewiesen) nicht notwendigerweise kausal ist. Alle Assoziationen sind mit Vorsicht zu interpretieren, und die Beurteilung, ob ein Zusammenhang kausal ist, sollte auf umfassender, multidisziplinärer und reproduzierbarer Wissenschaft beruhen.
Es folgt ein Beispiel für einen nicht-kausalen Zusammenhang:
Angenommen, wir untersuchen den Zusammenhang zwischen gelben Fingern und dem Risiko für Lungenkrebs. Wir untersuchen 5000 Personen, stufen ihre Finger auf einer Skala von 0 bis 50 danach ein, wie gelb sie sind, und stellen fest: Je gelber die Finger, desto höher das Risiko für Lungenkrebs. In diesem Fall ist der Zusammenhang zwischen gelben Fingern und Lungenkrebs echt, d. h. es besteht ein mathematisch bestätigter Zusammenhang. Gelbe Finger sind jedoch nicht die Ursache von Lungenkrebs; wahrscheinlicher ist, dass Personen mit gelben Fingern rauchen, und je mehr man raucht, desto gelber werden die Finger. Das Rauchen erklärt sowohl die gelben Finger als auch den Lungenkrebs. Auch wenn gelbe Finger nicht die Ursache des Krebses waren, ist die Klärung des Zusammenhangs dennoch wichtig, da (1) gelbe Finger klinisch zum Screening genutzt werden können und (2) gelbe Finger uns zur eigentlichen Ursache des Krebses führen können.
Korrelation und Korrelationskoeffizient
Eine Korrelation umfasst zwei Variablen (im Folgenden und ). Diese Variablen werden gleich behandelt, insofern keine von ihnen als Prädiktor oder Endpunkt (Outcome) betrachtet wird. Die Korrelation zwischen und bildet den Zusammenhang zwischen den Variablen ab. Die Korrelation reicht von –1 bis +1, und dieser Wert, der als Korrelationskoeffizient bezeichnet wird, hat keine Einheit. Ist der Korrelationskoeffizient +1, so zeigt dies einen perfekten positiven linearen Zusammenhang zwischen und an. Ist der Koeffizient dagegen –1, so zeigt dies einen perfekten negativen linearen Zusammenhang zwischen und an. Ist der Korrelationskoeffizient 0, so besteht kein Zusammenhang zwischen und .
Wir visualisieren nun die Korrelation für zwei Variablen im Datensatz mtcars und berechnen sie. Zur Visualisierung der Korrelation und zur Berechnung des Korrelationskoeffizienten verwenden wir das Package ggpubr mit der Funktion ggscatter(). Die Kommentare unten erläutern die Argumente.
library(tidyverse)
data("mtcars")

library(ggpubr)
ggscatter(mtcars,
          x = "wt",
          y = "mpg",
          size = 3,
          add = "reg.line",
          cor.coef = TRUE,
          cor.coeff.args = list(method = "pearson", label.x = 3, label.sep = "\n"))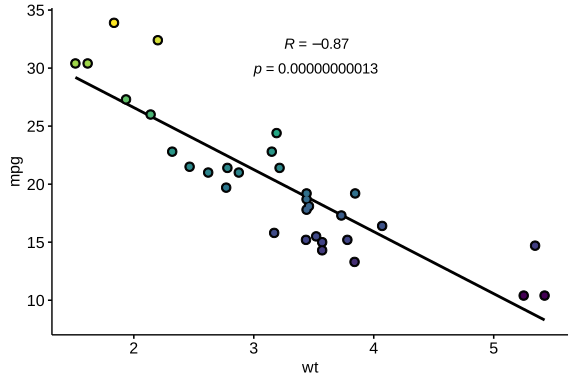
Der Korrelationskoeffizient betrug -0,87. Das ist ein starker negativer Zusammenhang. Beachten Sie, dass die Linie in der obigen Grafik eine Regressionsgerade ist. Korrelationen ergeben keine Linien durch die Daten.
Mit der Funktion ggpairs() aus dem Package GGally können wir eine Korrelationsmatrix für viele Variablen gleichzeitig erzeugen. Code und Ergebnis sehen wie folgt aus:
library(GGally)
ggpairs(mtcars,
        # Welche Spalten?
       columns = 1:4,
       ggplot2::aes(colour=factor(am)))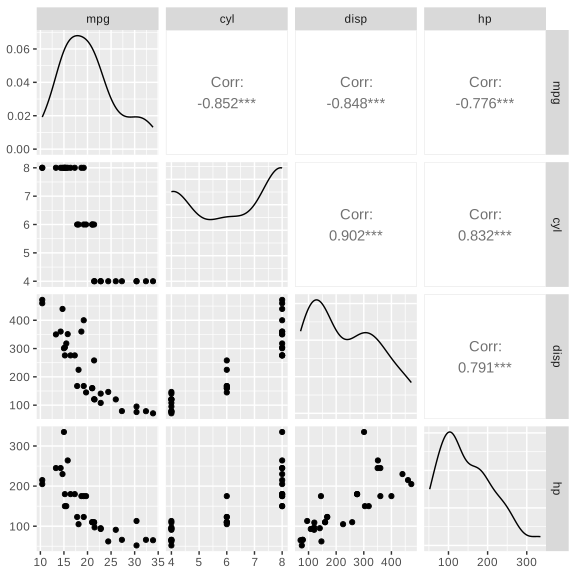
Der Korrelationskoeffizient ist ein Maß für den linearen Zusammenhang zwischen X und Y. Der Koeffizient kann maximal –1 oder +1 betragen, je nachdem, ob der Zusammenhang negativ bzw. positiv ist. Je näher die Korrelation an 0 liegt, desto schwächer ist der Zusammenhang. Je näher die Korrelation an –1 oder +1 liegt, desto stärker ist der Zusammenhang. Ist der Korrelationskoeffizient 0, so führt eine Änderung von X nicht zu einer Änderung von Y.
Pearson-Korrelationskoeffizient
Der Korrelationskoeffizient muss aus den Daten berechnet werden. Es gibt mehrere Möglichkeiten, den Koeffizienten zu berechnen. Der gebräuchlichste Korrelationskoeffizient ist der Pearson’s Product-Moment Coefficient of Correlation, kurz Pearson-Korrelationskoeffizient. Er wird mit dem Buchstaben r abgekürzt. Den Pearson-Korrelationskoeffizienten erhält man, indem man die Kovarianz der Variablen und durch das Produkt ihrer Standardabweichungen dividiert.
Kovarianz und Korrelation
Die Kovarianz ähnelt der Korrelation. Die Kovarianz ist ein Maß für die gemeinsame Variation zweier Variablen (, ), d. h. dafür, wie und miteinander variieren. Entsprechen höhere Werte von X höheren Werten von Y und umgekehrt, so variieren und gemeinsam. Eine positive Kovarianz bedeutet, dass höhere Werte von höheren Werten von entsprechen. Eine negative Kovarianz bedeutet das Umgekehrte.
Die Kovarianz ist die lineare gemeinsame Variation von und und ähnelt damit stark der Korrelation zwischen und . Die Kovarianz ist jedoch schwerer zu interpretieren und zu vergleichen. So kann man beispielsweise nicht vergleichen, ob die Kovarianz zwischen Alter und Körpergewicht ebenso stark ist wie die Kovarianz zwischen Alter und Körpergröße, da die Kovarianz skalenabhängig ist (haben die Variablen nicht dieselbe Skala, lassen sie sich nicht vergleichen). Die Lösung des Problems besteht darin, die Kovarianz zu normieren. Dazu dividiert man die Kovarianz durch einen Faktor, der die Skala und die Variation von und abbildet. Dies ergibt einen Wert zwischen –1 und +1, unabhängig davon, welche Variablen man untersucht. Dadurch lassen sich auch Korrelationen zwischen Variablen vergleichen. Beim Pearson-Korrelationskoeffizienten ist dieser Faktor also das Produkt der Standardabweichungen der Variablen (, ).
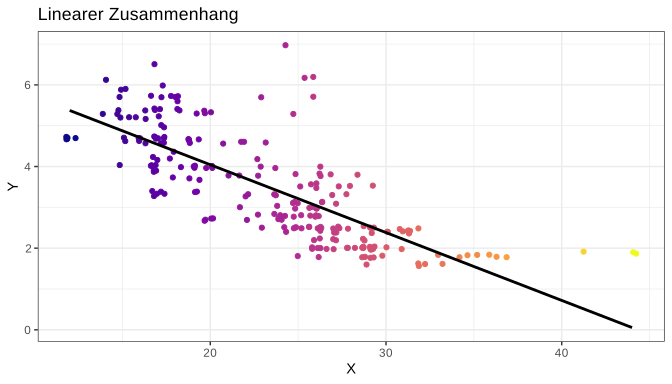
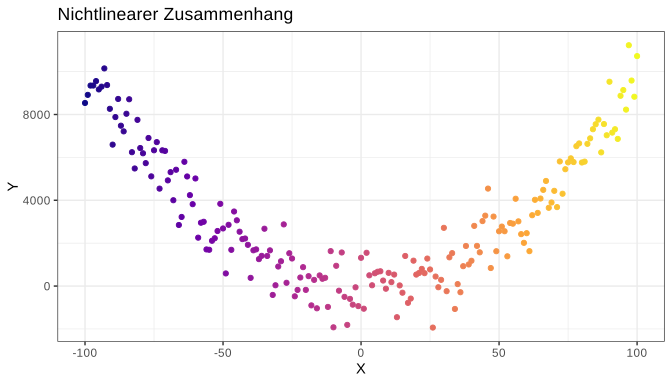
Der Pearson-Korrelationskoeffizient beruht auf der Annahme, dass und normalverteilt sind und dass der Zusammenhang zwischen und linear ist. Die Methode nach Pearson ist also parametrisch (sie setzt voraus, dass die Variablen normalverteilt sind). Die folgende Abbildung zeigt einen linearen bzw. einen nichtlinearen Zusammenhang.
Spearman rank correlation coefficient (Spearman-Korrelationskoeffizient)
Erfüllen die Variablen ( und ) die obigen Voraussetzungen nicht, stehen nichtparametrische Methoden zur Verfügung (d. h. solche, die keine Normalverteilung voraussetzen). Die am häufigsten verwendete nichtparametrische Methode ist der Spearman rank correlation coefficient, kurz Spearman-Korrelationskoeffizient. Bei dieser Methode werden stattdessen die Rangfolgen von und verglichen. Durch die Verwendung von Rängen wird die Berechnung robuster, wenn der Zusammenhang nicht linear ist. Die Rangbildung verringert zudem den Einfluss etwaiger Ausreißer (Extremwerte).
Sind die Voraussetzungen für den Pearson-Korrelationskoeffizienten erfüllt, sollte man die Spearman-Korrelation nicht verwenden, da sie weniger effizient ist; das bedeutet, dass die Methode nach Pearson eine größere Chance hat, einen Zusammenhang zu entdecken (sofern ein solcher existiert).
Man kann und (oder beide) auch transformieren, wenn sie die Voraussetzungen nach Pearson nicht erfüllen. Die Transformation kann beispielsweise erfolgen, indem eine oder beide Variablen logarithmiert werden. Dadurch werden die Voraussetzungen nach Pearson oft erfüllt. Die Transformation beeinflusst den Spearman-Korrelationskoeffizienten nicht, da dieser ausschließlich die Rangfolge der Variablen verwendet, die durch die Transformation nicht verändert wird.
Wie prüfe ich, ob die Variablen normalverteilt sind?
Antwort: Erstellen Sie für jede Variable ein Histogramm.
Wie prüfe ich, ob die Beziehung zwischen und linear ist?
Antwort: Mit einem Streudiagramm lässt sich (visuell) untersuchen, wie die Beziehung aussieht.
Beispiel in R
Aktivieren Sie tidyverse und laden Sie den Datensatz diamonds, der Informationen über verschiedene Diamanten enthält.
library(tidyverse)
data(diamonds)
Erstellen Sie anschließend ein Streudiagramm mit dem Preis (price) auf der x-Achse und dem Karat (carat) auf der y-Achse, und färben Sie die Punkte nach dem Schliff (cut) ein.
ggplot(diamonds,
       aes(x=price, y=carat, color=cut)) +
  geom_point() +
  theme_bw()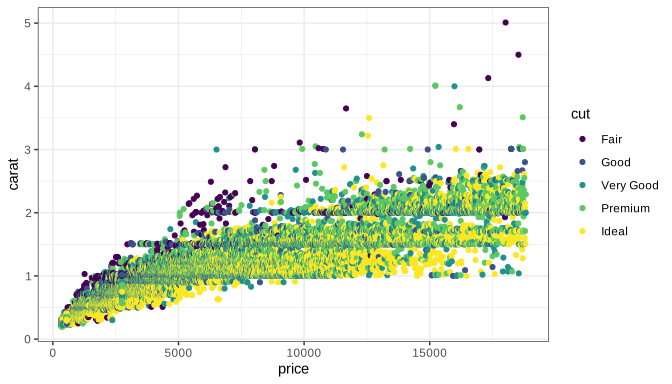
## Wie stark ist die Korrelation nach der Methode von Pearson
cor(tabell$price, tabell$carat, method="pearson")[1] 0.9215913## Wie stark ist die Korrelation nach der Methode von Spearman
cor(tabell$price, tabell$carat, method="spearman")[1] 0.9628828Visuelle Beurteilung der Beziehung
Man sollte eine Korrelation stets visuell beurteilen. Dafür eignet sich ein Streudiagramm hervorragend, insbesondere wenn sich eine Regressionsgerade in der Grafik darstellen lässt. Die visuelle Beurteilung ist deshalb wichtig, weil der Korrelationskoeffizient selbst den Zusammenhang zwischen den Variablen nicht charakterisiert.
Der Korrelationskoeffizient ist also ein zusammenfassendes Maß und darf daher niemals eine visuelle Beurteilung der Beziehung zwischen und ersetzen.