
Ein Ensemble macht bessere Musik. Tausend Vorhersagemodelle sind besser als eines.
Der Mensch neigt dazu, sein Denken und seine Entscheidungen zu strukturieren. Eine Struktur, die wir häufig verwenden (bewusst wie unbewusst), sind Hierarchien. Sie erstellen und nutzen jeden Tag Hierarchien. Stellen Sie sich vor, Sie stehen in einem Geschäft und versuchen zu entscheiden, ob Sie einen Computer kaufen sollen. Um eine kluge Entscheidung zu treffen, fragen Sie sich zunächst: „Kann ich mir einen neuen Computer leisten?“ Lautet die Antwort auf diese Frage „nein“, verzichten Sie wahrscheinlich auf den Kauf. Lautet die Antwort „ja“, gehen Sie vermutlich zur nächsten Frage über: „Brauche ich einen neuen Computer?“ Lautet die Antwort „nein“, verzichten Sie wahrscheinlich auf den Kauf. Lautet sie „ja“, fragen Sie sich vielleicht: „Ist das der richtige Computer für mich?“ Mit anderen Worten: Sie haben versucht, eine Entscheidung zu treffen, indem Sie sich eine Reihe hierarchisch strukturierter Fragen gestellt haben. Wie Abbildung X zeigt, sieht ein solcher Entscheidungsablauf wie ein auf den Kopf gestellter Baum aus, und man nennt ihn daher einen Entscheidungsbaum (engl. decision tree).
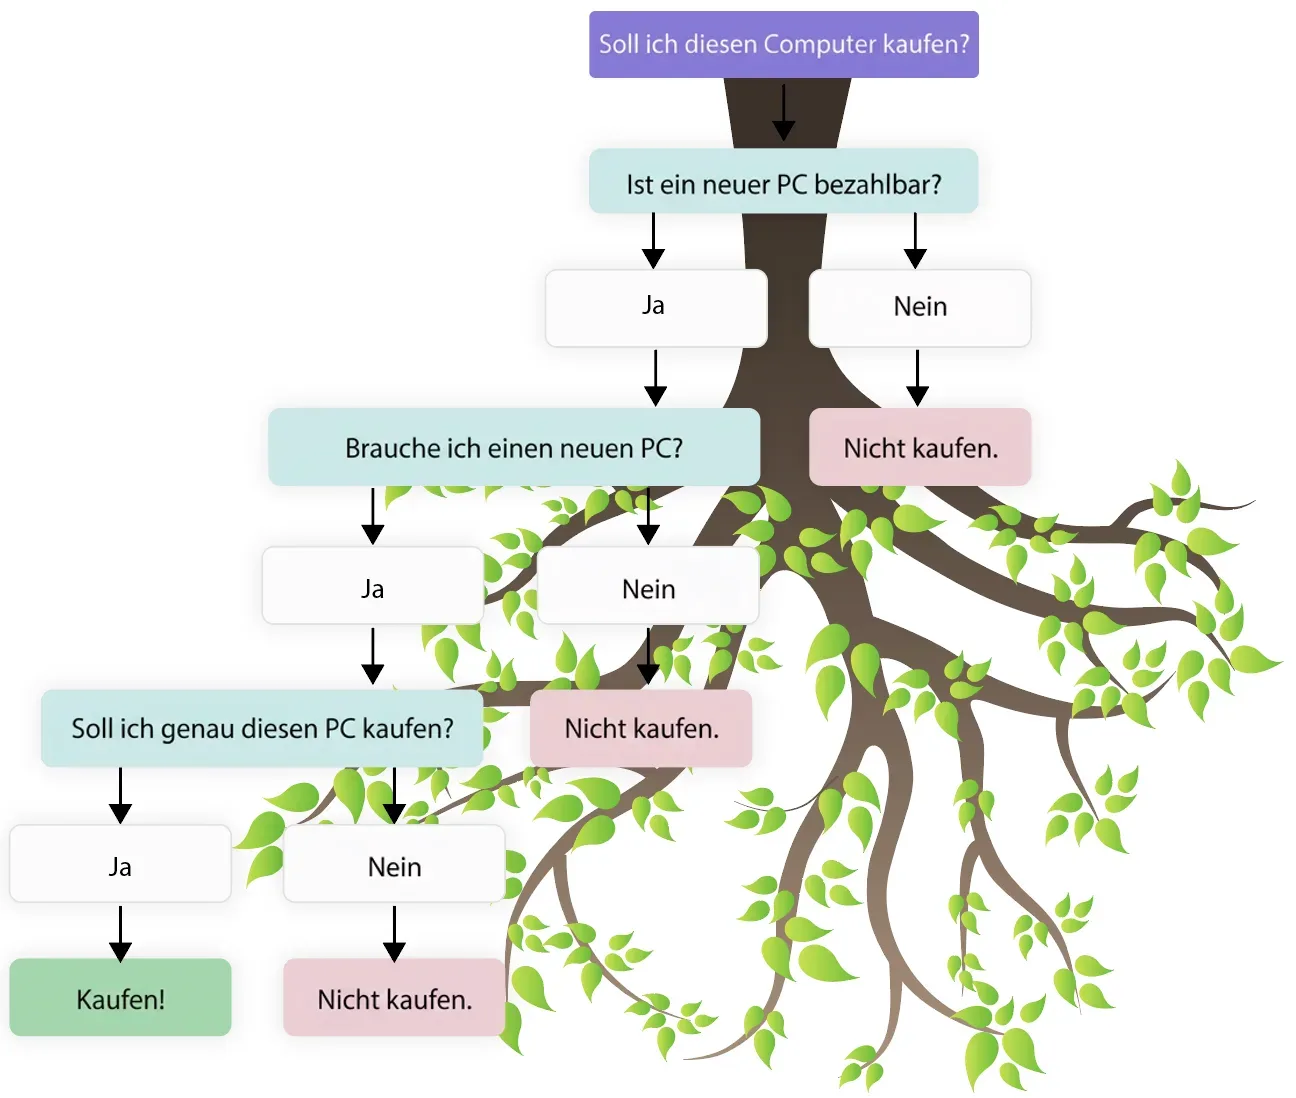
Entscheidungsbäume: eine brillante Idee
Heute dominieren Entscheidungsbäume nahezu das gesamte Machine Learning mit strukturierten Daten (also Daten, die in Zeilen und Spalten vorliegen). Auf Kaggle (www.kaggle.com) treten Tausende von Experten gegeneinander an, um die besten Vorhersagemodelle zu entwickeln, und die Wettbewerbsergebnisse zeigen, dass Entscheidungsbäume bei strukturierten Daten meist besser abschneiden als jedes andere Modell. Tatsächlich nutzen Sie Entscheidungsbäume bereits jeden Tag, etwa wenn Sie die Suchmaschine von Google oder Ihren E-Mail-Dienst verwenden. Die Erklärung dafür, dass sich Entscheidungsbäume für Vorhersagen eignen, ist einfach: Im obigen Beispiel können Sie den Entscheidungsalgorithmus auf einen anderen Computer anwenden und beurteilen, ob Sie stattdessen diesen kaufen sollten.
Im modernen Machine Learning werden Entscheidungsbäume auf sehr ausgefeilte Weise erstellt. Man verwendet ein allgemeines Lernverfahren, das aus den Mustern in den Daten Regeln ableitet und so den Baum aufbaut. Die Struktur des Baumes (und damit das Vorhersagemodell) ist somit datengetrieben (siehe frühere Diskussion). Wir gehen nun genau durch, wie diese Bäume erstellt und wie sie verwendet werden.
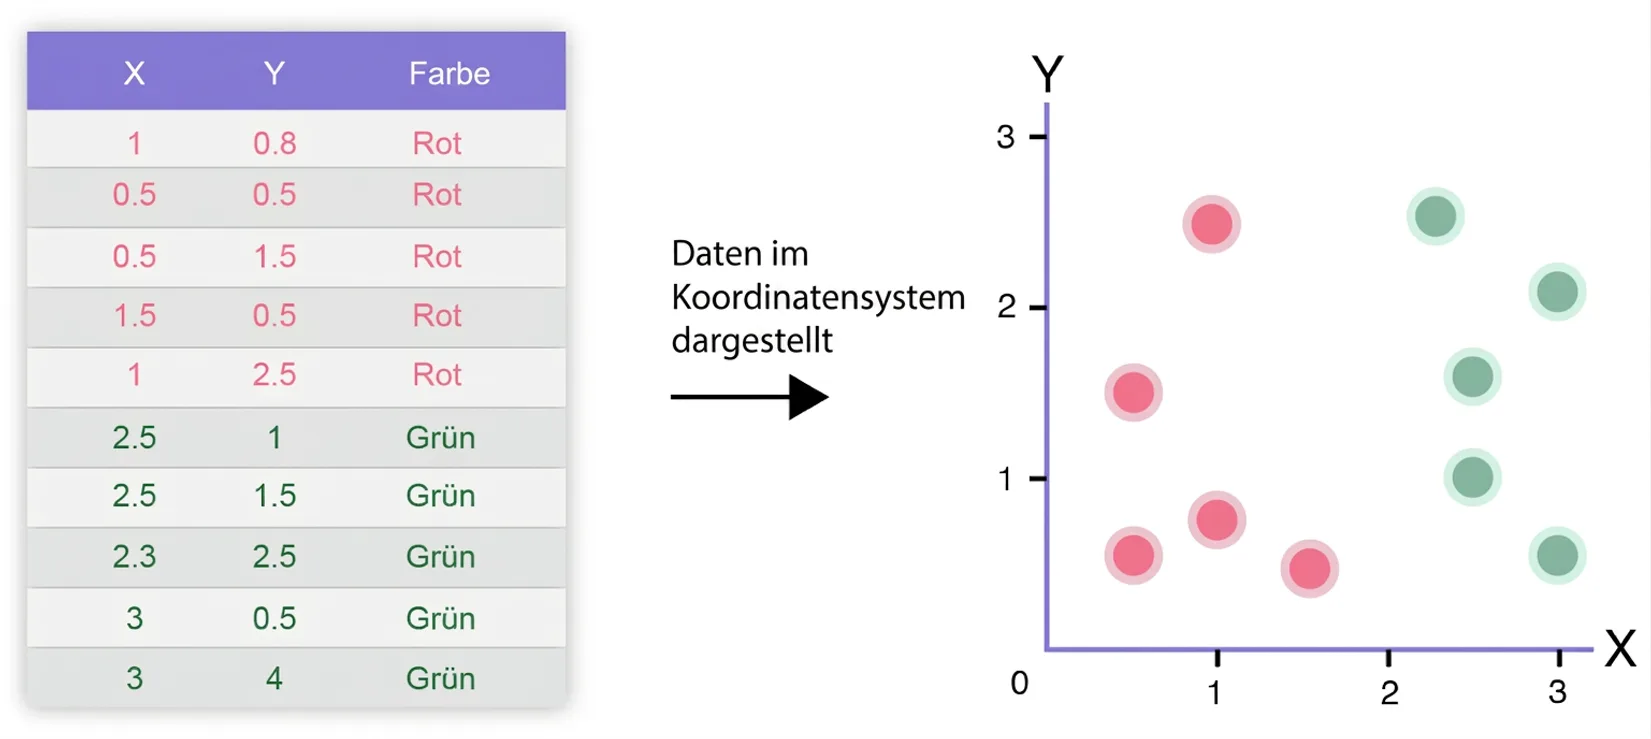
In der folgenden Abbildung sind dieselben Daten in der Tabelle und im Koordinatensystem dargestellt. Stellen Sie sich vor, wir fügen dem Koordinatensystem einen Punkt hinzu, dessen x-Wert 2,0 beträgt. Welche Farbe wird der Punkt Ihrer Meinung nach haben? Wahrscheinlich grün, und damit haben Sie im Kopf einen Entscheidungsbaum erstellt und ausgewertet! Die Struktur dieses Entscheidungsbaums ist in der nächsten Abbildung zu sehen.
In diesem Entscheidungsbaum wird eine einzige Regel auf Grundlage des x-Werts verwendet. Ist x kleiner als 2, wählen wir den linken Zweig, und dort scheinen die Werte rot zu sein. Ist x gleich 2 oder größer, wählen wir den rechten Zweig, und dort scheinen die Beobachtungen grün zu sein. Jede Beobachtung wird also darauf geprüft, ob x kleiner als 2 ist, und anschließend wird entschieden, welcher Zweig gewählt wird. Dieser Punkt, an dem die Daten getrennt werden, heißt Knoten. Die Aufteilung selbst nennt man Split.
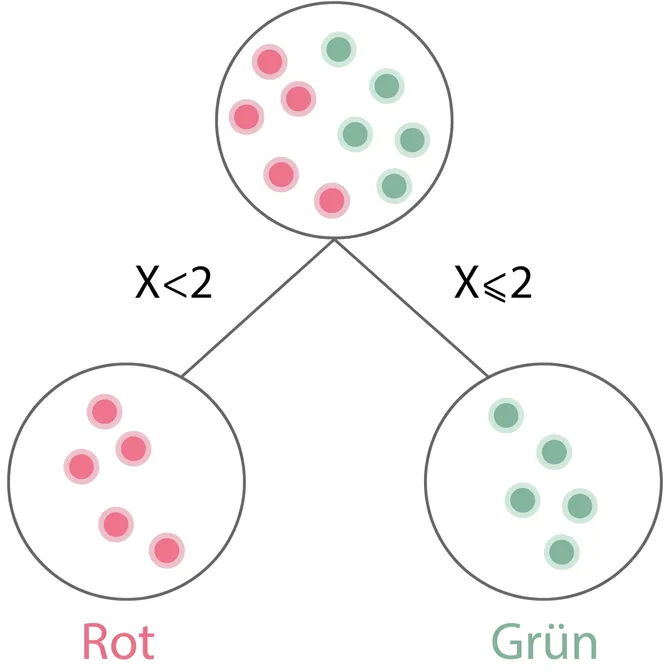
Dieser Entscheidungsbaum kann also verwendet werden, um anhand des x-Werts zu schätzen, welche Farbe eine Beobachtung haben wird. Wir können also die Farbe auf Grundlage einer der Variablen vorhersagen. Man sagt, dass der Entscheidungsbaum dazu verwendet werden kann, die Beobachtungen zu klassifizieren (als grün oder rot).
Im nächsten Koordinatensystem sehen wir nun drei verschiedene Farben der Beobachtungen. Wir versuchen, unseren ersten Entscheidungsbaum anzuwenden. x-Werte von 2 oder größer werden weiterhin als grün klassifiziert, Werte kleiner als 2 lassen sich jedoch nicht in allen Fällen korrekt klassifizieren, da einige der Beobachtungen blau sind. Wir brauchen also einen weiteren Knoten!
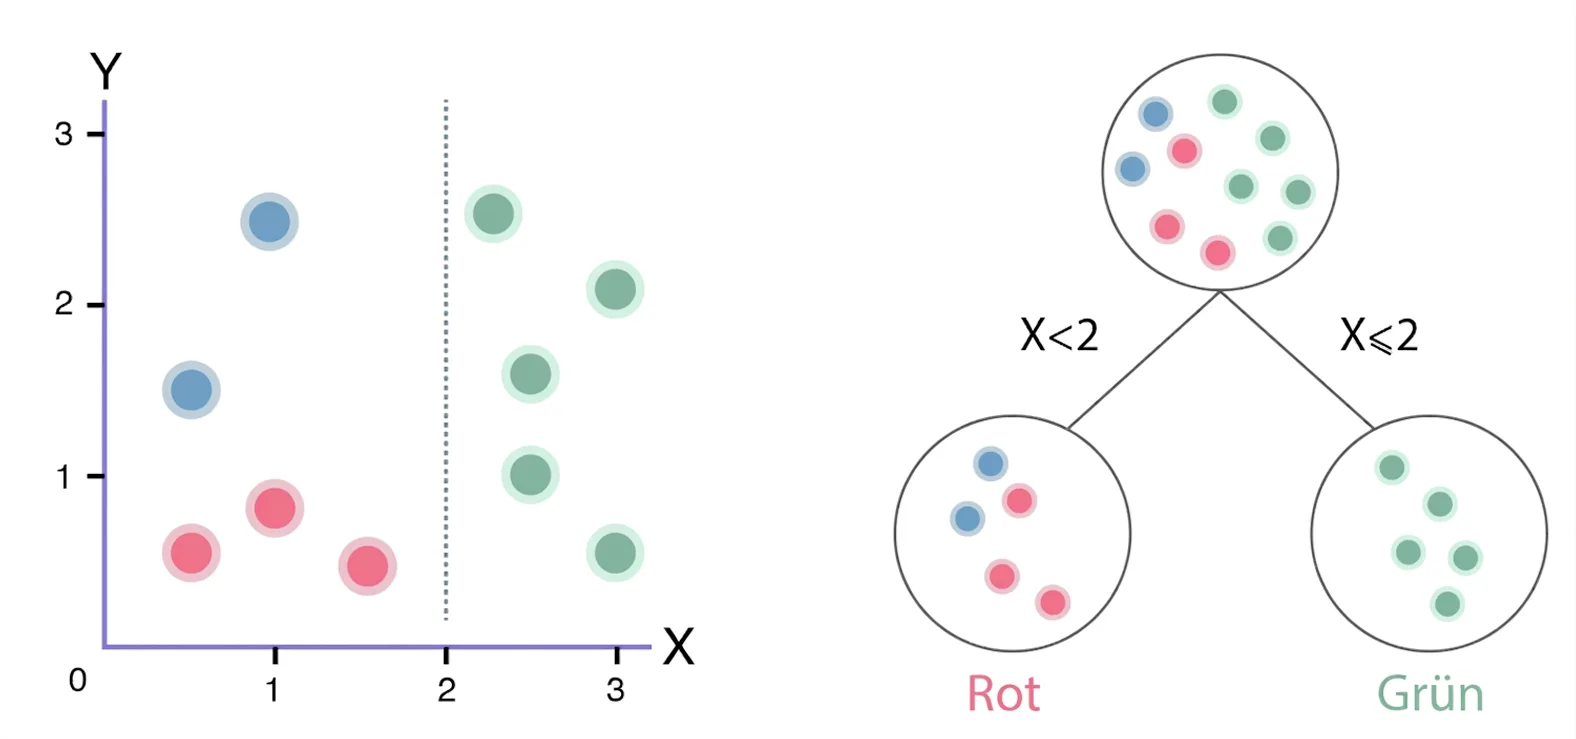
Wir erstellen nun einen weiteren Knoten mit einer neuen Regel auf Grundlage des y-Werts. Ist der y-Wert kleiner als 1, klassifizieren wir die Beobachtung als rot, andernfalls als blau, wie folgt:
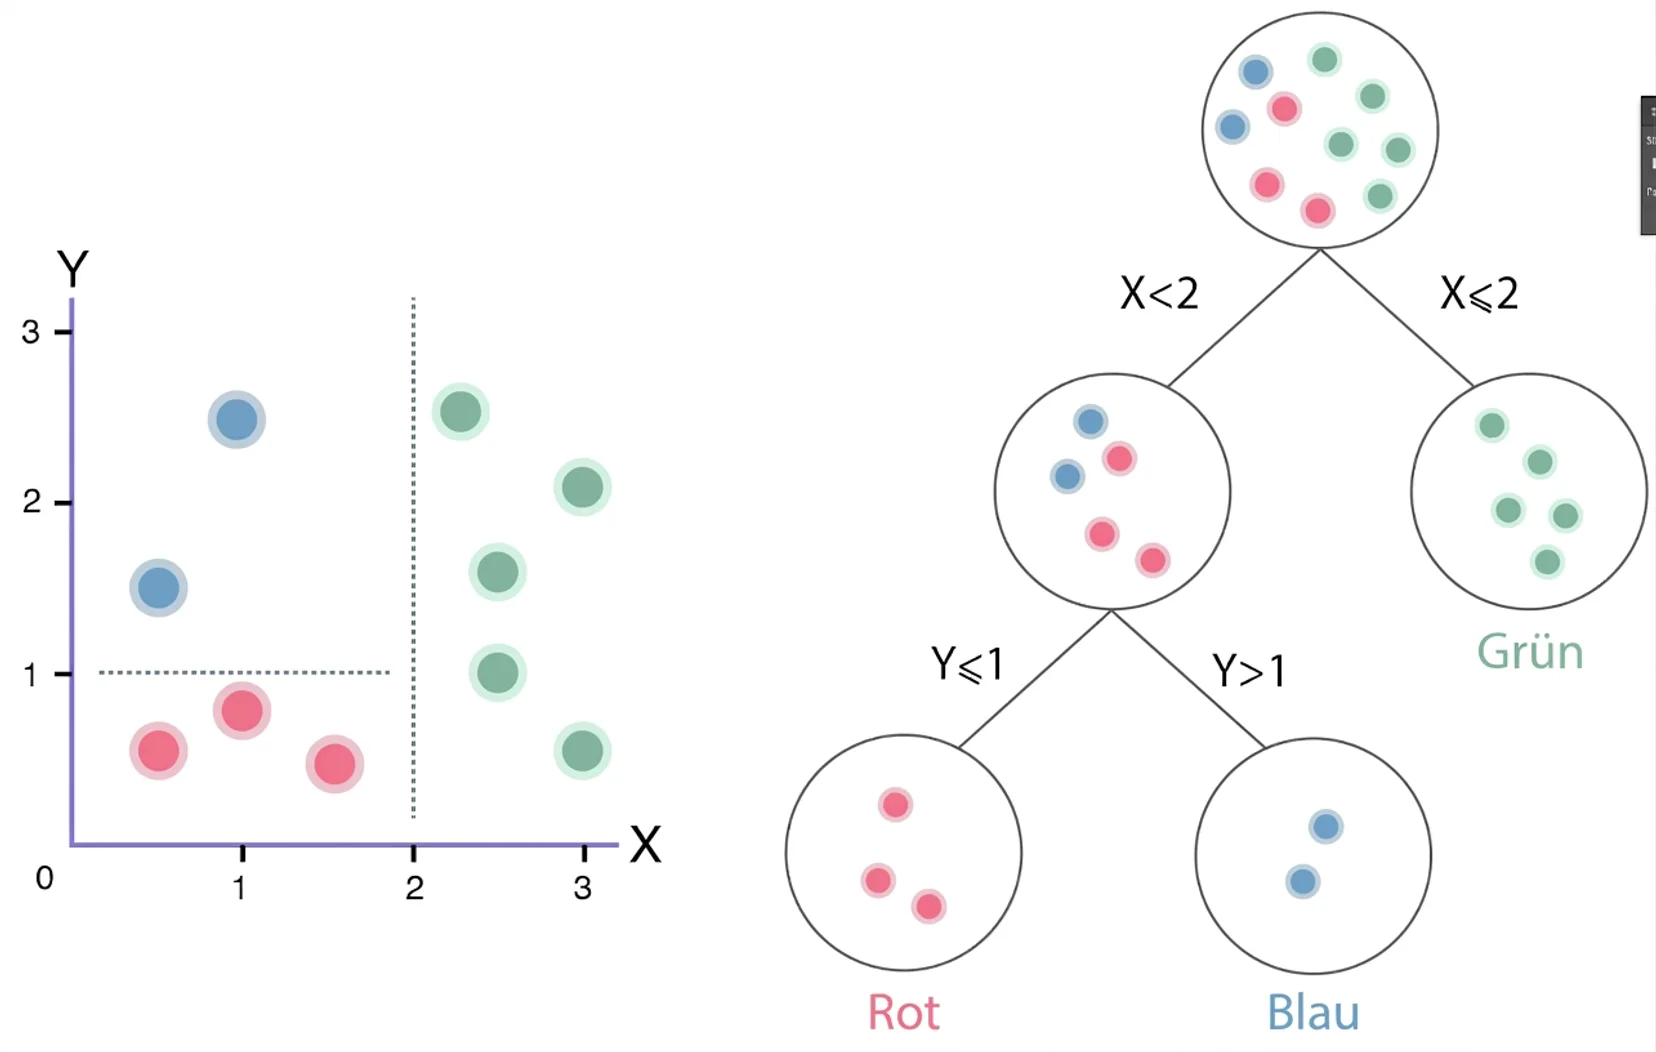
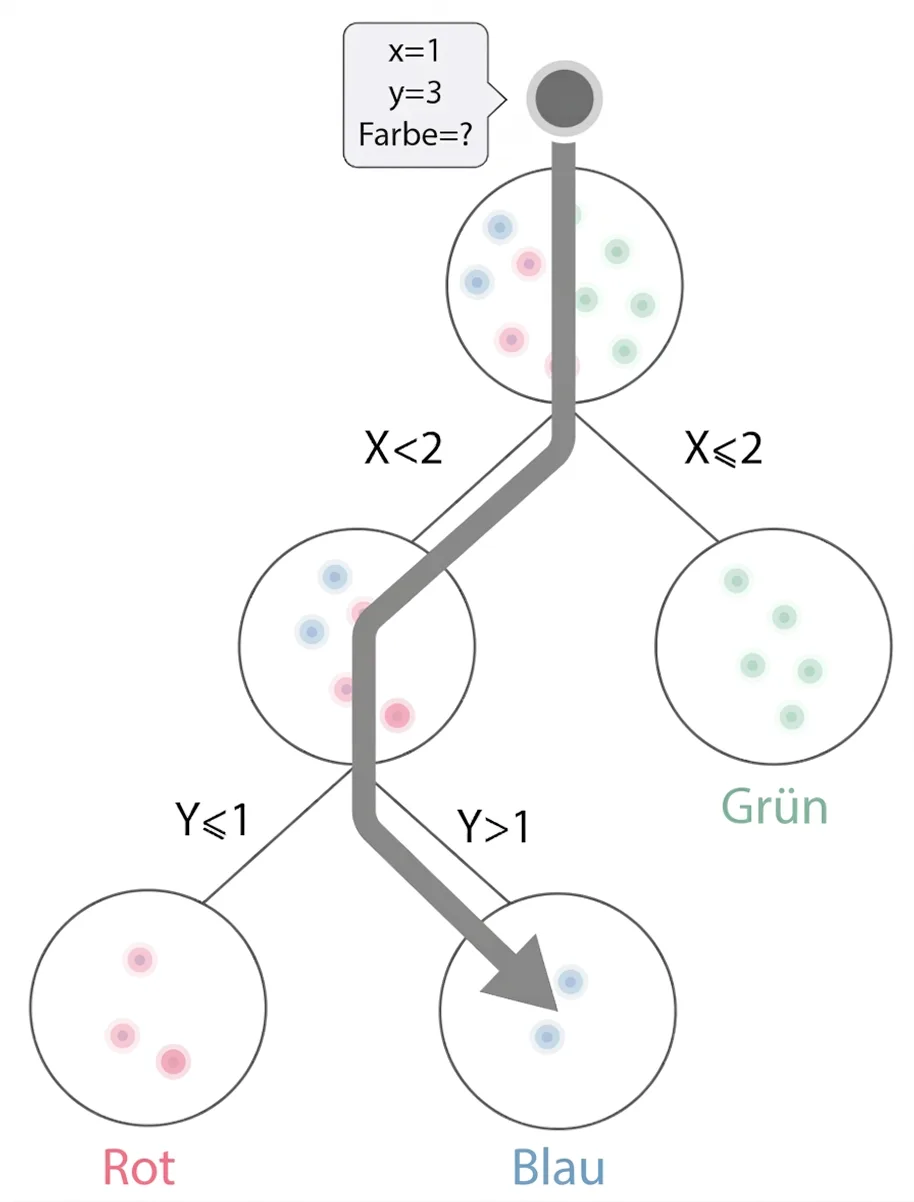
Das ist tatsächlich schon das gesamte Prinzip, nach dem Entscheidungsbäume erstellt werden. Wie diese Diskussion zeigt, können wir unseren Entscheidungsbaum nun verwenden, um anhand des x- und y-Werts vorherzusagen, welche Farbe eine neue Beobachtung haben wird. Der Baum kann somit als Vorhersagemodell dienen. Ein Beispiel dafür sehen Sie in der nächsten Abbildung, in der wir eine völlig neue Beobachtung durch den Entscheidungsbaum laufen lassen, um schließlich zu schätzen, welche Farbe die Beobachtung wahrscheinlich hat.
Machine Learning mit Entscheidungsbäumen
Jeder einzelne Baum ist ein Vorhersagemodell. Das Prinzip des Machine Learning mit Entscheidungsbäumen besteht darin, Hunderte oder Tausende von Bäumen zu erstellen und ihre gemeinsamen Vorhersagen zu nutzen. Man verwendet also einen Datensatz, um Hunderte oder Tausende von Bäumen zu erstellen, die anschließend für die Vorhersage eingesetzt werden. Genau wie neuronale Netze müssen auch die Bäume trainiert und evaluiert werden, was nach denselben Prinzipien geschieht. Da diese Vorhersagemodelle aus vielen einzelnen Modellen (also einzelnen Bäumen) bestehen, nennt man sie auch Ensemble-Methoden (engl. ensemble methods), womit gemeint ist, dass man ein Ensemble von Vorhersagemodellen verwendet. Mitunter wird auch der Begriff baumbasierte Methode (engl. tree-based method) verwendet.
Viele Bäume konstruieren
In der Regel konstruiert man beim Machine Learning mit Entscheidungsbäumen also mehrere Hundert oder Tausende von Entscheidungsbäumen. Diese Bäume werden aus demselben Datensatz erstellt. Wenn Sie beispielsweise die Besucher einer Website untersuchen und Daten zu 1000 Besuchern haben, ist dies der Datensatz, mit dem alle Bäume aufgebaut werden. Dazu darf jeder Baum nur einen kleinen Anteil (meist ein Drittel) des gesamten Datensatzes verwenden. Dieser Anteil wird zudem vollständig zufällig ausgewählt. Der erste Baum analysiert also ein zufällig ausgewähltes Drittel aller Besucher. Der nächste Baum erhält ein neues, zufällig ausgewähltes Drittel aller Besucher und wird auf Grundlage von deren Informationen aufgebaut. Dasselbe gilt für den dritten, vierten, fünften und alle weiteren Bäume. Jeder Baum wird also mit einer zufällig ausgewählten Teilmenge der Daten aufgebaut. Auf diese Weise wird jeder Baum einzigartig.
Optimale Knoten und Splits finden
Die folgenden Koordinatensysteme zeigen denselben Datensatz mit unterschiedlichen Regeln zur Trennung der Datenpunkte. Links sehen wir Splits, die alle Farben voneinander trennen. Rechts sehen wir, dass die Kriterien (Regeln) nicht dazu führen, dass sich die Punkte vollständig voneinander trennen lassen. Damit die Vorhersage des Baumes gut wird, muss er Regeln finden, die die Beobachtungen voneinander unterscheiden können. Um dies zu erreichen, muss der Computer jeden Split bewerten. Ein guter Split zeichnet sich dadurch aus, dass sich die entstehenden Gruppen hinsichtlich des untersuchten Merkmals (in diesem Fall der Farbe) so stark wie möglich voneinander unterscheiden.
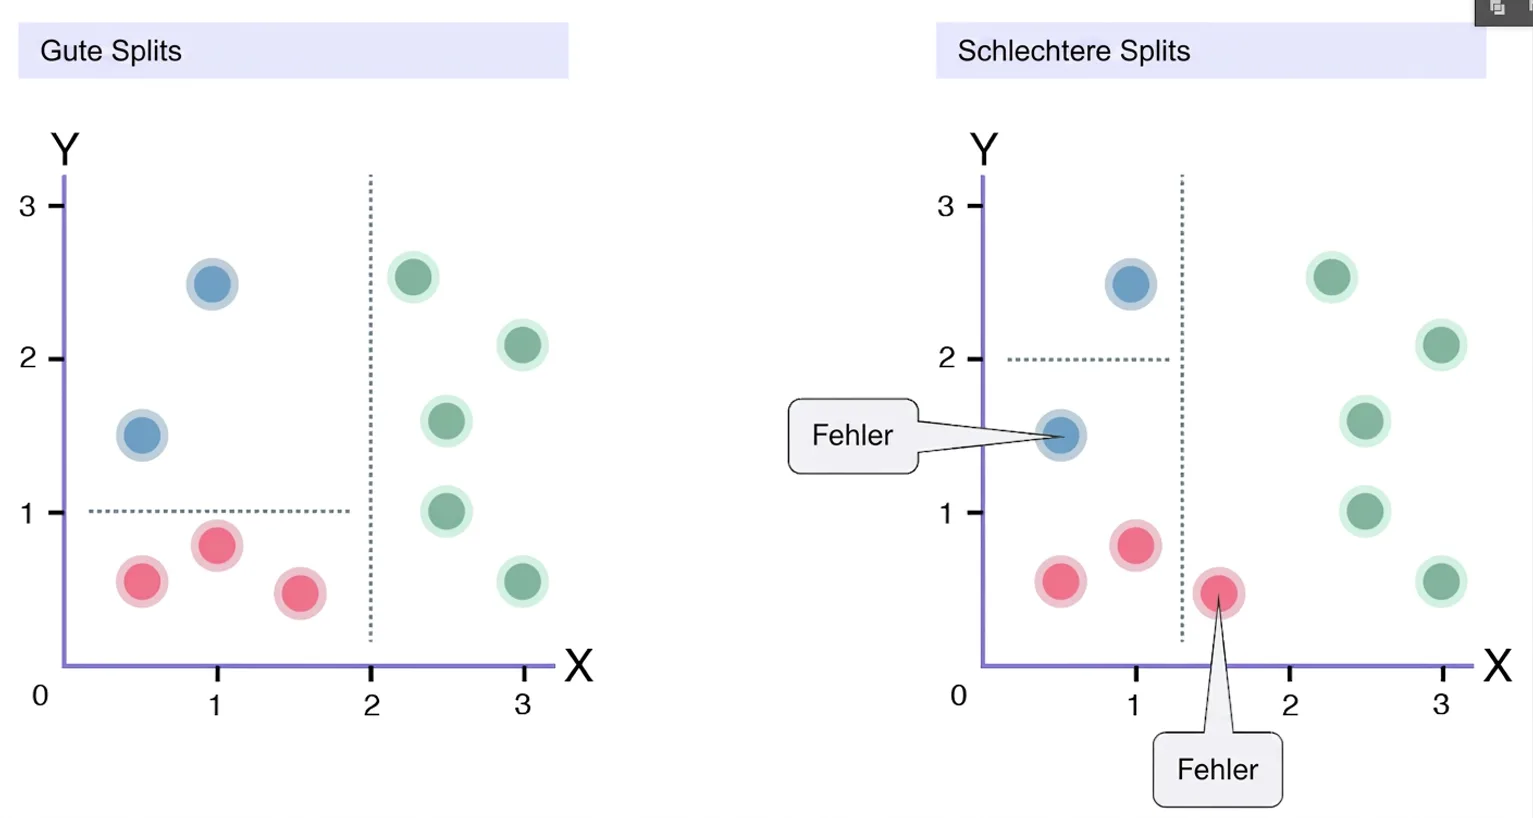
Für diese Bewertung gibt es eine Reihe verschiedener Varianten. Alle Varianten funktionieren, indem sie berechnen, wie gut verschiedene Splits die Farben voneinander trennen können. Der Computer kann sich also herantasten, um herauszufinden, welcher Split die maximale Trennung der Beobachtungen hinsichtlich ihrer Farbe ergibt.
Diese Methode zur Suche nach optimalen Splits ist allgemein und lässt sich auf alle Arten strukturierter Daten anwenden, also auf Daten im Tabellenformat (Spalten und Zeilen). Dabei spielt es keine Rolle, ob man Krebspatienten, Besucher eines Onlineshops, Sonnenstrahlen oder Autobatterien untersucht. Entscheidungsbäume sind äußerst leistungsfähig und können bei allen Arten strukturierter Daten Vorhersagen treffen. Der Grund dafür ist das allgemeine Lernverfahren, also die Berechnung, die zur Erstellung jedes Splits durchgeführt wird. Diese Art des „Lernens“ ähnelt tatsächlich der menschlichen Denkweise und erhält hier eine exakte mathematische Funktion.