Inzwischen gibt es mehrere Packages, mit denen sich Daten schnell explorieren lassen. Das Package DataExplorer wurde entwickelt, um fertige Berichte oder Teile davon zu erstellen. Es gibt mehrere ähnliche Packages, doch DataExplorer ist gut dokumentiert und umfasst die wichtigsten Methoden. Installieren und laden Sie zunächst das Package:
install.packages("DataExplorer")
library(DataExplorer)
DataExplorer kann einen formatierten Bericht erstellen, der als PDF-Datei auf der Festplatte gespeichert wird. Dazu dient die Funktion create_report() mit den Argumenten output_file (Name der Datei, die auf der Festplatte gespeichert wird), report_title (Titel des Berichts) und dem optionalen Argument y. Das Argument y wird nur angegeben, wenn die deskriptiven Auswertungen nach einer Variablen stratifiziert werden sollen. Im folgenden Code wird der Bericht nach der Spalte death stratifiziert, die angibt, ob der Patient während der Studie verstorben ist.
rhc %>%
  create_report(
    output_file="rapportfilens namn",
    report_title= "titel på rapporten",
    y="death"
  )
Anschließend befindet sich die Datei (im HTML-Format) in Ihrem Working Directory. Wenn Sie nicht wissen, wo Ihr Working Directory liegt, geben Sie den Befehl getwd() ein, der Ihr Working Directory zurückgibt (wahrscheinlich ist es derselbe Ordner, in dem sich Ihr R-Skript befindet). Der Anfang der Datei sieht folgendermaßen aus:
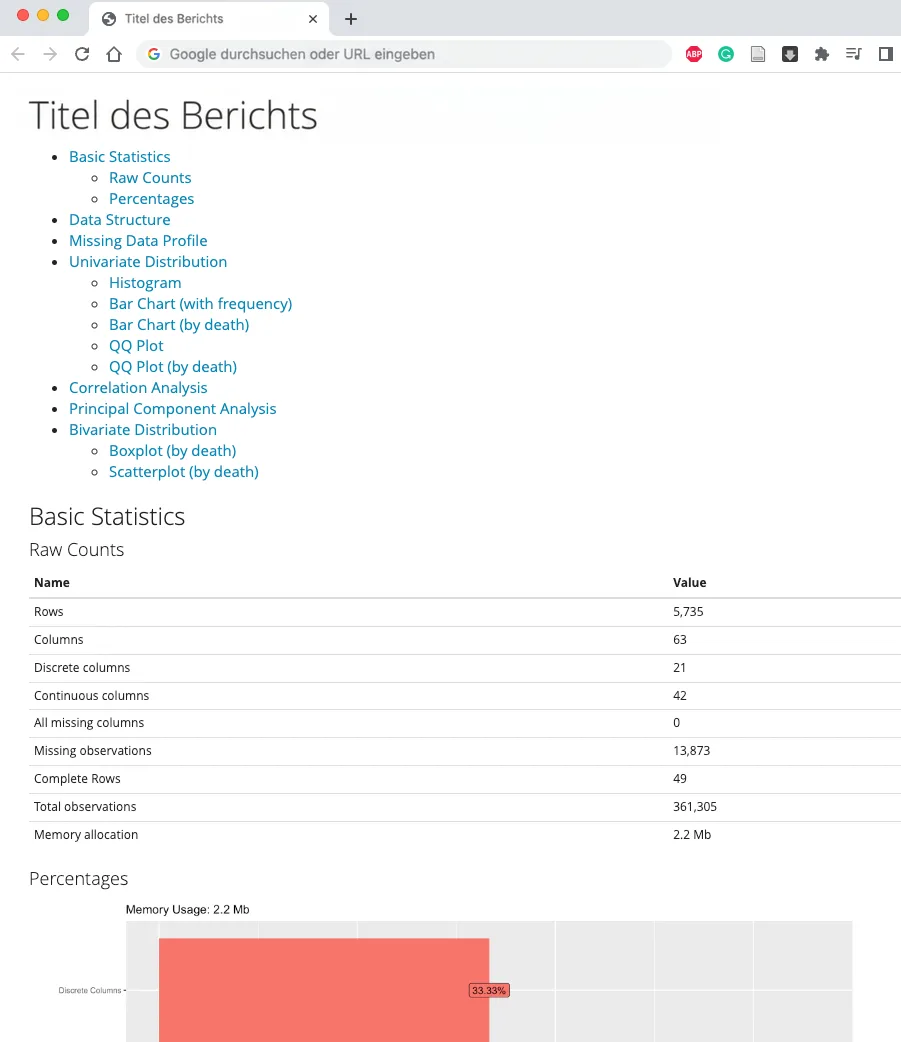
Im Folgenden zeigen wir, wie sich einzelne Komponenten des Berichts erzeugen lassen, um die Daten zu explorieren.
Beginnen Sie mit einer Gesamtbeschreibung der Daten:
introduce(rhc)| rows | columns | discrete_columns | continuous_columns | all_missing_columns | total_missing_values | complete_rows |
|---|---|---|---|---|---|---|
| 5735 | 63 | 21 | 42 | 0 | 13873 | 49 |
plot_intro(rhc)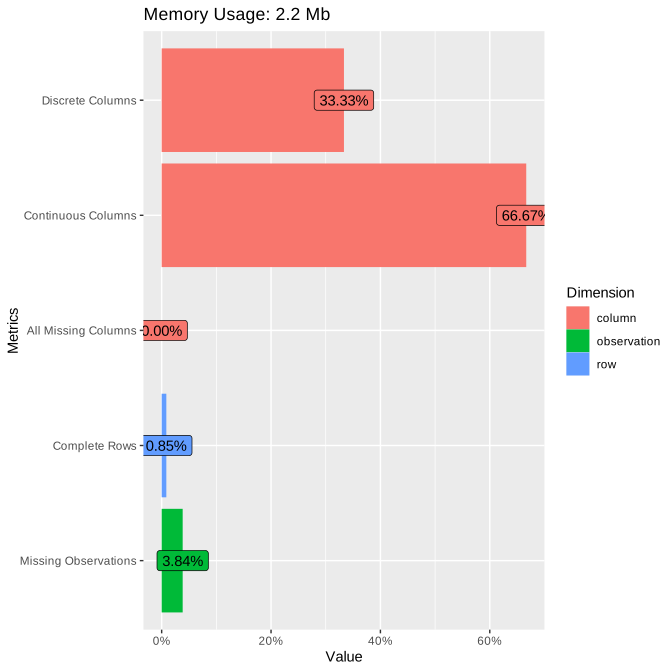
plot_missing(rhc)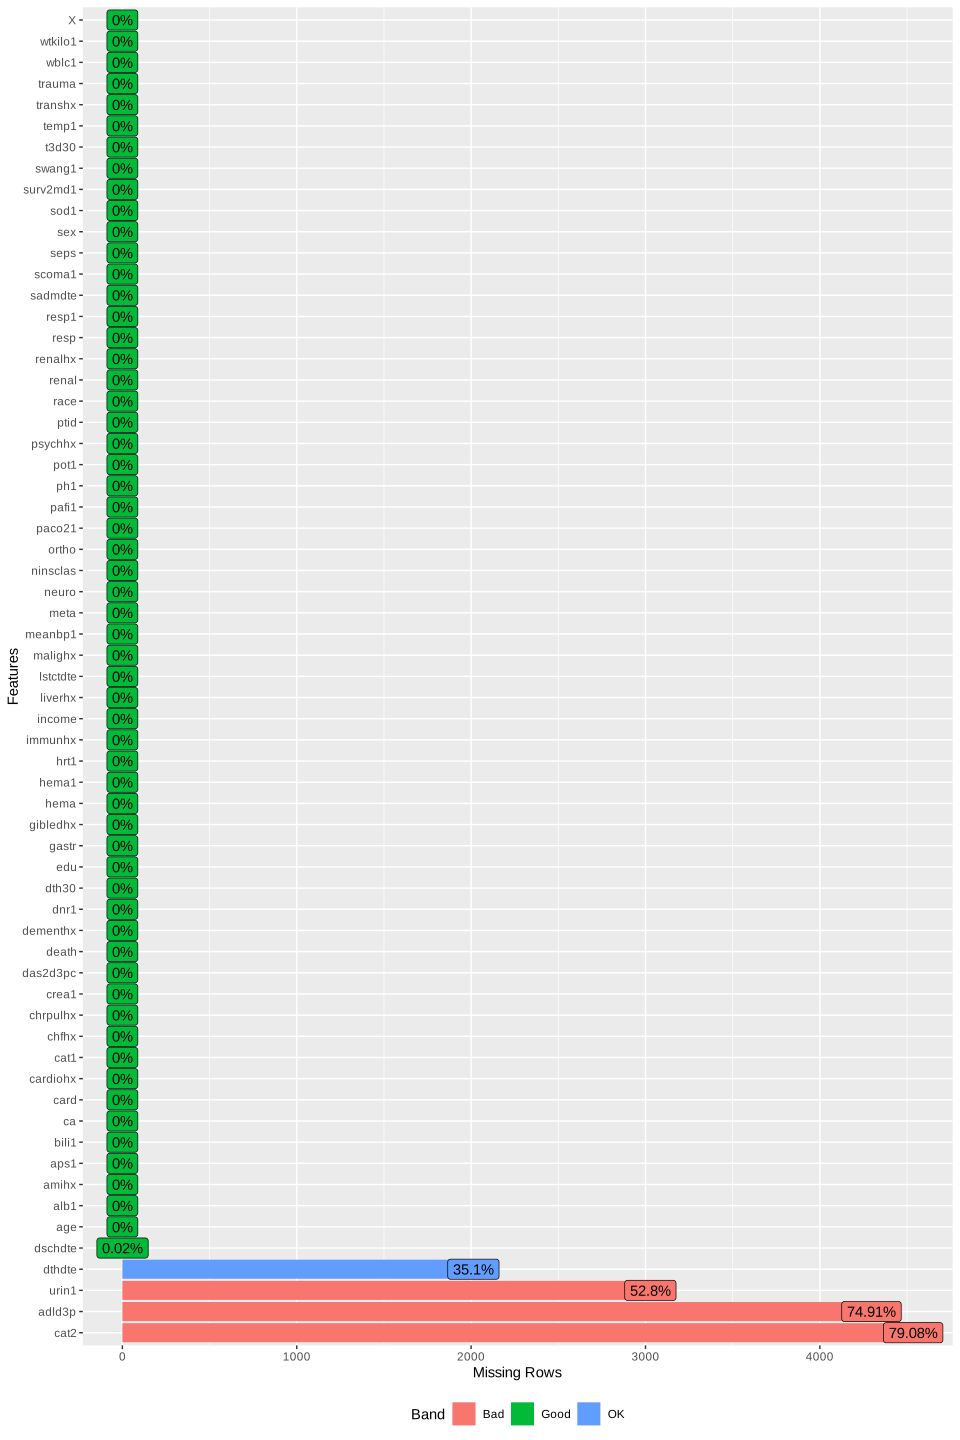
## Häufigkeiten stratifiziert nach einer Variablen
plot_bar(rhc, by = "death", nrow=20, ncol=4)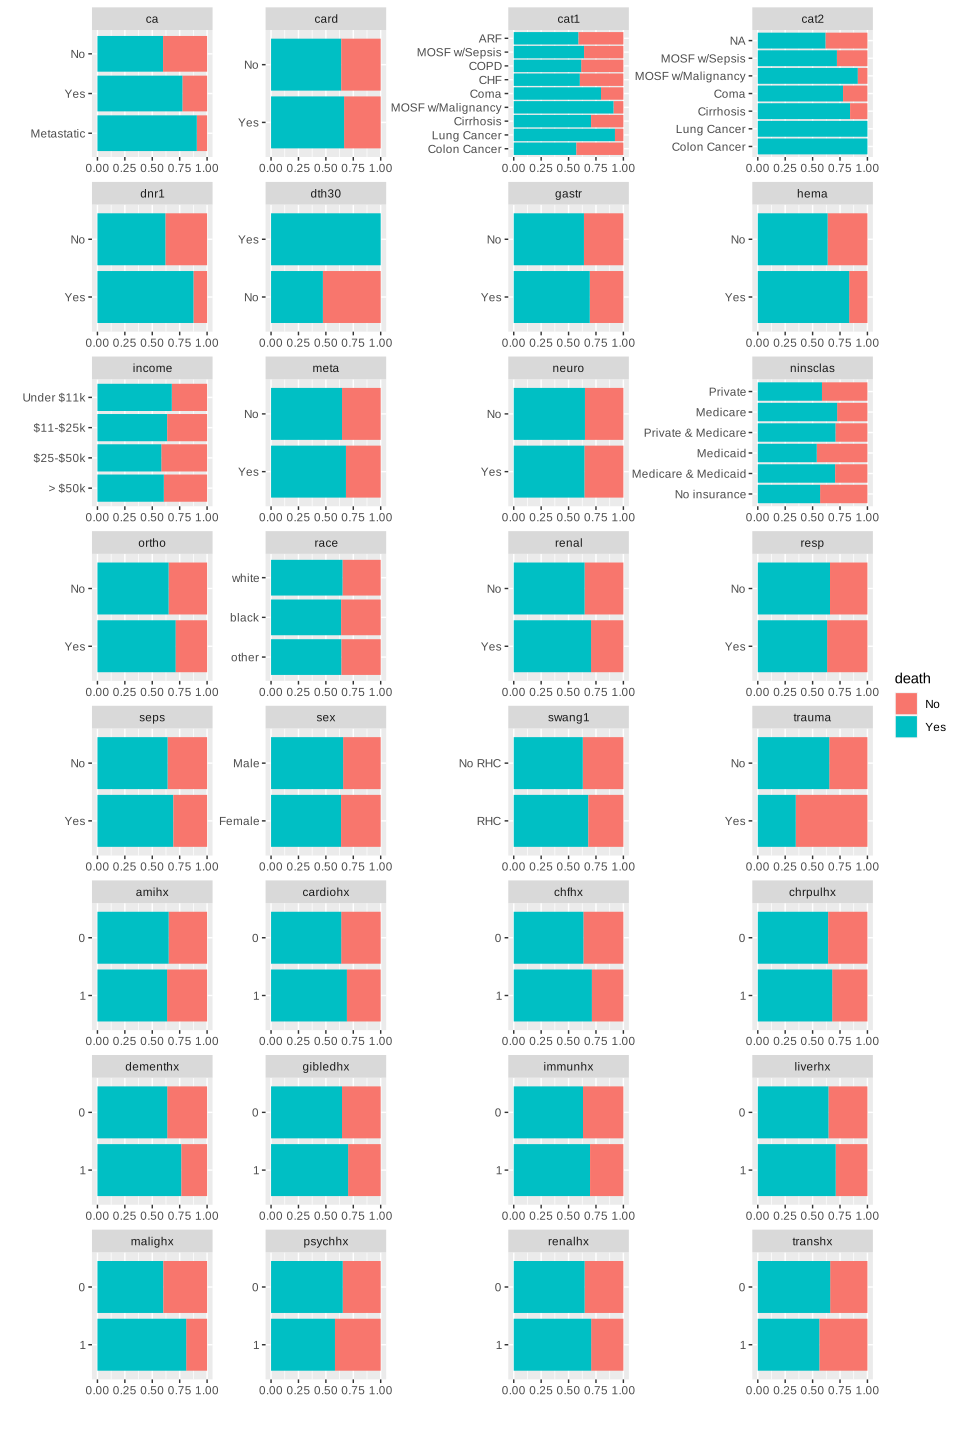
## Histogramme aller stetigen Variablen anzeigen
plot_histogram(rhc)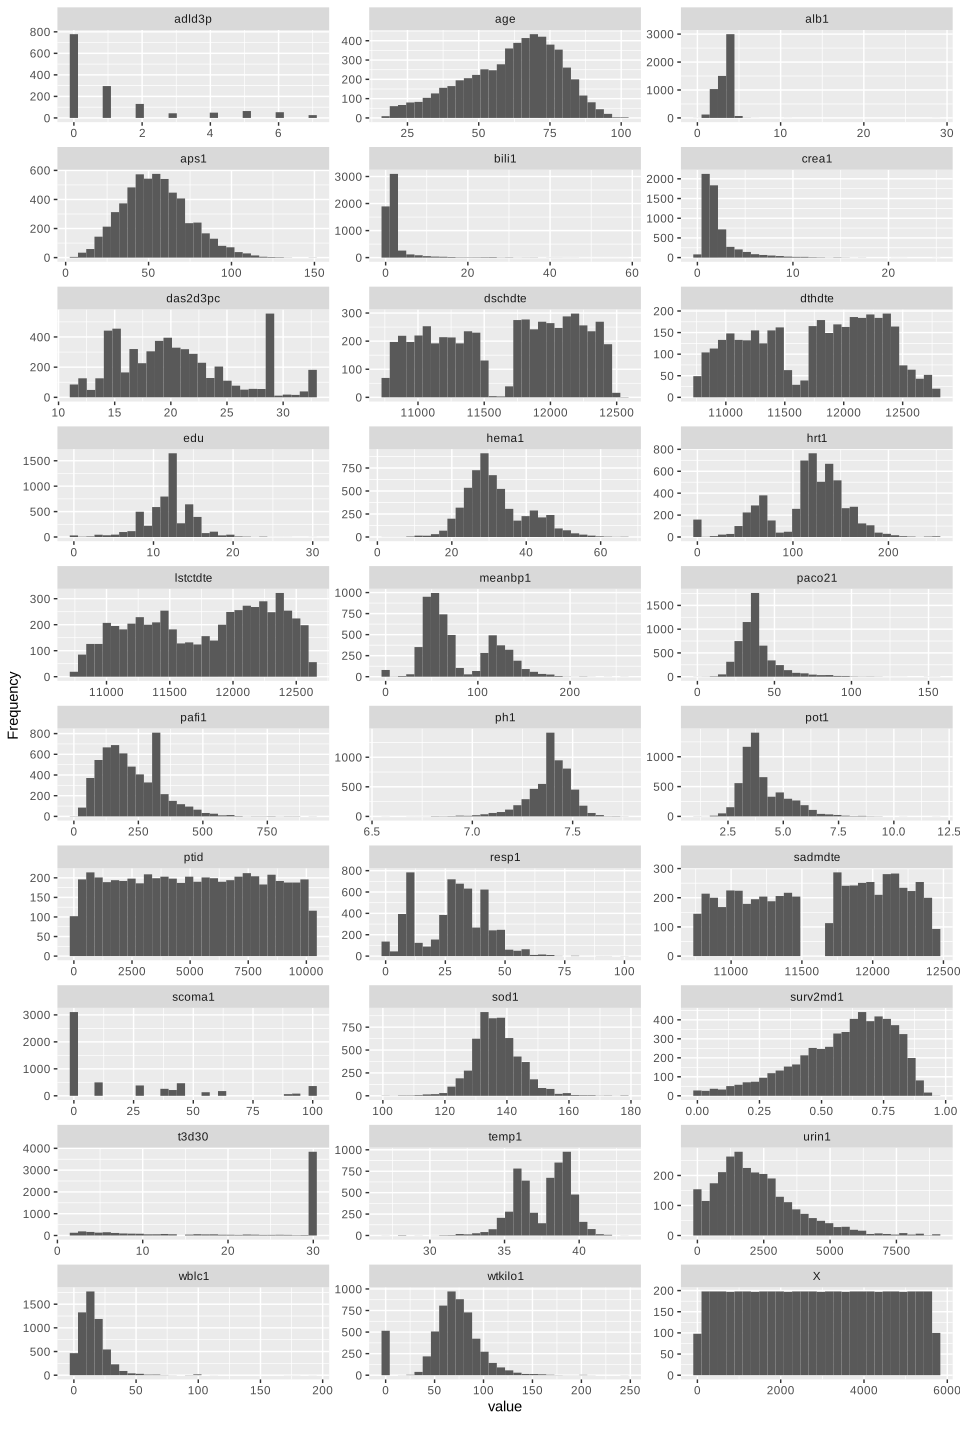
## Dichtekurven für alle stetigen Variablen
plot_density(rhc, ncol=3, nrow=10)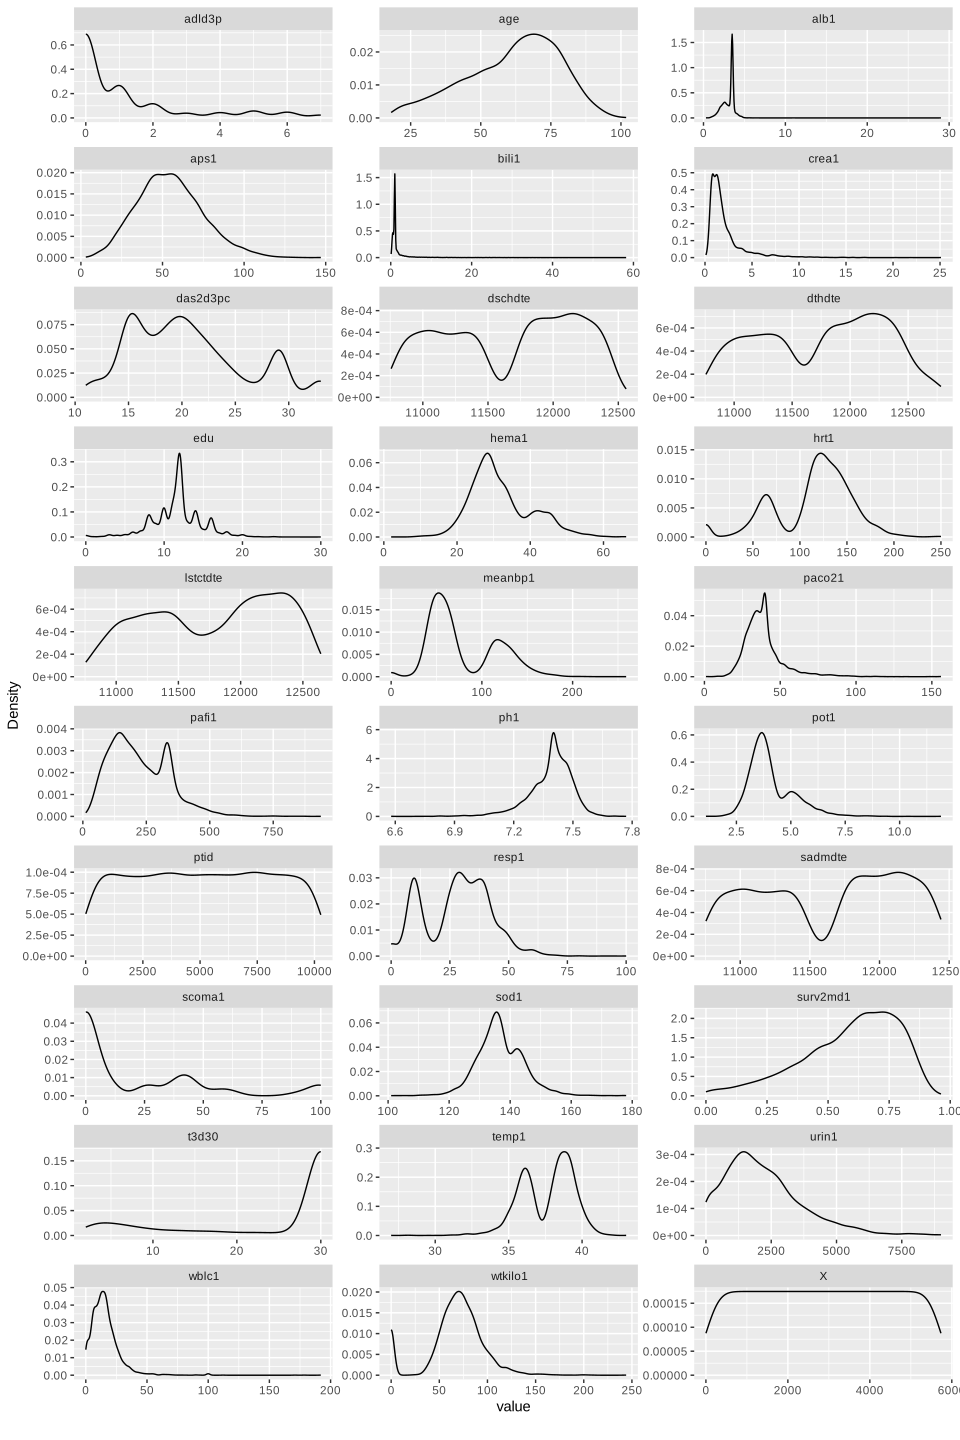
## QQ-Plots für alle stetigen Variablen
plot_qq(rhc, ncol=3, nrow=10)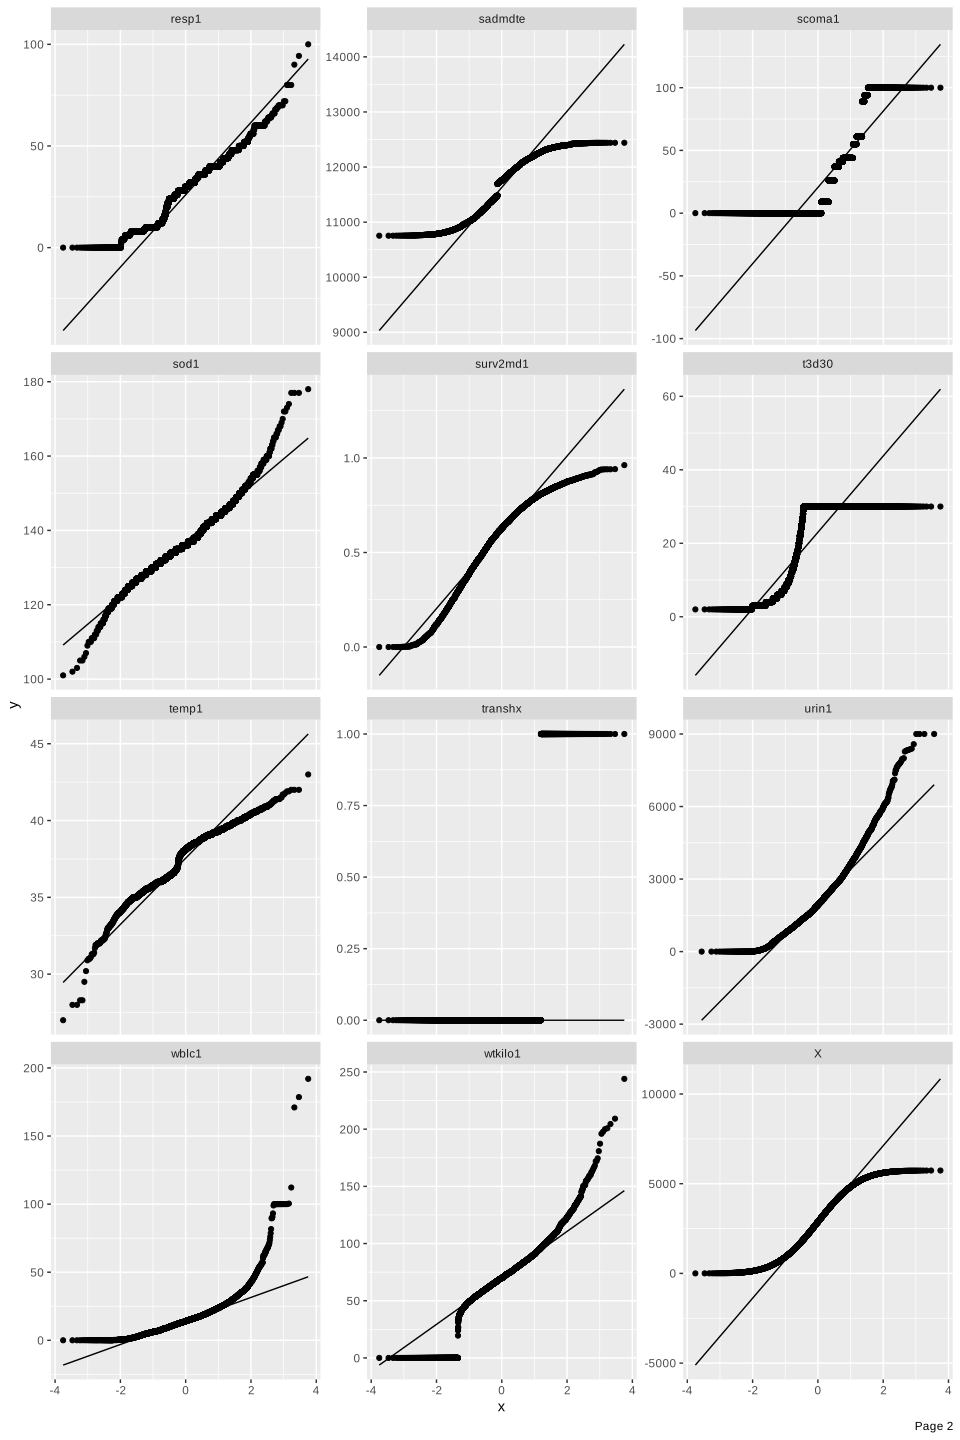
## QQ-Plots stratifiziert nach einer Spalte
plot_qq(rhc, by = "death", ncol=3, nrow=10)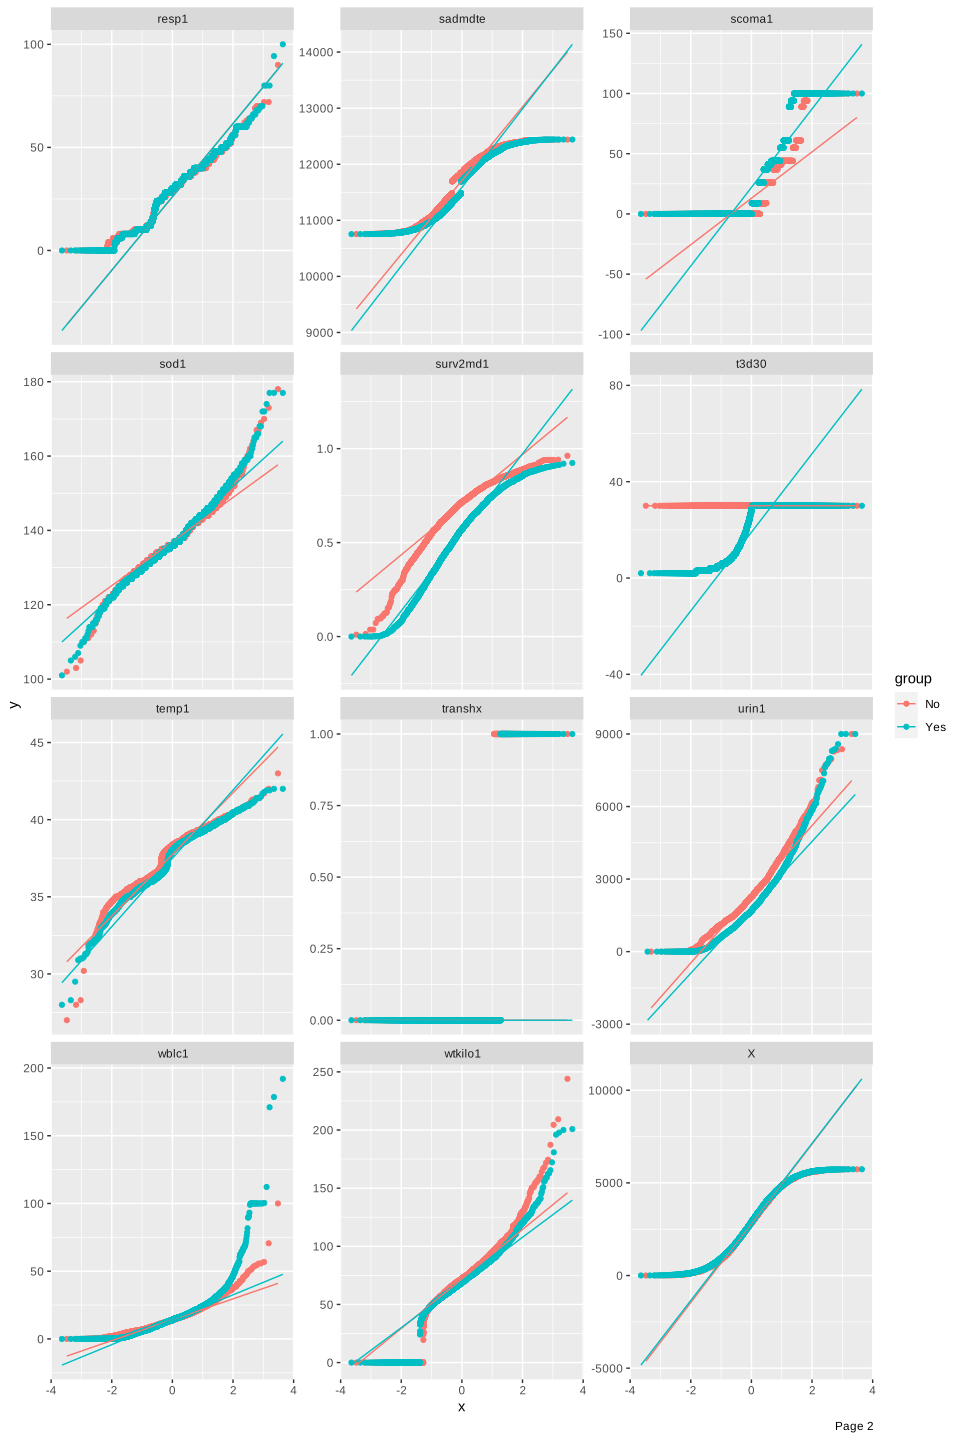
## Korrelationsmatrizen
plot_correlation(rhc)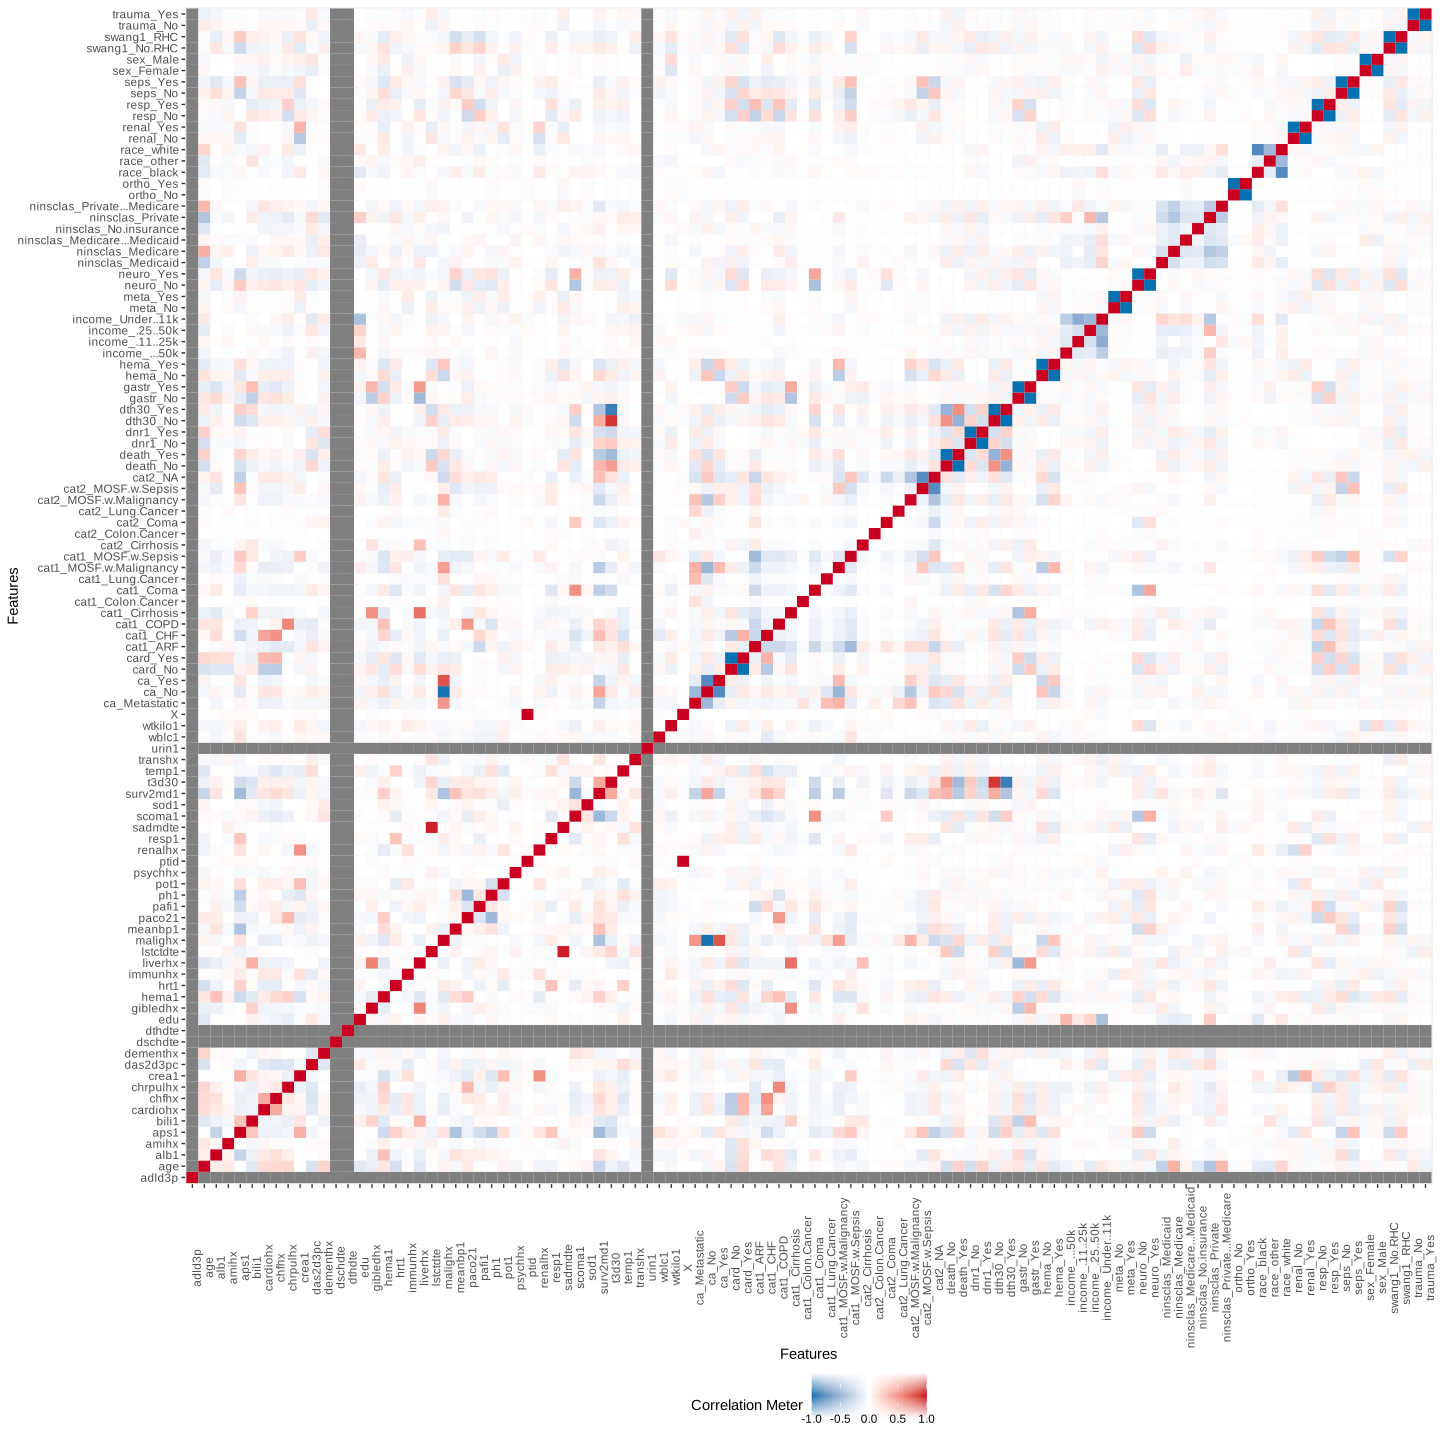
## Bivariate Verteilung stratifiziert nach einer Spalte
plot_boxplot(rhc, by = "death")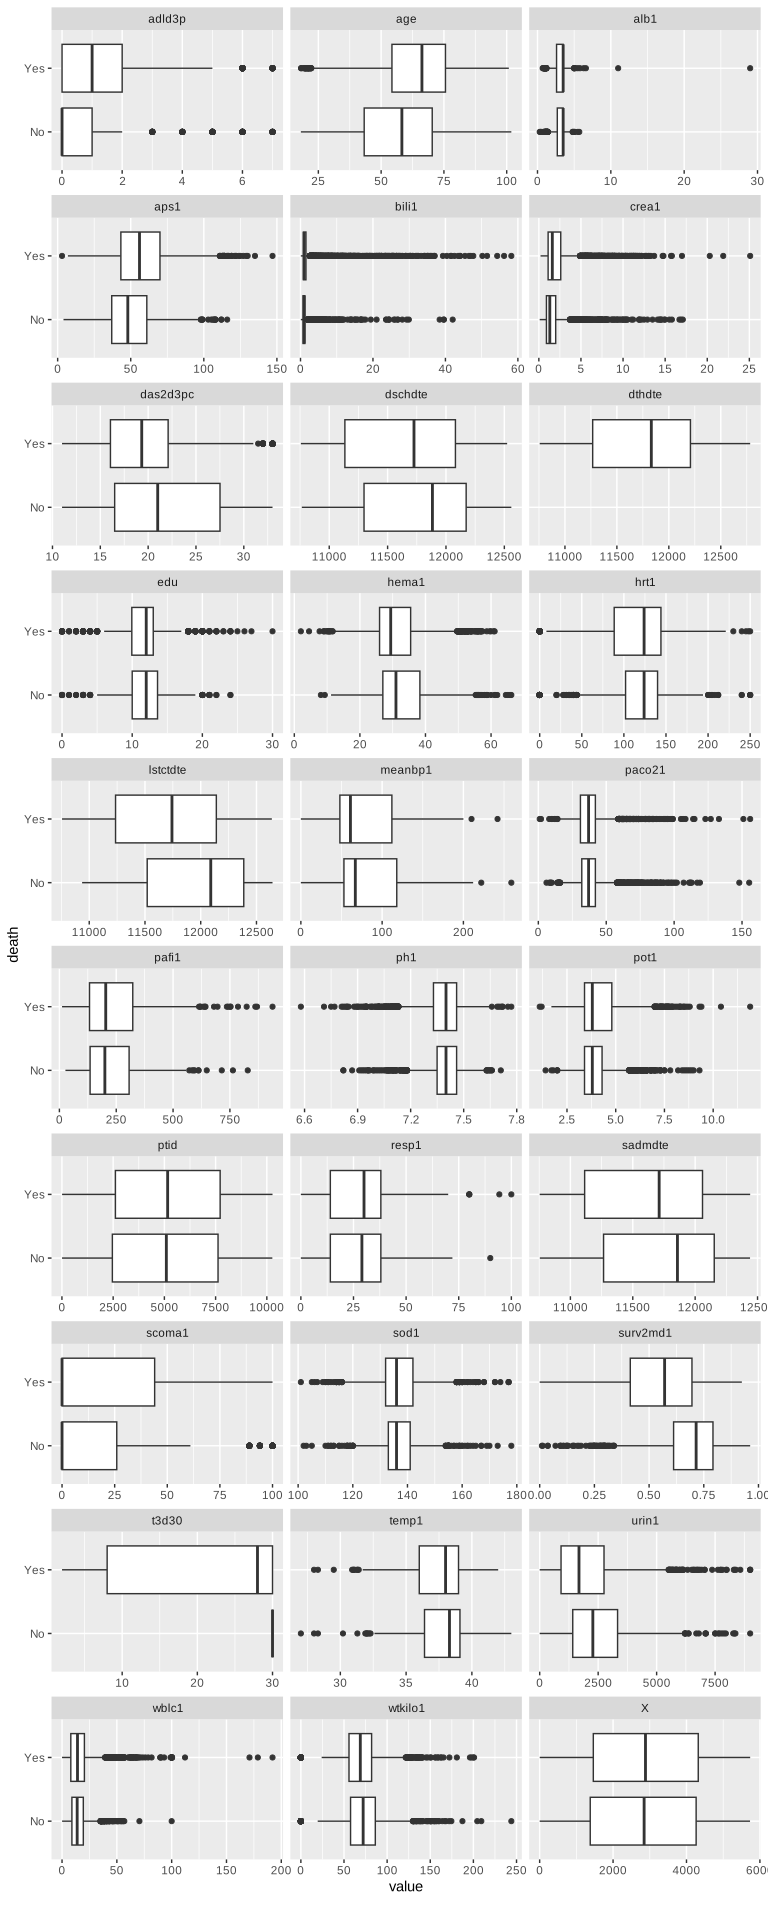
## Scatterplot `price` with all other continuous features
plot_scatterplot(split_columns(rhc)$continuous,
                 by = "age",
                 sampled_rows = 100L,
                 ncol=3, nrow=20)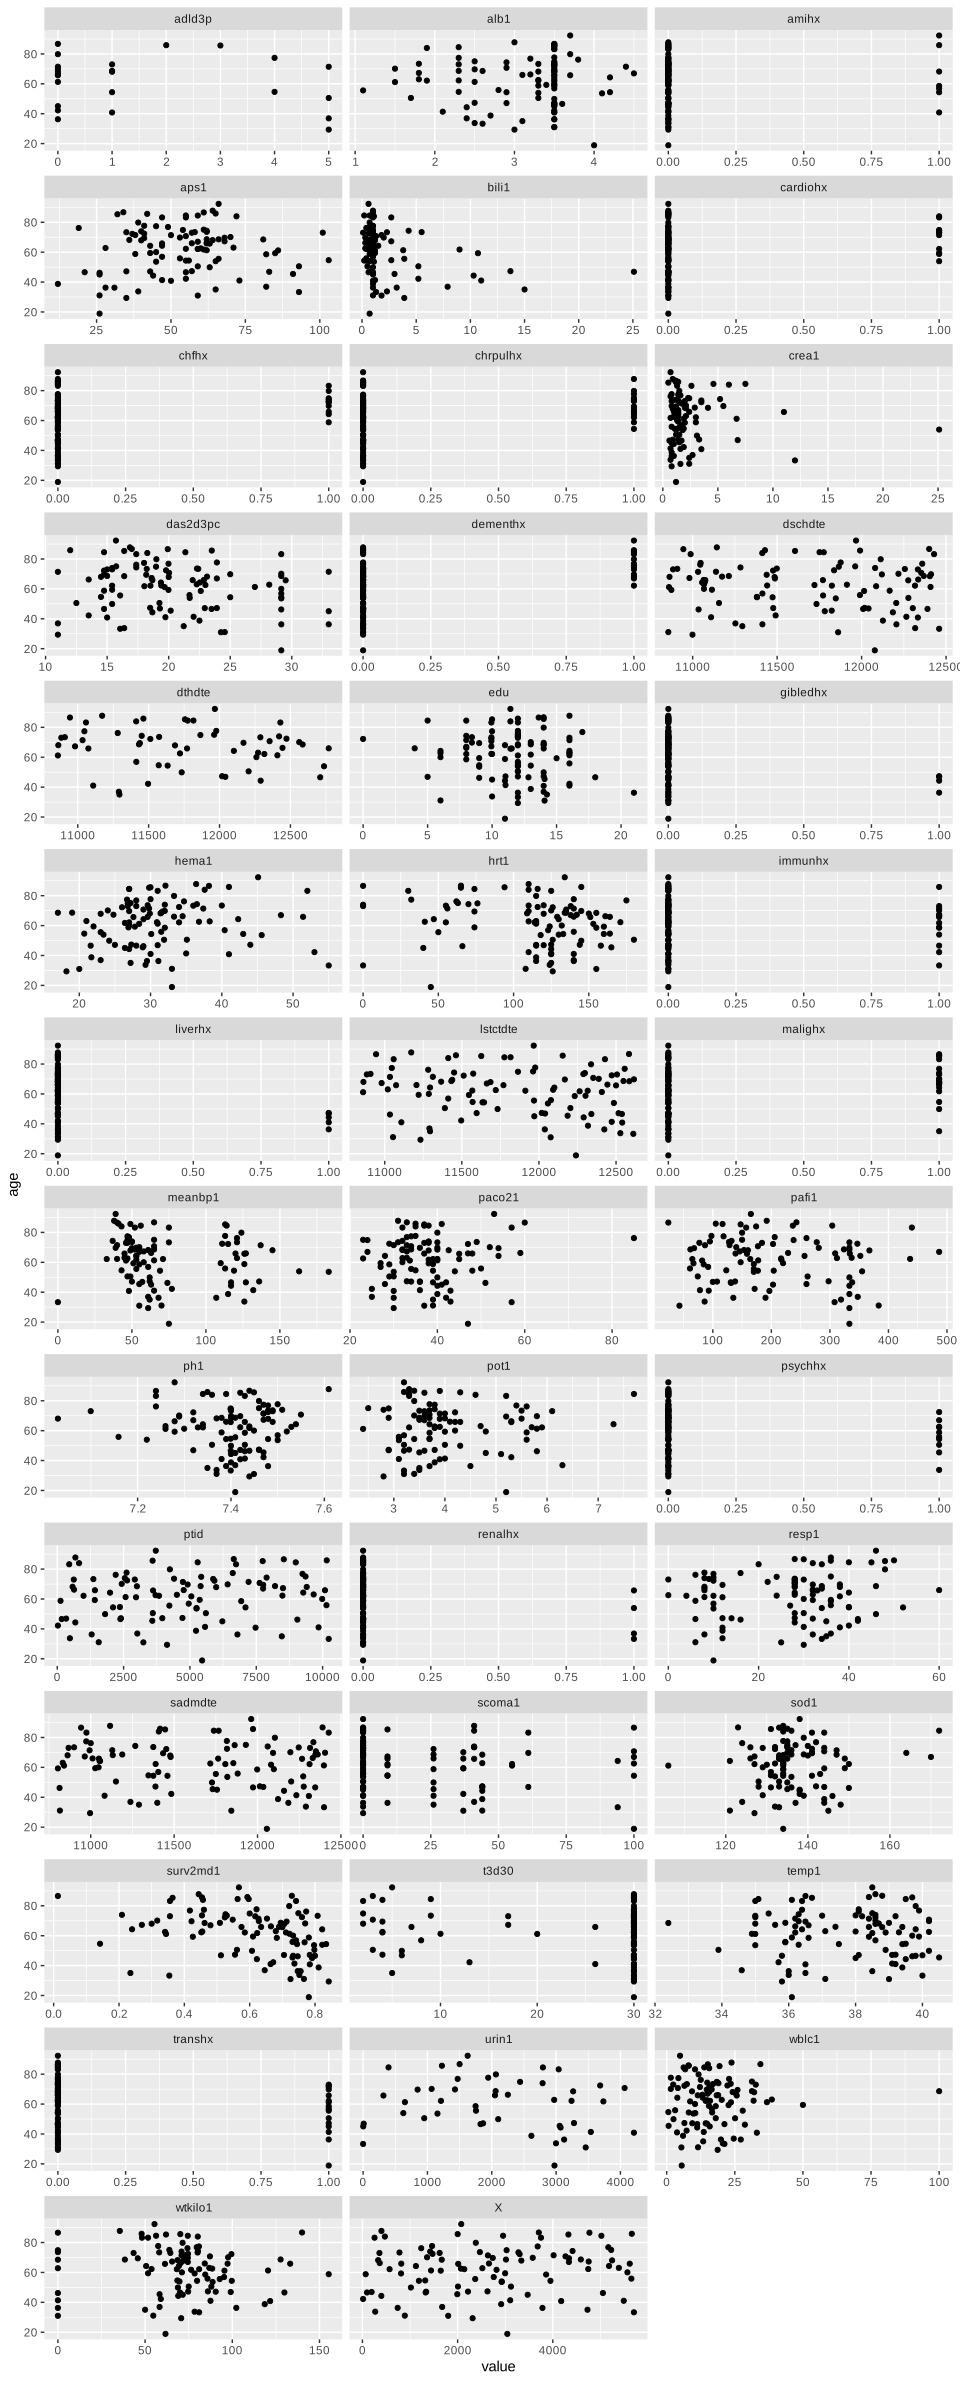
## Visualize principal component analysis
plot_prcomp(rhc, maxcat = 8L)