
Einführung
Ziel dieses Kurses ist es, Ihnen zu vermitteln, wie man Daten verarbeitet, analysiert und präsentiert. Data Science ist ein weites Feld, das alle Arten von Studiendesigns und Analysen umfassen kann. Die explosionsartige Entwicklung von Data Science in den letzten Jahren erklärt sich unter anderem durch Folgendes:
- Erhebung und Strukturierung von Daten in großem Maßstab. Durch die Digitalisierung haben sich die Möglichkeiten der Datenerhebung erweitert, und folglich erheben wir Daten in einem nie dagewesenen Tempo. Die Methoden der Datenspeicherung sind erheblich effizienter geworden. Staat, Kommunen, Regionen, Unternehmen und Organisationen erheben heute ununterbrochen große Datenmengen.
- Verbesserte Software und Hardware für die Datenanalyse. Hardware und Software für Data Science haben sich rasant weiterentwickelt, insbesondere im Bereich des maschinellen Lernens (machine learning, ML) und der künstlichen Intelligenz (KI), wo die Entwicklung in den letzten Jahren atemberaubend war. Heute ist die Software so leistungsfähig und flexibel, dass ein Anfänger innerhalb weniger Wochen beginnen kann, die fortschrittlichsten Methoden anzuwenden.
- Verbreitung von Data Science. Inzwischen gibt es online nahezu unbegrenzt Lehrmaterial zu Data Science. Diese Verfügbarkeit hat dazu geführt, dass immer mehr Menschen den Umgang mit diesen Werkzeugen erlernen. Es gibt zahlreiche Initiativen, um der Allgemeinheit Data Science näherzubringen, beispielsweise Elements of AI, dessen Ziel es ist, allen Bürgerinnen und Bürgern in Schweden und Finnland künstliche Intelligenz (KI) zu vermitteln.
- Wachsendes Interesse an Daten. Daten sind in allen Organisationen zu einer wertvollen Ressource geworden, von staatlichen Behörden bis zu kleinen und großen Unternehmen. Dies hat dazu geführt, dass sich mehr Einzelpersonen und Organisationen für Daten interessieren.
graph TD;
    A(Data Science)-->B(Medizin)
    A-->C(Finanzen);
    A-->D(Physik);
    A-->E(Chemie);
    A-->F(Biologie);
    A-->G(Gesellschaft);
    A-->H(usw.);
Abbildung 1.1: Data Science gibt es in allen Fachgebieten.
Data Science ist fachunabhängig
Sie können dieses Buch für medizinische Forschung, Finanzanalysen oder Forschung in Biologie, Chemie oder Sozialwissenschaften nutzen. Hardware, Software und Analysemethoden sind in allen Branchen identisch.
1.1 Voraussetzungen
Vorkenntnisse im Programmieren sind von Vorteil, aber für die Lektüre dieses Buches nicht erforderlich. Jeder kann lernen, R effektiv zu nutzen. Je besser Sie Code schreiben können, desto leichter wird Ihre Arbeit. Ihre Fähigkeit, Code zu schreiben, wird nahezu linear mit der Zeit wachsen, die Sie ins Lernen investieren.
1.2 Zielsetzung
Dieses Buch vermittelt Ihnen die Grundlagen, um selbst eine Studie durchführen zu können. Allein durch die Lektüre dieses Buches werden Sie jedoch nicht zum Experten. Um wirklich versiert zu werden, ist weitere Vertiefung nötig, und in diesem Buch finden Sie passende Hinweise, wo diese Vertiefung möglich ist. Sie werden allerdings feststellen, dass dieses Buch weit trägt und Ihnen die Grundlagen liefert, die Sie für die Arbeit mit den Methoden und Themen benötigen, die Sie am meisten betreffen.
Gute Referenzwerke sind wichtig, um sich vertiefen zu können. Für statistische Methoden und Machine Learning empfehlen wir:
- Elements of Statistical Learning
- Fundamentals of Clinical Trials
- Applied Predictive Modelling
- Deep Learning with R
- Tidy Modeling with R
1.3 Programmieren in R
R ist eine interpretierte Sprache (engl. interpreted language), was bedeutet, dass Sie Befehle eingeben müssen, um Operationen (beispielsweise Berechnungen) auszuführen. Programmieren oder Coden bedeutet, Befehle zu schreiben. Auf Ihre Anweisung hin versucht R, diese Befehle auszuführen.
1.3.1 Warum programmieren, wenn man auch klicken kann?
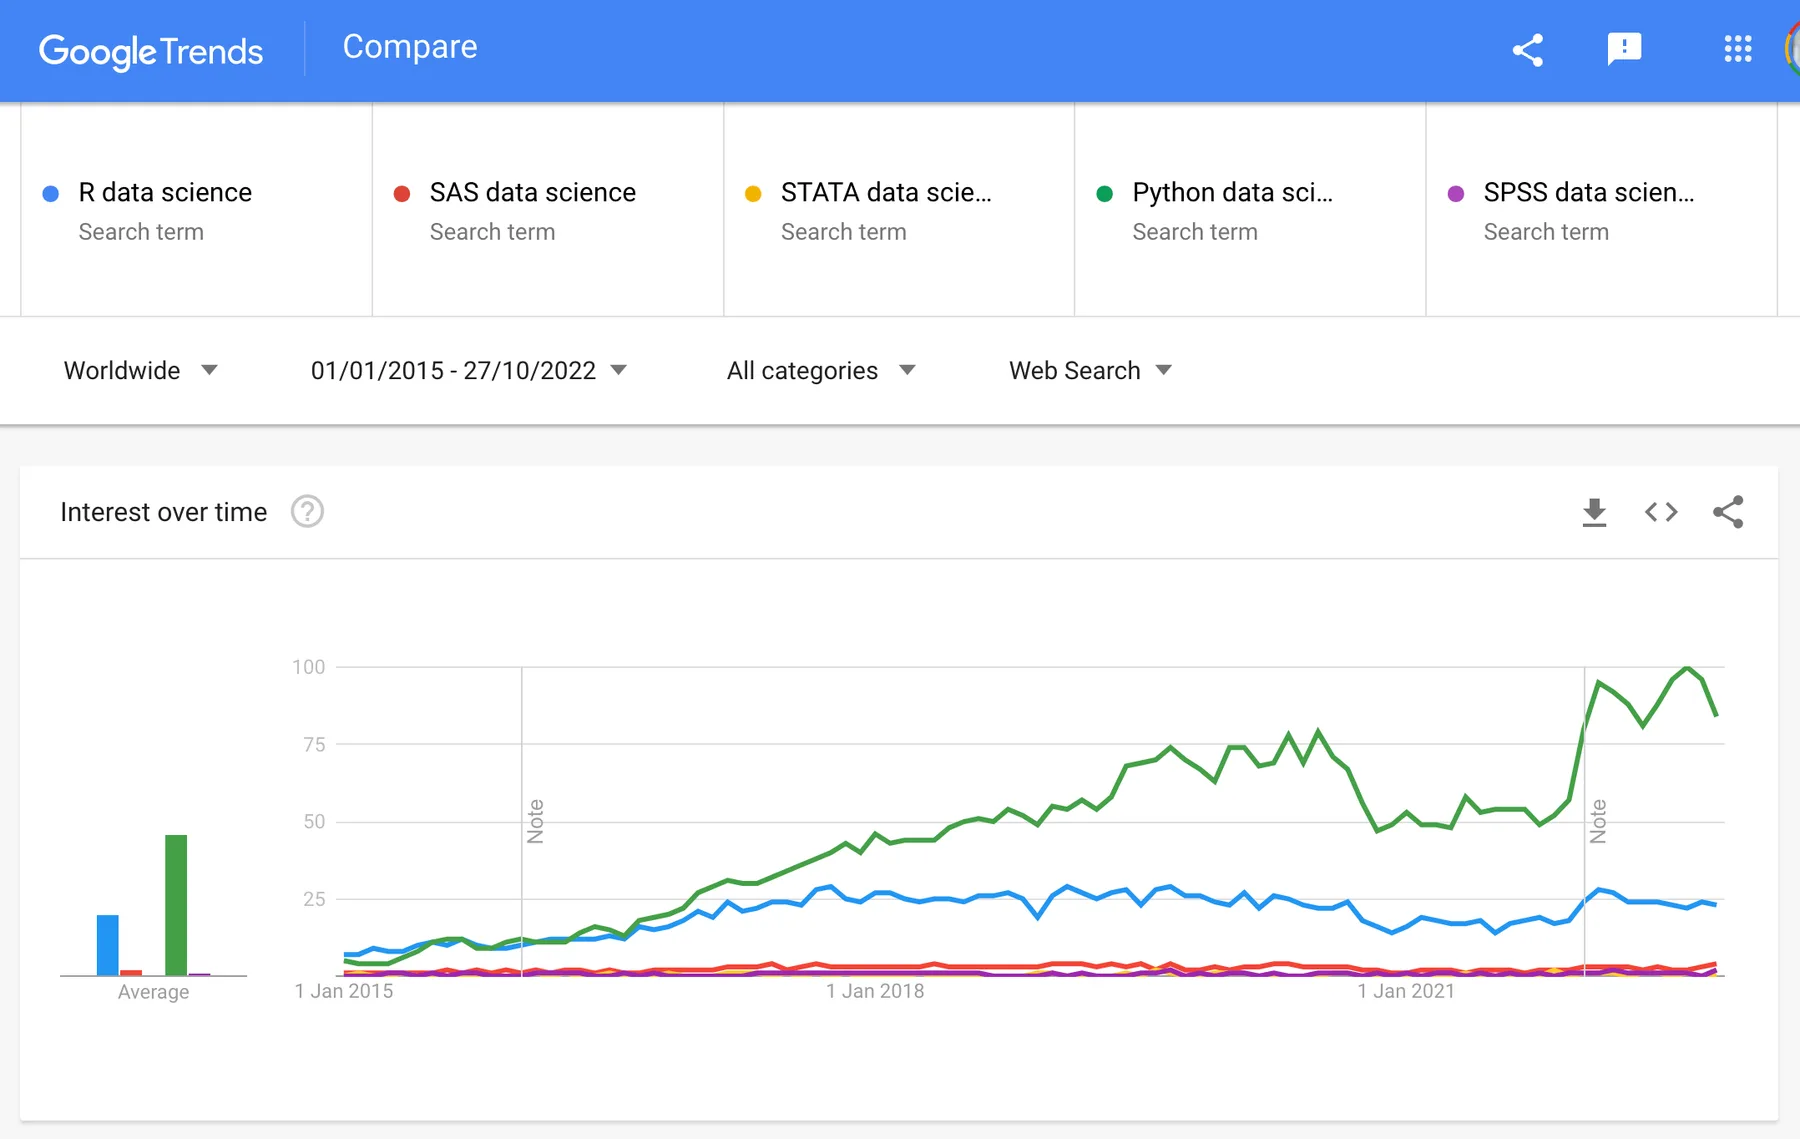
Es gibt einen grundlegenden Unterschied zwischen interpretierten Sprachen und Programmen mit grafischer Benutzeroberfläche (beispielsweise SPSS, Excel usw.). Auch wenn Programme wie Excel und SPSS einfach und bequem erscheinen, weil man allein durch Klicken analysieren kann, haben sie deutliche Einschränkungen. So ist es beispielsweise schwierig, den Überblick über alle getätigten Klicks zu behalten, was es nahezu unmöglich machen kann, die Ergebnisse zu reproduzieren. Zudem sind diese Programme auf die Funktionen beschränkt, die der Hersteller anbietet. Wenn Sie R (oder Python) verwenden, können Sie Ihren Code Zeile für Zeile nachverfolgen und genau analysieren, was Sie getan haben. Sie können Ihre Befehle jederzeit anpassen und erhalten sofort aktualisierte Ergebnisse. Außerdem haben Sie Zugang zu den neuesten Methoden und Techniken, da Hunderttausende Experten täglich an der Weiterentwicklung von R (und Python) arbeiten. R und Python sind kostenlos und dominieren heute den Markt für Forschung, Data Science und Statistik (Abbildung 1.2). Es gibt kommerzielle Sprachen (beispielsweise SAS, Stata), deren Nutzung jedoch jedes Jahr zugunsten von R und Python abnimmt.
1.4 Arbeitsablauf
Abbildung 1.3 zeigt, welche Schritte in einer typischen Studie durchgeführt werden.
graph TD; A(Daten importieren)--> B(Daten inspizieren)--> C(Daten aufbereiten und transformieren)--> D(Daten visualisieren)--> E(Daten beschreiben)--> F(Prädiktionsmodelle erstellen)--> H(Ergebnisse kommunizieren)Abbildung 1.3: Schritte einer Studie.
Um Daten in R zu analysieren, müssen die Daten zunächst importiert werden. Sie können praktisch jede Art von Daten in R importieren (SAS, STATA, SPSS, Excel, CSV usw.). Nach dem Import der Daten ist eine sorgfältige Inspektion durchzuführen. Die Inspektion soll die Beschaffenheit der Spalten und Zeilen erfassen.
Für die Spalten (Variablen) umfasst dies unter anderem:
- Erfassung, welche Variablentypen vorliegen und ob R den Variablentyp korrekt interpretiert hat: Eine numerische Variable (z. B. Körpergewicht) muss von R als numerisch (numerical) interpretiert werden, um fehlerhafte Analysen zu vermeiden.
- Erfassung und Anpassung der verschiedenen Ausprägungen (levels) kategorialer Variablen: Nicht numerische Variablen sind in R meist Faktoren (factor). Die Ausprägungen jeder Faktorvariablen müssen geprüft und bei Bedarf angepasst werden.
- Erfassung des Anteils fehlender Werte (missing) für jede Variable: Fehlende Daten sind in nahezu allen Analysen ein Problem. Es ist wichtig zu erfassen, wie groß das Problem ist und ob und wie es behoben werden kann.
- Erfassung der Verteilungen der Variablen: Einfache Beschreibungen der Verteilungen der Variablen (Maximum, Minimum, Mittelwert, Median usw.) sind zu erstellen.
- Erstellung neuer Variablen (Spalten).
Für die Zeilen (Beobachtungen) umfasst dies unter anderem:
- Klärung, ob die Zeilen eindeutige Individuen darstellen.
- Klärung, ob dasselbe Individuum mehrfach in den Daten vorkommen kann.
Wichtige Begriffe
- Visualisierung: Erstellung von Grafiken und Abbildungen.
- Deskription: Einfache mathematische Beschreibungen von Daten. Beispielsweise die Verwendung von Mittelwerten und Standardabweichung zur Beschreibung von Verteilungen.
- Prädiktion: Verwendung eines Modells, um eine Vorhersage über einen Endpunkt oder einen Wert zu treffen. Ein Beispiel für einen Endpunkt ist Tod (ja/nein), ein Beispiel für einen Wert ist Gewichtsabnahme in Kilogramm. Man kann vorhersagen (prädizieren), ob ein Patient überleben wird oder nicht oder wie viel Gewicht eine Person verlieren wird.
- Prädiktionsmodell (statistisches Modell): Prädiktionsmodelle werden verwendet, um (1) Zusammenhänge zwischen Variablen zu beschreiben oder (2) Vorhersagen zu treffen. Sie werden entweder mit klassischer Regressionsanalyse oder mit maschinellem Lernen erstellt. Alle Modelle stellen eine mathematische Beschreibung der Daten dar. Sie können verwendet werden, um den Effekt von Variablen zu schätzen (z. B. wie Cholesterin das Herzinfarktrisiko beeinflusst) oder Vorhersagen zu treffen (z. B. wie hoch das Risiko ist, einen Herzinfarkt zu erleiden).
- Tidy Data: Daten, in denen Spalten Variablen und Zeilen Beobachtungen darstellen.
- Data Wrangling: Aufbereitung von Daten, sodass Analysen durchgeführt werden können.
- Visualisierung von Daten ist fast immer wichtig. Visualisierung kann als Teil der Inspektion, der Deskription oder der Darstellung der Endergebnisse erfolgen.
Häufig werden außerdem statistische Modelle (Prädiktionsmodelle) erstellt, um Zusammenhänge zwischen Variablen zu untersuchen oder um Prädiktionsmodelle zu entwickeln. Meist lässt sich dasselbe Modell sowohl zur Untersuchung von Zusammenhängen als auch für Vorhersagen verwenden.
1.5 Data Frame
Daten zu importieren bedeutet einfach, dass Sie Daten öffnen und in R verfügbar machen. Mit Daten ist meist eine rechteckige Tabelle aus Zeilen und Spalten gemeint. Die Zeilen sind Beobachtungen (beispielsweise Patienten) und die Spalten sind Variablen. In R heißen diese Tabellen data frames, häufig abgekürzt als df.
| Name | Alter | Einkommen | Ausbildung | Cholesterin |
|---|---|---|---|---|
| Adam | 45 | 324211 | Hochschule | 4,5 |
| Zara | 51 | 198765 | Grundschule | 7,6 |
| John | 49 | 250643 | Gymnasium | 3,2 |
Beispiel für einen Data Frame.
1.5.1 Andere Datentypen
Mit R können Sie Data Frames, Fotos, Illustrationen, Tonaufnahmen und Videos analysieren. Da sich dieses Buch an Anfänger richtet, stehen Data Frames im Mittelpunkt.
1.5.2 Software
- R: R ist eine Sprache und Software für Datenverarbeitung und Grafik.
- RStudio: RStudio wurde entwickelt, um die Arbeit mit R zu erleichtern. Ab Oktober 2022 ändert RStudio seinen Namen in
Posit. Um mit R zu arbeiten, starten Sie einfach RStudio. Mit RStudio erstellen Sie außerdem Berichte im PDF-, EPUB- und HTML-Format. - Package (Paket): Sie können den Funktionsumfang von R erweitern, indem Sie Packages installieren. Es stehen etwa 16000 Packages zur Verfügung.
1.6 Über R und RStudio
R ist eine Sprache, die speziell für die Analyse und Visualisierung von Daten entwickelt wurde. R ist für diesen Zweck äußerst leistungsfähig. Keine andere Sprache ist ebenso leistungsfähig, flexibel und vielseitig. R wurde an den Bell Laboratories (früher AT&T, heute Lucent Technologies) von John Chambers und Kollegen entwickelt. Zur Standardinstallation von R kommen weitere 16000 Packages hinzu, was enorme Möglichkeiten eröffnet.
1.6.1 R installieren
Laden Sie R (Desktop-Version) von CRAN (The Comprehensive R Archive Network) herunter: https://cloud.r-project.org.
- R herunterladen und installieren. Wählen Sie das passende Betriebssystem.
- Installieren Sie es wie gewohnt auf Ihrem Computer.
1.6.2 RStudio installieren
RStudio ist eine sogenannte IDE (integrated development environment, integrierte Entwicklungsumgebung), also ein Programm, das das Programmieren erleichtert. RStudio macht es einfacher, den Überblick über Skripte, Dateien, Grafiken und Dokumente zu behalten. RStudio können Sie hier herunterladen: http://www.rstudio.com/download.
- RStudio herunterladen und installieren. Die kostenlose Version reicht völlig aus.
- Installieren Sie es wie gewohnt auf Ihrem Computer.
RStudio sieht aus wie in Abbildung 1.4 dargestellt.
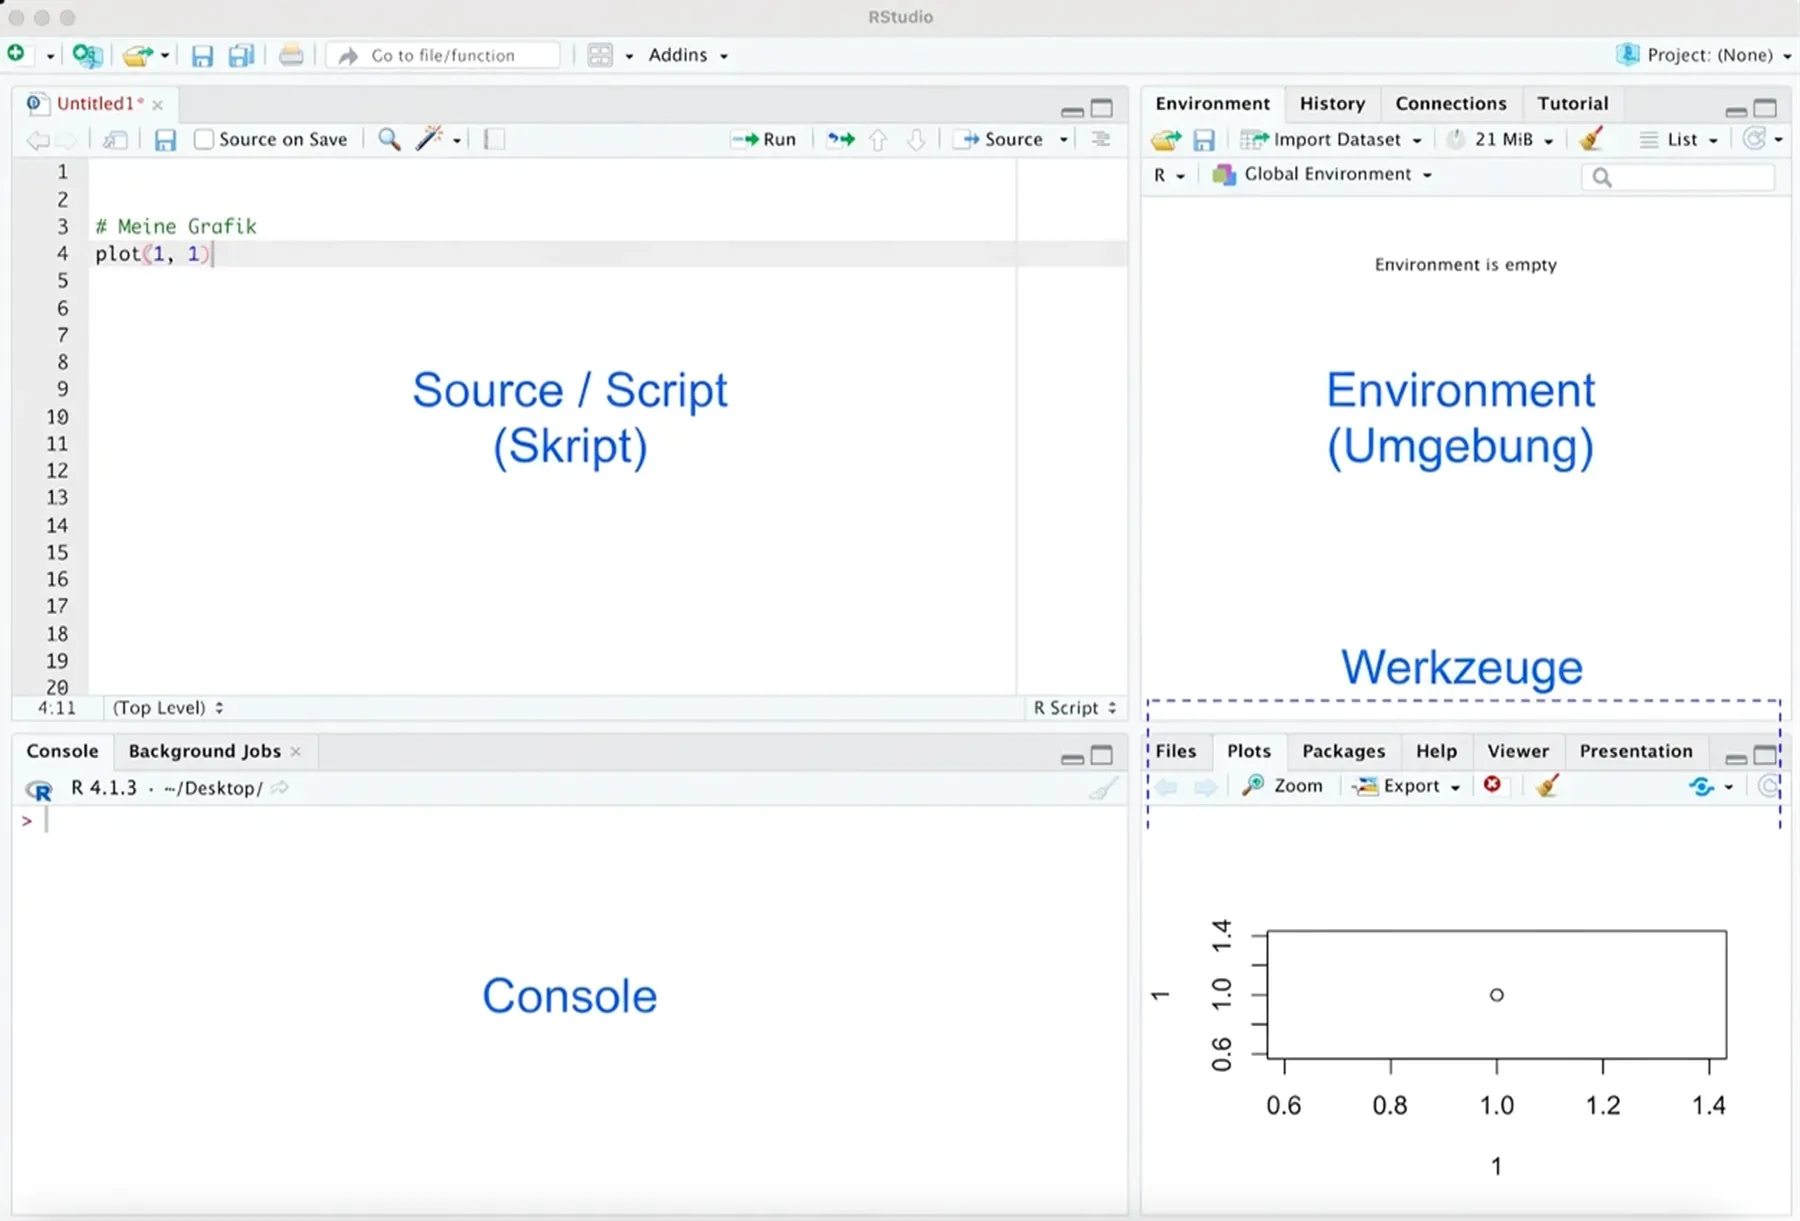
Beachten Sie in Abbildung 1.4, dass RStudio vier Fenster hat. Oben links befindet sich Source/Script, das zum Schreiben und Speichern von Code (Skripten) dient. In dieses Fenster werden Sie Ihren Code schreiben. Unter Source/Script befindet sich die Console, die zum Ausführen kurzer Befehle genutzt werden kann. In der Console erfahren Sie auch, ob Ihr Skript ausgeführt werden konnte.
1.7 Code in R ausführen
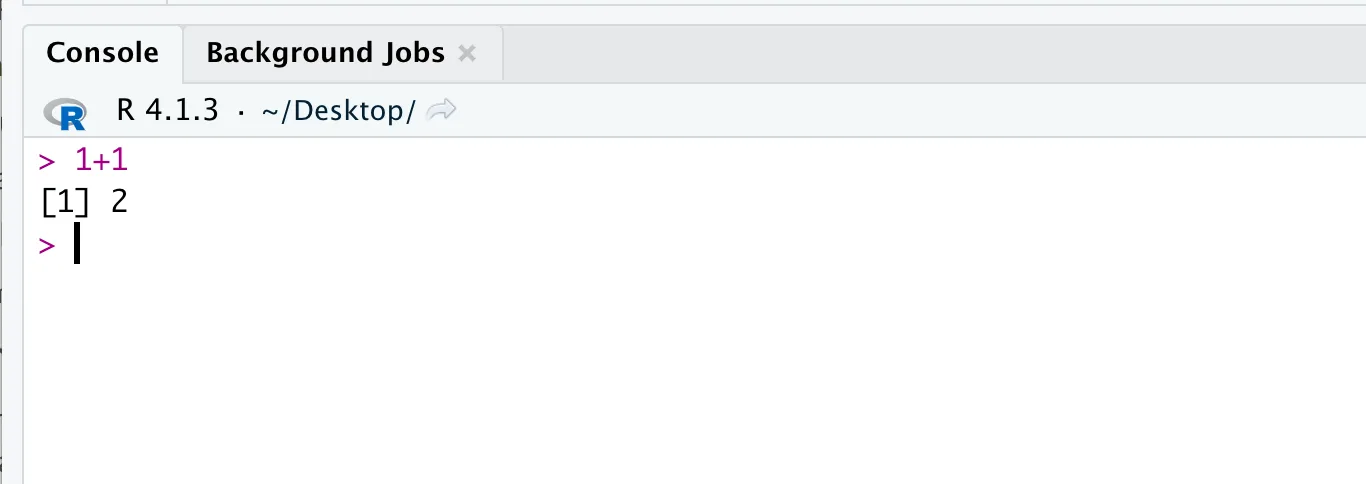
Um Code in der Console auszuführen, geben Sie Ihren Befehl in der letzten Zeile ein und drücken Enter. In Abbildung 1.5 sehen Sie ein Beispiel, in dem der Befehl 1+1 ausgeführt wird.
Um Code in Source/Script auszuführen, markieren Sie die Zeilen, die Sie ausführen möchten, und klicken oben rechts im Fenster auf Run.
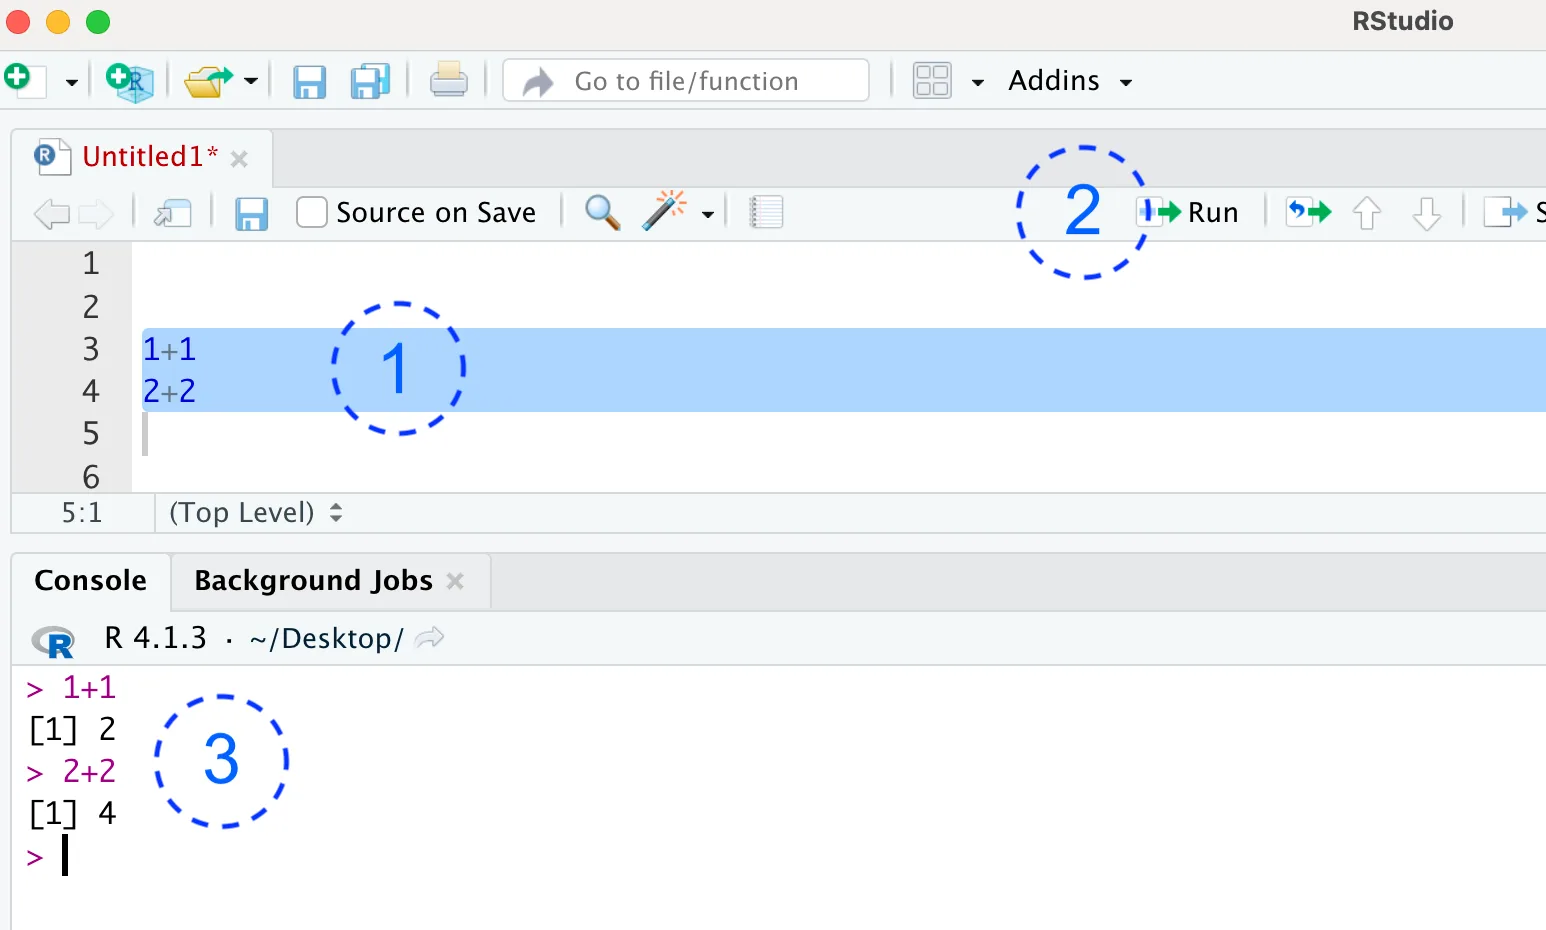
Wie in Abbildung 1.4 zu sehen, gibt es in R zwei weitere Fenster, nämlich Environment (Umgebung) und Werkzeuge. Unter Environment sehen Sie alle Data Frames und anderen Objekte, die Sie erstellen und importieren. Unter Werkzeuge sehen Sie mehrere Bereiche (Files, Plots, Packages, Help usw.). Abbildung 1.7 zeigt, dass diese Bereiche Ihre Dateien, die von Ihnen erstellten Grafiken, die verfügbaren Packages und die Hilfedokumentation zu allen Packages und Funktionen darstellen.
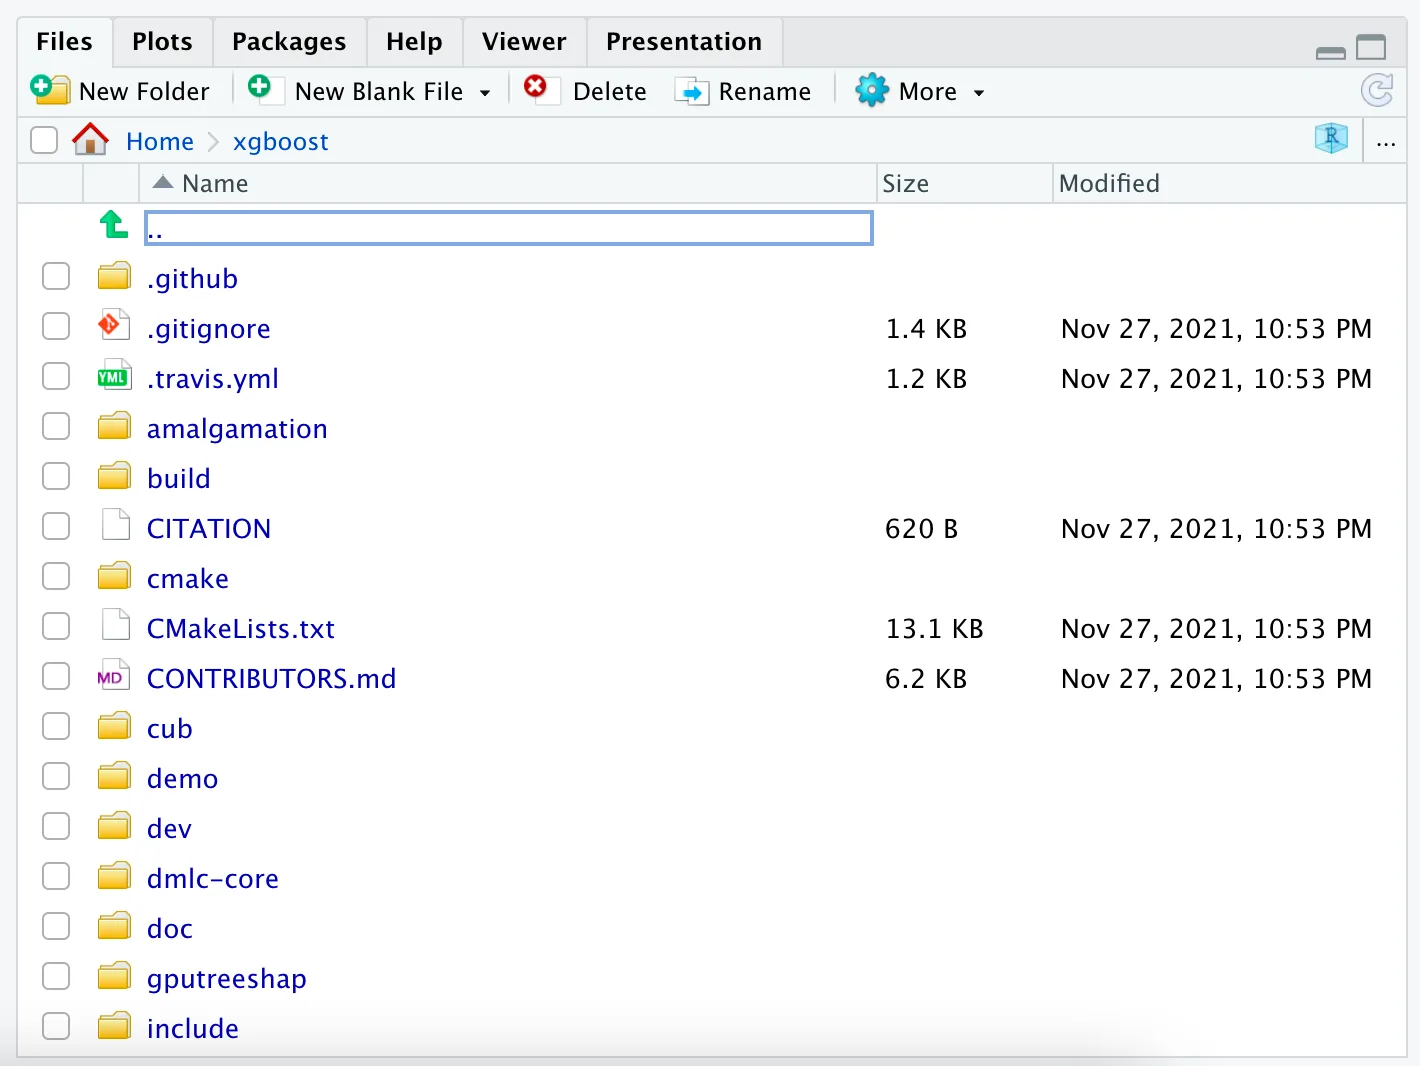
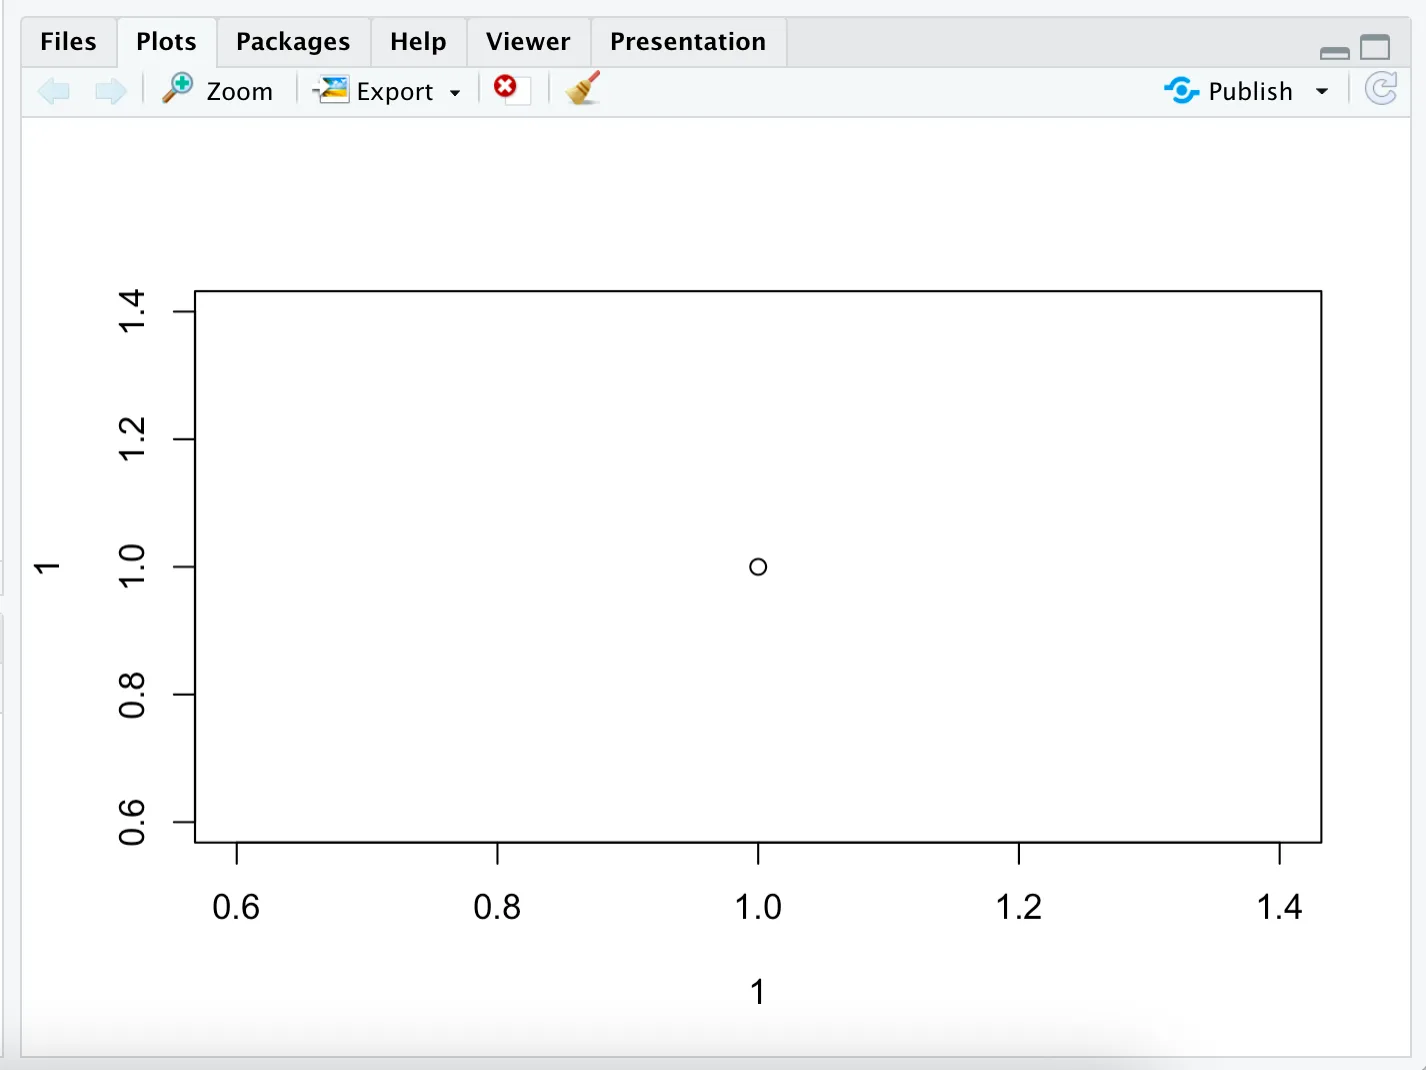
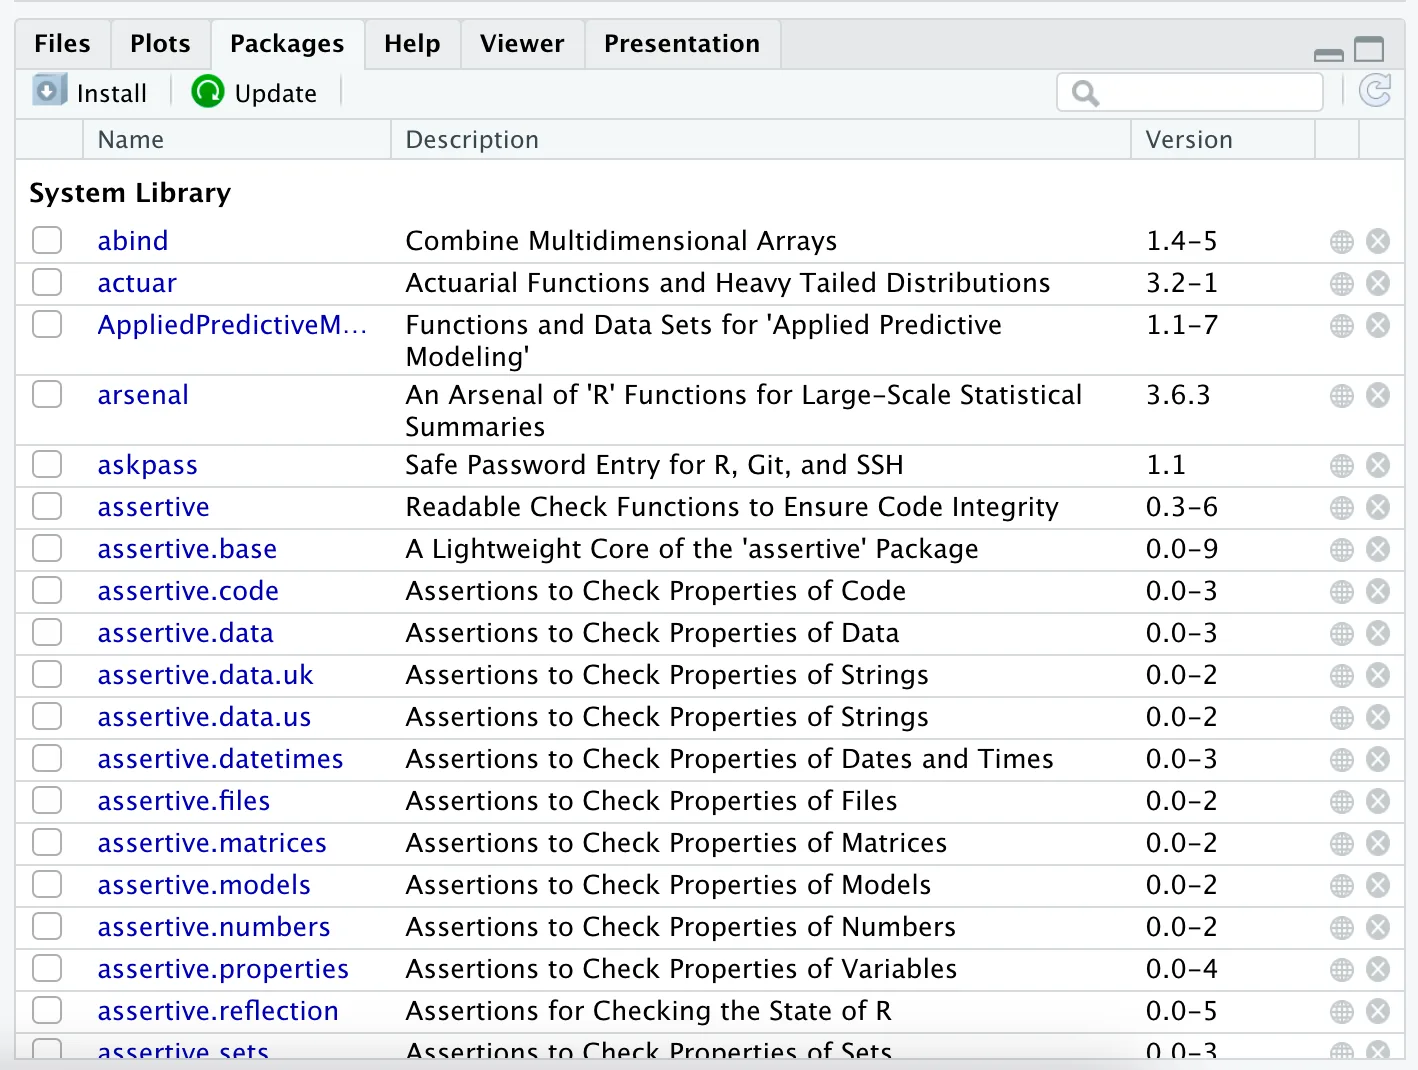
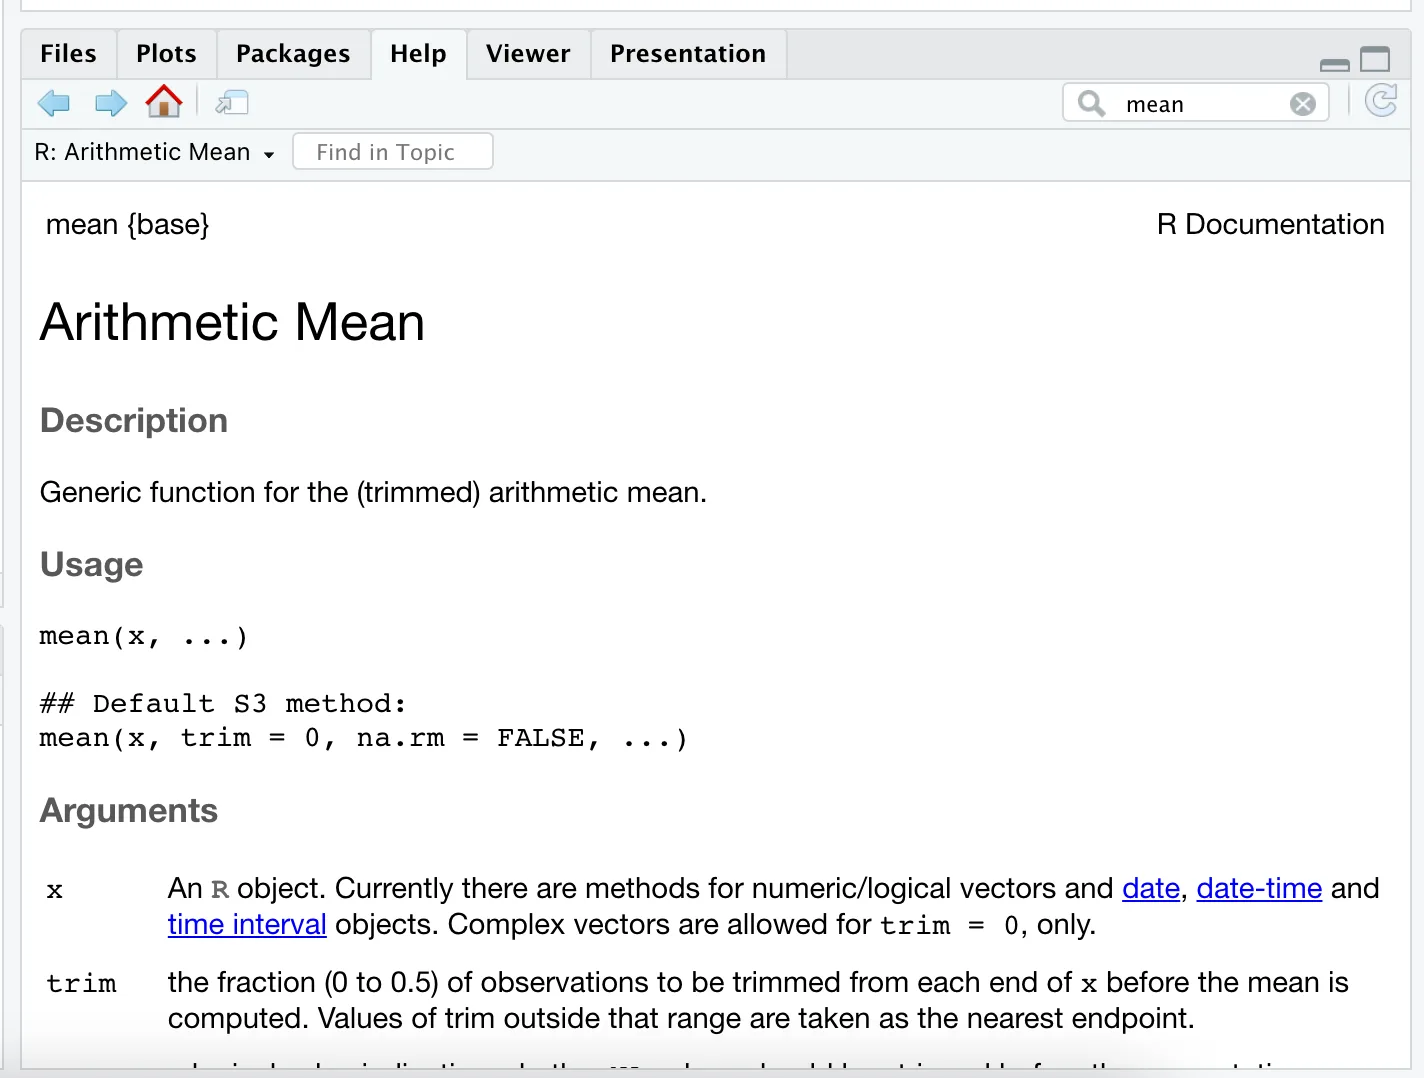
Abbildung 1.7: Werkzeuge in RStudio.