
Funktionen zur Inspektion von Rohdaten
Base R (die Grundinstallation von R) enthält Funktionen, mit denen sich Rohdaten inspizieren lassen. Die Funktion View() zeigt die Daten in einer Tabelle an, die durchsucht und sortiert werden kann. Das ist nützlich, um Rohdaten manuell zu überprüfen.
In diesem Kapitel arbeiten wir mit den Daten rhc, die im vorigen Kapitel vorgestellt wurden. Falls Sie die Daten noch nicht heruntergeladen haben, können Sie dies gemäß der Anleitung im vorigen Kapitel nachholen.
View(rhc)Dieses Fenster öffnet sich, wenn Sie View() verwenden:
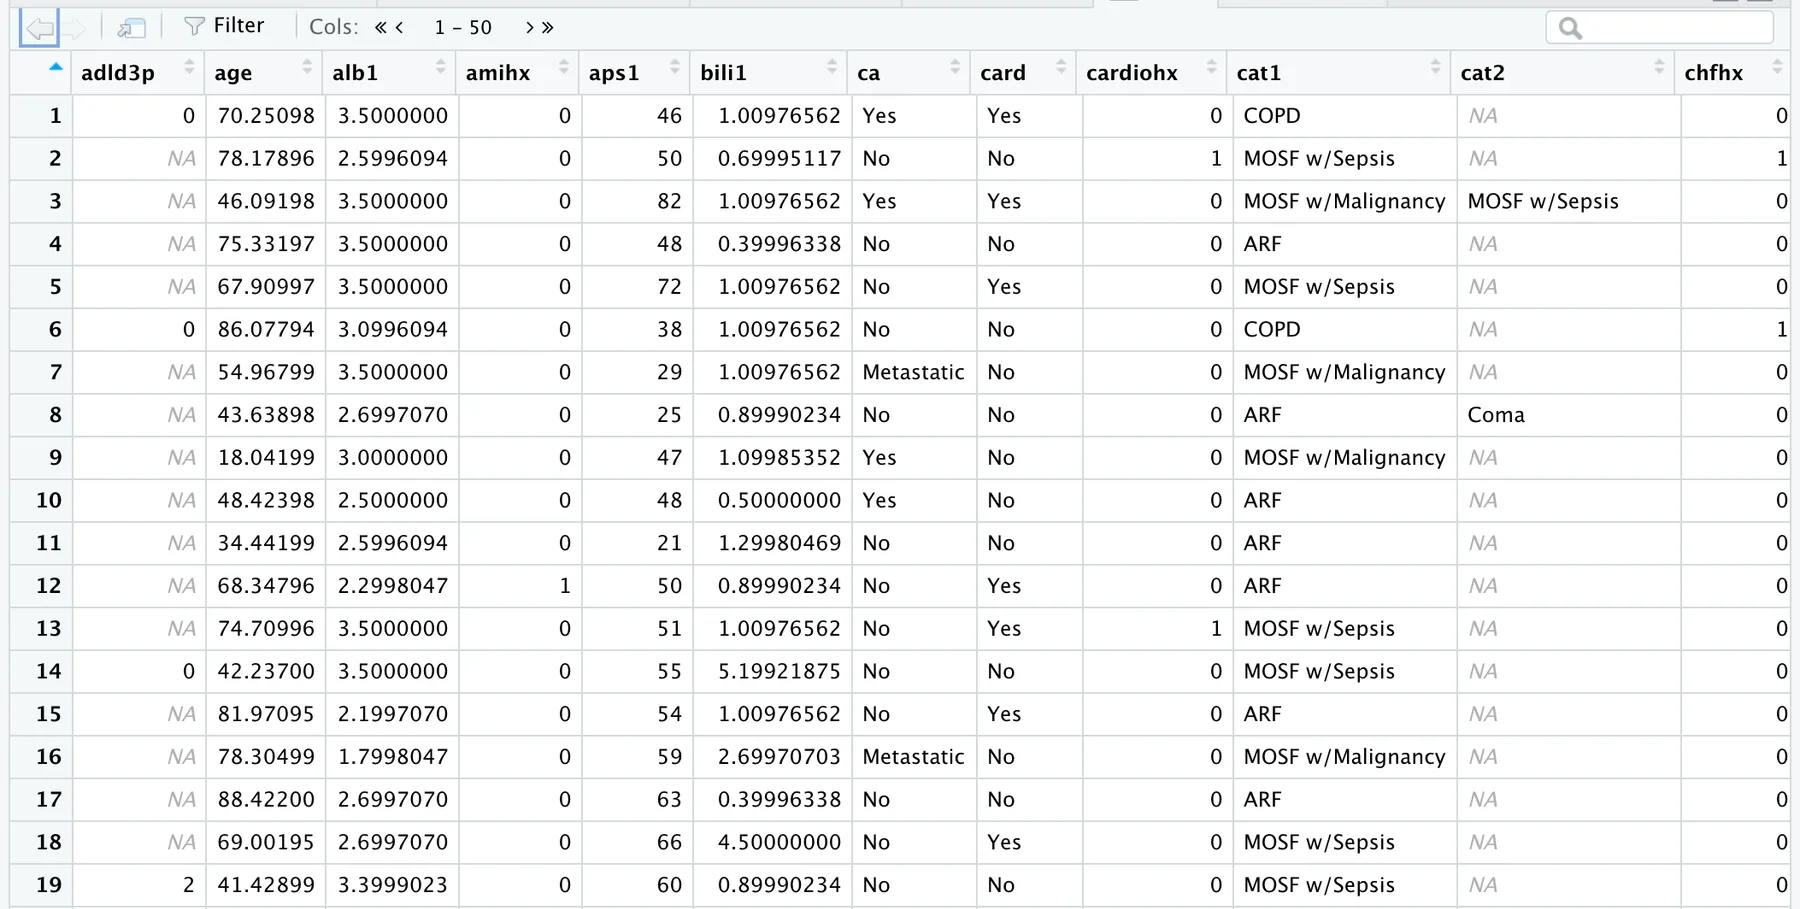
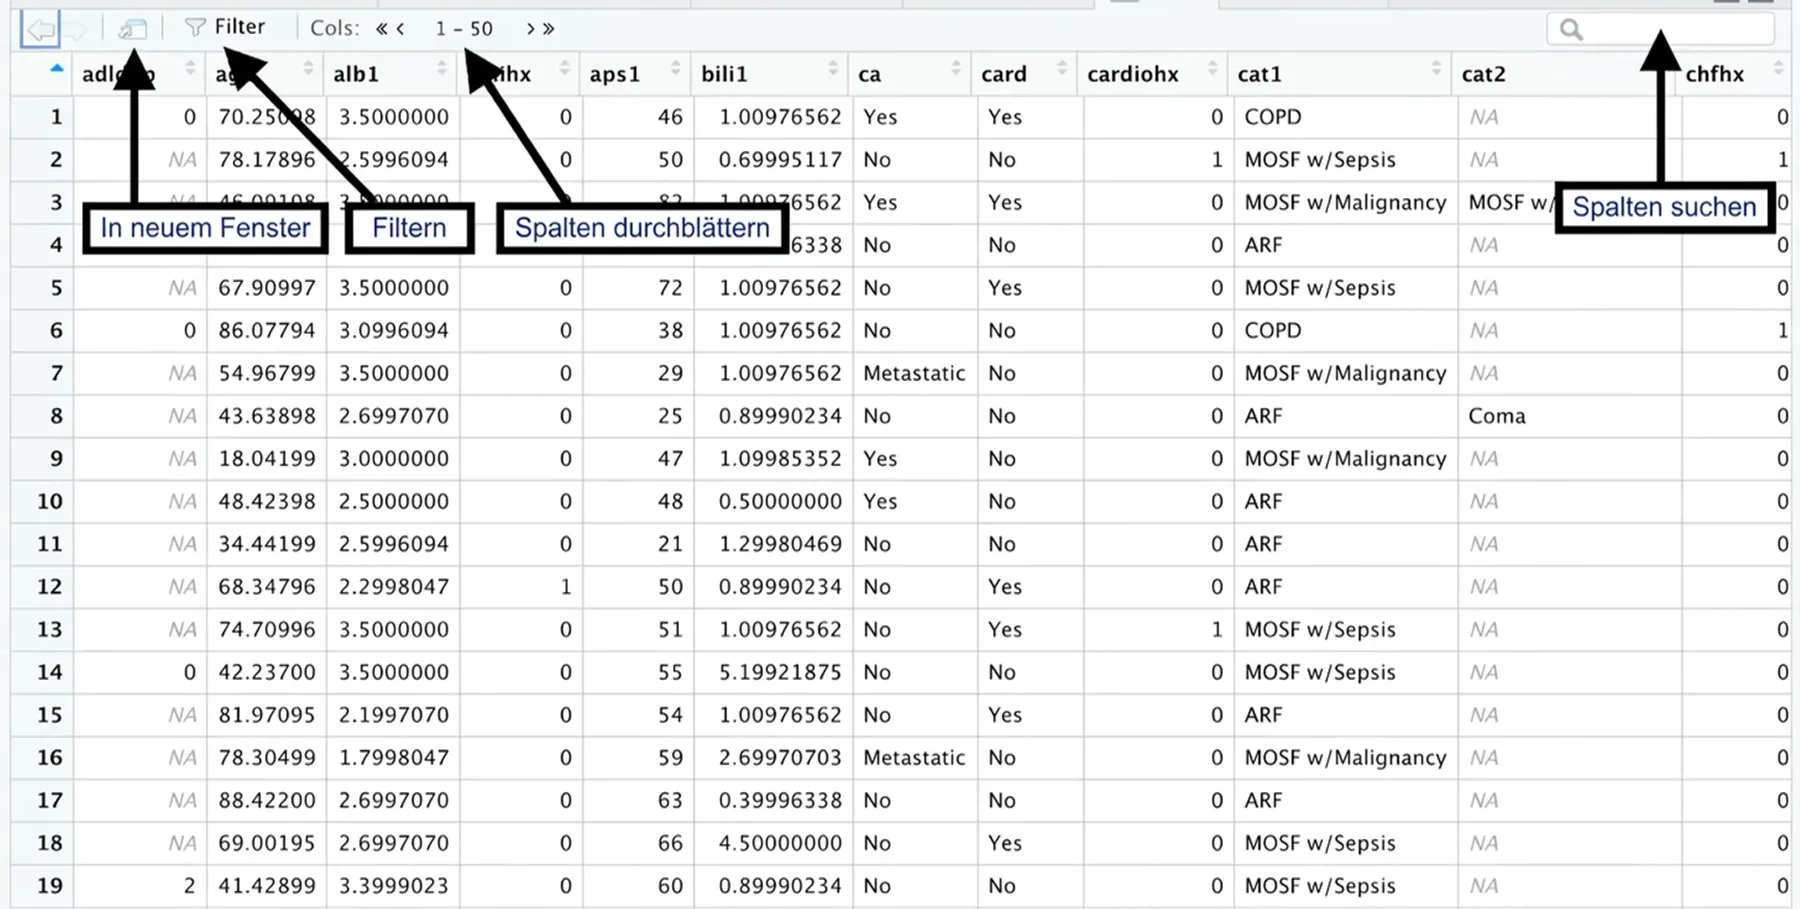
Oben im Fenster finden Sie Funktionen, mit denen Sie den Datensatz filtern, durch die Spalten blättern und den gesamten Datensatz durchsuchen können. Diese Funktionen sind in der folgenden Abbildung dargestellt.
Weiter geht es mit head() und tail(), die die ersten 5 bzw. die letzten 5 Zeilen unseres Data Frames anzeigen. Sie können dies anpassen, indem Sie als zweites Argument dieser Funktionen angeben, wie viele Zeilen Sie sehen möchten.
## Erste 3 Zeilen
head(rhc, 3)

## Letzte 2 Zeilen
tail(rhc, 3)
Ergebnis von head():
| adld3p <int> | age <dbl> | alb1 <dbl> | amihx <int> | aps1 <int> | bili1 <dbl> | ca <chr> | card <chr> | cardiohx <int> |
|---|---|---|---|---|---|---|---|---|
| 0 | 70.25098 | 3.500000 | 0 | 46 | 1.0097656 | Yes | Yes | 0 |
| NA | 78.17896 | 2.599609 | 0 | 50 | 0.6999512 | No | No | 1 |
| NA | 46.09198 | 3.500000 | 0 | 82 | 1.0097656 | Yes | Yes | 0 |
Ergebnis von tail():
| adld3p <int> | age <dbl> | alb1 <dbl> | amihx <int> | aps1 <int> | bili1 <dbl> | ca <chr> | card <chr> | cardiohx <int> |
|---|---|---|---|---|---|---|---|---|
| 1 | 80.48499 | 4.099609 | 0 | 43 | 1.000000 | No | No | 1 |
| NA | 67.37897 | 3.500000 | 0 | 51 | 1.009766 | No | No | 0 |
| NA | 54.66397 | 3.000000 | 0 | 101 | 21.796875 | No | No | 0 |
Das Package dplyr enthält die Funktion glimpse(), die einen Überblick über die Daten gibt. Wir wenden glimpse() jetzt auf rhc an:
glimpse(rhc)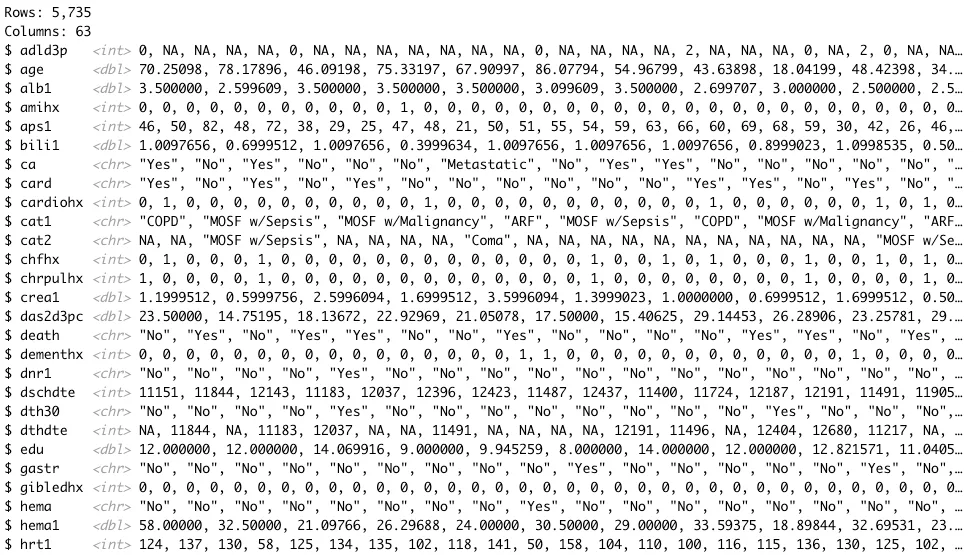
Die Funktion glimpse() verschafft also einen schnellen Überblick darüber, welche Variablen im Data Frame enthalten sind, welche Variablentypen sie haben und welche Werte die ersten Variablen aufweisen.
Mit der Funktion summary() können wir ebenso eine Beschreibung aller Variablen erzeugen. Im Vergleich zu glimpse() liefert summary() für jede Variable Lage- und Streuungsmaße, wie das folgende Beispiel zeigt:
summary(rhc)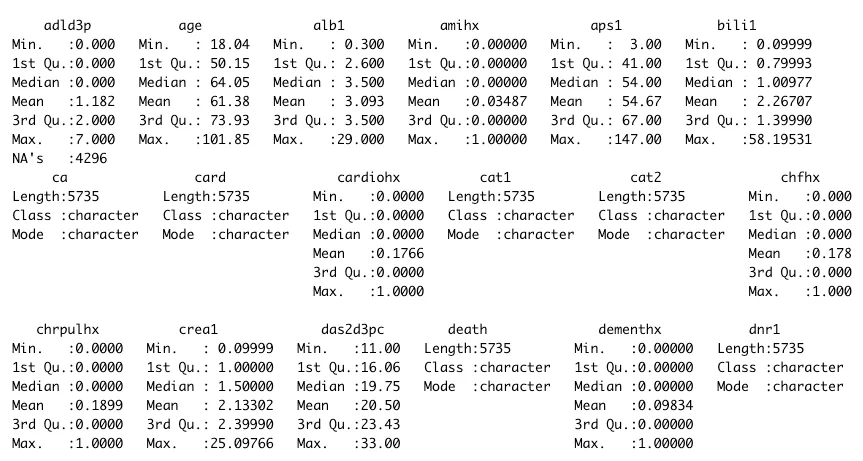
Die Funktion summary() lässt sich auf eine einzelne Spalte anwenden, indem man diese mit $ nach dem Namen unseres Data Frames referenziert:
summary(rhc$age)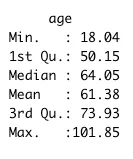
Um die Werte einer einzelnen Spalte anzuzeigen, geht man genauso vor wie oben. Dem Spaltennamen wird $ vorangestellt, und zwar wie folgt:
rhc$age [1] 70.25098 78.17896 46.09198 75.33197 67.90997 86.07794 54.96799 43.63898 18.04199 48.42398 34.44199 68.34796 74.70996 42.23700 81.97095 78.30499
[17] 88.42200 69.00195 41.42899 67.50397 50.59000 62.68900 42.05298 23.11299 62.10797 39.82999 47.75598 36.70099 71.20099 95.53699 67.27997 73.49194
[33] 71.49597 54.79300 36.13397 61.43997 55.97299 51.39999 54.31097 67.74298 59.90399 21.09200 94.07495 41.33899 80.38300 58.04199 32.07397 80.58295
[49] 70.61200 80.18896 56.76898 85.29498 63.91498 78.08600 83.37000 61.86697 85.31995 42.92398 47.97498 58.03400 49.82898 69.19098 25.40999 68.40198
[65] 63.54797 38.91599 77.32495 58.80099 66.32196 60.65399 66.89398 63.48297 25.51399 83.35895 42.28598 57.46997 76.43500 80.03796 49.52798 40.78000
[81] 69.15295 68.70099 45.57397 59.29099 81.24597 72.81897 53.52197 39.73199 93.02399 54.08600 43.99500 64.11200 70.51599 87.13995 79.79199 46.58698
[97] 87.70996 83.56195 86.17096 49.99899 30.56499 65.08099 63.88498 47.82498 41.83698 49.68698 57.09198 55.13797 44.31998 56.30899 75.12897 76.84900
[113] 57.98999 69.40198 65.39600 79.93195 71.90997 77.19397 66.08398 20.58899 60.27100 54.08398 81.93597 36.18100 86.26996 74.68298 28.19399 86.14899
[129] 80.60498 42.01498 34.11600 82.24799 78.70795 53.31400 71.98395 67.73700 80.45697 82.41998 88.17200 76.21399Auswahl der zu inspizierenden Spalten
Die Funktionen in dplyr sind unverzichtbar, um Spalten auszuwählen und zu verändern. Es folgen mehrere Beispiele, die in Kommentaren im Code erläutert werden:
## Inspiziert die ersten 3 Spalten, hema, renalhx und
## alle Spalten zwischen transhx:trauma und trauma
rhc %>%
select(1:3, hema, renalhx, transhx:trauma)| adld3p <int> | age <dbl> | alb1 <dbl> | hema <chr> | renalhx <int> | transhx <int> | trauma <chr> |
|---|---|---|---|---|---|---|
| 0 | 70.25098 | 3.5000000 | No | 0 | 0 | No |
| NA | 78.17896 | 2.5996094 | No | 0 | 1 | No |
| NA | 46.09198 | 3.5000000 | No | 0 | 0 | No |
| NA | 75.33197 | 3.5000000 | No | 0 | 0 | No |
| NA | 67.90997 | 3.5000000 | No | 0 | 0 | No |
| 0 | 86.07794 | 3.0996094 | No | 0 | 0 | No |
| NA | 54.96799 | 3.5000000 | No | 0 | 0 | No |
| NA | 43.63898 | 2.6997070 | No | 0 | 1 | No |
| NA | 18.04199 | 3.0000000 | Yes | 0 | 0 | No |
| NA | 48.42398 | 2.5000000 | No | 0 | 0 | No |
Sie können ganz am Ende ein View() anfügen, um alle Rohdaten zu inspizieren, und zwar wie folgt:
rhc %>%
  select(1:3, hema, renalhx, transhx:trauma) %>%
  View()
Wenn der obige Code ausgeführt wird, öffnet sich ein Fenster mit den Rohdaten.
Mit weiteren Funktionen aus dplyr können Sie einschränken, welche Patienten Sie inspizieren:
rhc %>%
  # Behält nur Patienten, die älter als 50 Jahre sind und card==Yes haben
  filter(age>50, card=="Yes") |>
  # Wählt Variablen aus
  select(1:3, hema, renalhx, transhx:trauma) |>
  # Behält die ersten 100 Zeilen
  slice(1:100) |>
  # Öffnet das Fenster
  View()
Wenn der obige Code ausgeführt wird, öffnet sich ein Fenster mit den Rohdaten.