
Überlebensfunktion (survival function) und Hazardfunktion (hazard function)
Das vorangehende Kapitel (Überlebenszeitanalyse) ist Voraussetzung für das Verständnis dieses Kapitels.
Die Überlebenszeit (survival time) ist eine stetige Variable, die sich mit zwei einfachen Funktionen beschreiben lässt:
- : Die Überlebensfunktion (survival function) ist die Wahrscheinlichkeit, dass eine Person nach dem Zeitpunkt t noch am Leben ist.
- : Die Hazardfunktion (hazard function) beschreibt das momentane Risiko, dass das Ereignis (event) zum Zeitpunkt t eintritt, unter der Voraussetzung, dass die Person bis zum Zeitpunkt t überlebt hat.
Alle stetigen Variablen (einschließlich der survival time) lassen sich mit einer kumulativen Verteilungsfunktion (cumulative distribution function, CDF) beschreiben. Diese Funktionen sind Wahrscheinlichkeitsverteilungen und werden wie folgt definiert:
Die Funktion beschreibt die Wahrscheinlichkeit, dass kleiner oder gleich ist. Auch die Überlebenszeit besitzt eine kumulative Verteilungsfunktion:
Diese Funktion beschreibt die Wahrscheinlichkeit, dass das Ereignis zum Zeitpunkt oder davor eintritt, jedoch nicht später als . Unser Ziel ist jedoch, zu schätzen, also die Wahrscheinlichkeit, dass die Person den Zeitpunkt überlebt hat (d. h. bis zum Zeitpunkt nicht vom Ereignis betroffen war). ist somit die Wahrscheinlichkeit, den Zeitpunkt zu überleben:
hat eine treppenförmige Gestalt, wie die folgende Grafik (Kaplan-Meier-Kurve) zeigt. Die Grafik beschreibt, wie die Überlebenswahrscheinlichkeit im Zeitverlauf abnimmt. Die Pluszeichen (+) in der Grafik kennzeichnen Zeitpunkte, zu denen Personen zensiert wurden. wird durch Zensierungen nicht beeinflusst. nimmt nur dann ab, wenn eine oder mehrere Personen das Ereignis erleiden.
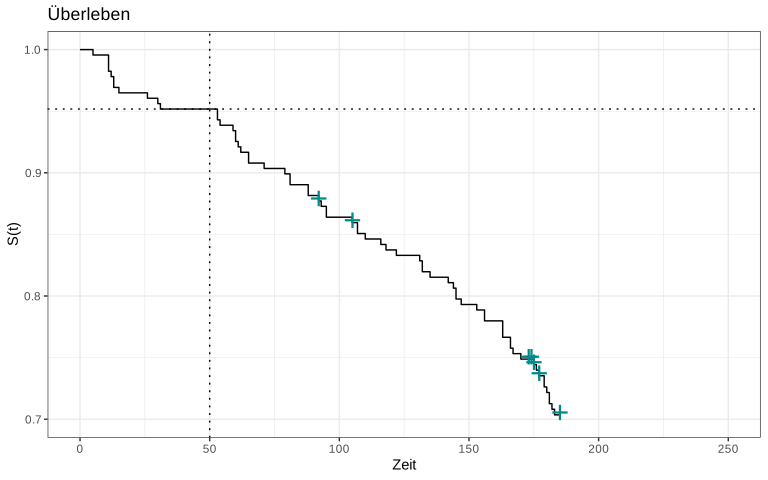
In der obigen Grafik beträgt der Wert von bei 0,952. Das bedeutet, dass die Wahrscheinlichkeit, mindestens 50 Tage zu überleben, 95,2 % beträgt und 4,8 % bei vom Ereignis betroffen sind. Das mediane Überleben ist der Zeitpunkt, zu dem 50 % der Population das Ereignis erlitten haben, d. h. .
Kaplan-Meier-Schätzer (Product-Limit-Schätzer)
Es ist stets wichtig, das Überleben grafisch darzustellen, da die Grafik zeigt, wie sich der Überlebensprozess im Zeitverlauf entwickelt. Die gebräuchlichste Methode zur Darstellung von ist der Kaplan-Meier-Schätzer (Kaplan-Meier-Kurve, Product Limit Estimator), der in der obigen Abbildung veranschaulicht wurde.
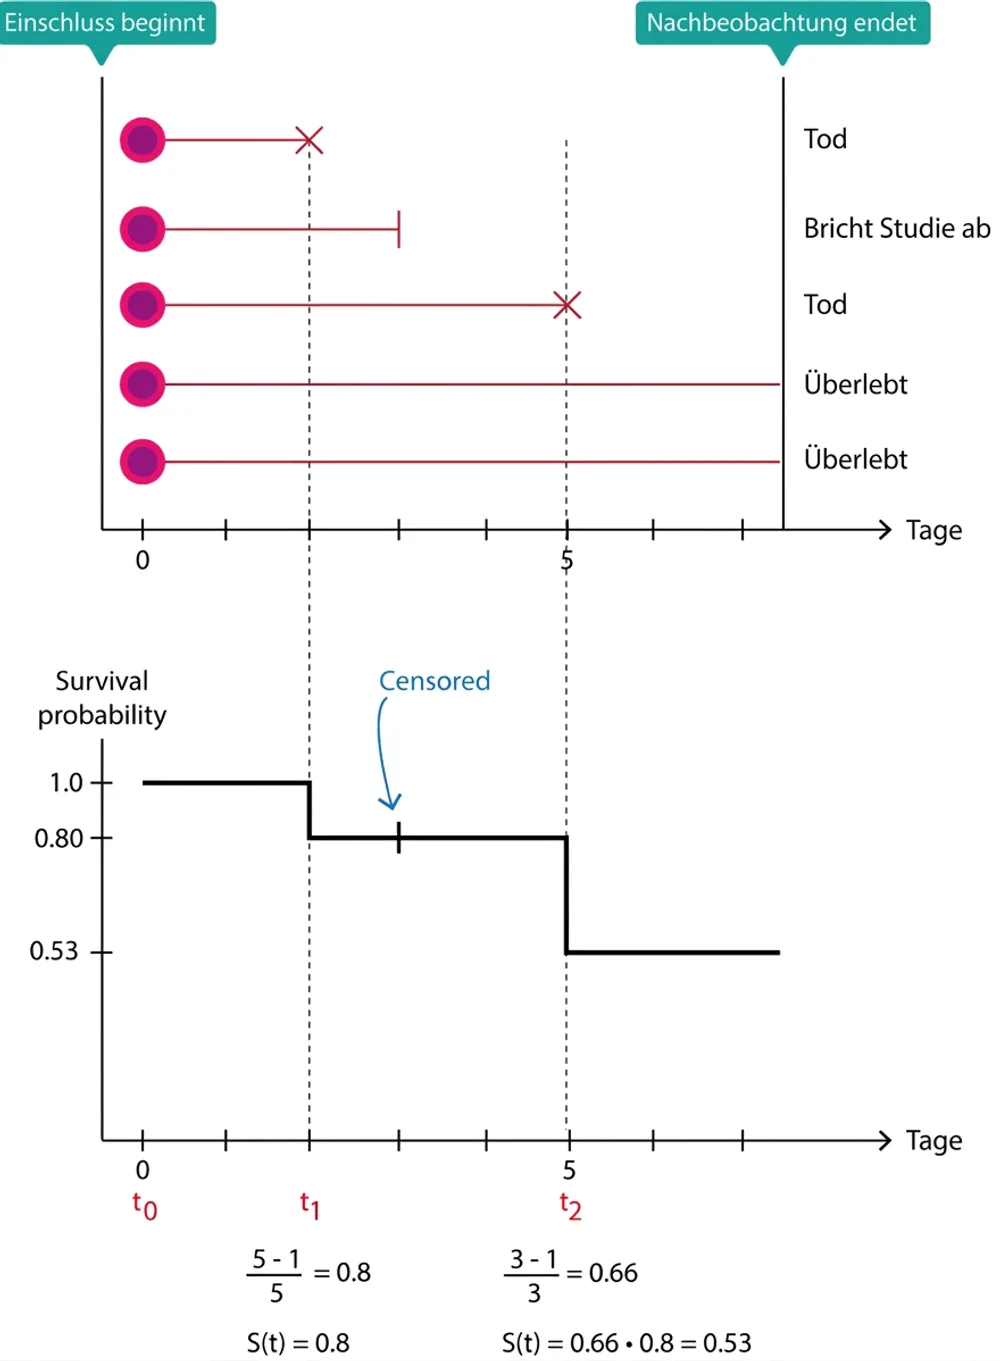
Um eine Kaplan-Meier-Kurve zu erstellen, muss die survival time (die Nachbeobachtungszeit) in Intervalle zerlegt werden. Jedes Intervall beginnt, wenn ein Ereignis eintritt. Alle Zeitpunkte, zu denen Ereignisse eintreten (event times), werden vom ersten bis zum letzten Ereignis der Größe nach geordnet. Bei tritt das erste Ereignis ein, bei das zweite, bei das dritte und so weiter. Die Studie beginnt bei ; zu diesem Zeitpunkt ist noch kein Ereignis eingetreten. Bei gilt , d. h. die Überlebenswahrscheinlichkeit beträgt 100 %.
Zur Berechnung von bei wird folgende Rechnung durchgeführt:
= Anzahl der zu Beginn von beobachteten Patienten
= Anzahl der Ereignisse bei
Dies ist der Anteil der Patienten, die nach überleben, unter den Patienten, die bis überlebt haben. Um die Wahrscheinlichkeit zu berechnen, nach zu überleben, vorausgesetzt, man hat bis dahin überlebt, erfolgt die Berechnung in zwei Schritten:
ist das Produkt der Wahrscheinlichkeiten, bis zu überleben, also:
Dies ist in der folgenden Abbildung veranschaulicht.
| Zeitpunkt (x) | Anzahl unter Risiko | Anzahl Ereignisse | Anzahl zensiert | Überleben (y) |
|---|---|---|---|---|
| 0 | 228 | 0 | 0 | 1.00000000 |
| 5 | 228 | 1 | 0 | 0.99561404 |
| 11 | 227 | 3 | 0 | 0.98245614 |
| 12 | 224 | 1 | 0 | 0.97807018 |
| 13 | 223 | 2 | 0 | 0.96929825 |
| 15 | 221 | 1 | 0 | 0.96491228 |
| 26 | 220 | 1 | 0 | 0.96052632 |
| 30 | 219 | 1 | 0 | 0.95614035 |
| 31 | 218 | 1 | 0 | 0.95175439 |
| 53 | 217 | 2 | 0 | 0.94298246 |
| 54 | 215 | 1 | 0 | 0.93859649 |
| 59 | 214 | 1 | 0 | 0.93421053 |
| 60 | 213 | 2 | 0 | 0.92543860 |
| 61 | 211 | 1 | 0 | 0.92105263 |
| 62 | 210 | 1 | 0 | 0.91666667 |
| 65 | 209 | 2 | 0 | 0.90789474 |
| 71 | 207 | 1 | 0 | 0.90350877 |
Die Überlebenswahrscheinlichkeit (survival probability) ist auf der Kaplan-Meier-Kurve. Sie ist somit der Anteil, der zu jedem Zeitpunkt noch am Leben ist. Die Kurve fällt schrittweise ab, je mehr Personen das Ereignis erleiden. Die Kaplan-Meier-Kurve erreicht nur dann, wenn alle Teilnehmenden das Ereignis erleiden. Das mediane Überleben ist schlicht der Anteil, der bei lebt.
Hypothesentest und Überlebenszeitanalyse: der Log-Rank-Test
Unterschiede zwischen Überlebenskurven testen
In der folgenden Abbildung wird das Überleben von Männern und Frauen verglichen.
21.7.1 R-Code für die obige Kaplan-Meier-Kurve
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)

## Beispieldaten laden
data(colon)

## Die ersten 10 Zeilen ansehen
head(colon, 10)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1Die Überlebensfunktion wird mit den Funktionen survfit() und Surv() erzeugt. In Surv() ist das erste Argument die Überlebenszeit (time) und das zweite Argument die Ereignisvariable. Für die Ereignisvariable können wir angeben, welche Ausprägung anzeigt, dass das Ereignis eingetreten ist. Dies geschieht unten durch die Angabe status==1. Mit dem Argument pval = TRUE fordern wir einen Hypothesentest mit dem Log-Rank-Test an. Dieser Test berechnet die Wahrscheinlichkeit, dass die Nullhypothese ( zutrifft (die Nullhypothese postuliert, dass kein Unterschied im Überleben besteht. Ist der mit dem Log-Rank-Test ermittelte p-Wert < 0,05, wird verworfen. In diesem Fall werden Männer mit Frauen verglichen, indem die Variable sex als Stratum aufgenommen wird:
## survfit-Objekt erstellen. In diesem Objekt wird die Überlebensfunktion erzeugt
fit <- survfit(Surv(time, status==1) ~ sex, data = lung)

## Kaplan-Meier-Kurve zeichnen
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)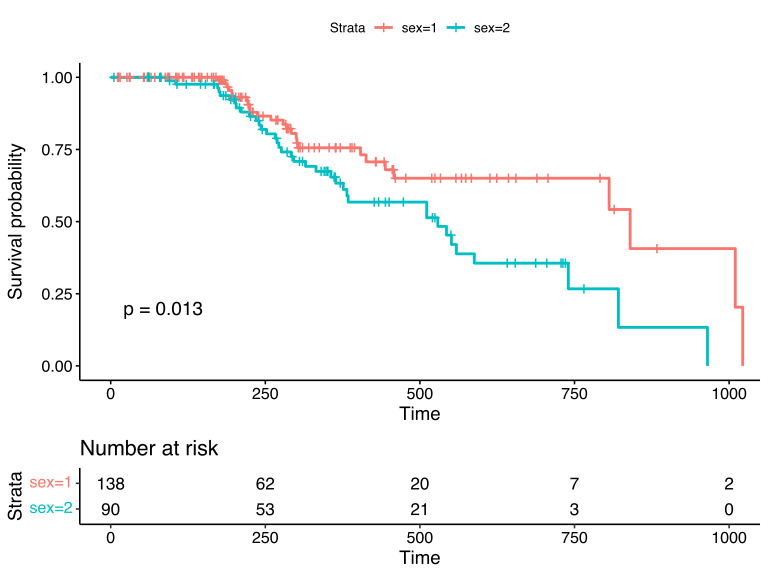
Wie oben ersichtlich, verlaufen die Kurven getrennt, d. h. das Überleben unterscheidet sich zwischen Männern (sex=2) und Frauen (sex=1). Zu jedem Zeitpunkt ist bei Frauen höher. Das Überleben ist also bei Frauen besser, und dies lässt sich visuell beurteilen. Der p-Wert beträgt 0,013, was ebenfalls darauf hinweist, dass der Unterschied statistisch signifikant ist. Der p-Wert wurde mit dem Log-Rank-Test berechnet.
Der Log-Rank-Test folgt dem Prinzip des Hypothesentests. Man geht von der Nullhypothese () aus, die postuliert, dass zwischen den Gruppen kein Unterschied besteht, und berechnet anschließend eine Wahrscheinlichkeit (p-Wert) dafür, dass die Nullhypothese zutrifft. Liegt die Wahrscheinlichkeit unter 0,05, wird die Nullhypothese verworfen. Mit dem Log-Rank-Test lassen sich zwei oder mehr Überlebenskurven vergleichen.
Die Kaplan-Meier-Kurve kann somit zur Untersuchung des Überlebens verwendet werden. Dies ist in der gesamten Population oder in Subgruppen (z. B. Männer und Frauen) möglich. In einer Kaplan-Meier-Berechnung kann man jedoch nicht für Kovariaten adjustieren; dazu ist eine Regressionsanalyse erforderlich, deren gebräuchlichste Methode die Cox-Regression ist, die im nächsten Kapitel behandelt wird.