
Überlebenszeitanalyse (Survival Analysis): Von Kaplan-Meier zur Cox-Regression
Eine überarbeitete Fassung dieses Kapitels finden Sie hier:
Die Überlebenszeitanalyse ist ein leistungsfähiges Werkzeug zur Untersuchung von Ereignissen (Events). Zentral für die Überlebenszeitanalyse ist die Information über die Beobachtungszeit. Man untersucht nämlich stets die Zeit bis zum Eintreten eines Ereignisses. In der englischsprachigen Literatur werden die Bezeichnungen Survival Analysis oder Time-to-Event Analysis verwendet. Der letztgenannte Begriff, Time-to-Event-Analyse, ist eigentlich zutreffender, da sich mit diesen Analysen beliebige Ereignisse untersuchen lassen und nicht nur der Tod. In diesem Kapitel verwenden wir dennoch den Tod als Beispiel, weil dies das Verständnis erleichtert.
Zentral für die Überlebenszeitanalyse ist die Kenntnis der Beobachtungszeit, also des Zeitraums, in dem das Individuum beobachtet wird. Es muss sich dabei selbstverständlich nicht um eine Person handeln; ebenso gut können Zellen, Bakterien oder Ähnliches beobachtet werden. In ihrer reinsten Form beginnt die Beobachtungszeit mit dem Einschluss des Individuums in die Studie und endet, wenn das Ereignis eintritt oder der Nachbeobachtungszeitraum der Studie abgelaufen ist. Der Zeitraum, in dem das Individuum beobachtet wird, heißt Survival Time.
Die Ziele der Überlebenszeitanalyse sind folgende:
- Den Überlebensprozess untersuchen.
- Untersuchen, wie verschiedene Prädiktoren das Überleben beeinflussen.
Zur Untersuchung des Überlebensprozesses kann man deskriptive Methoden einsetzen, von denen der Kaplan-Meier-Schätzer (die Kaplan-Meier-Kurve) die wichtigste ist. Die Kaplan-Meier-Methode liefert eine grafische (und mathematische) Beschreibung des Überlebens. Mit ihr lässt sich auch das Überleben zwischen zwei oder mehr Gruppen vergleichen. Eingehende Analysen des Einflusses verschiedener Prädiktoren auf das Überleben sind mit dem Kaplan-Meier-Schätzer jedoch nicht möglich.
Um zu untersuchen, wie verschiedene Prädiktoren das Überleben beeinflussen, ist eine Regressionsanalyse erforderlich. Heute wird die Überlebenszeitanalyse von der Cox-Regression (Cox Proportional Hazards Model) dominiert, mit der sich das Überleben zwischen zwei oder mehr Gruppen vergleichen und der Einfluss verschiedener Prädiktoren auf das Überleben untersuchen lässt. Die Cox-Regression ist ein außerordentlich leistungsfähiges Werkzeug, und täglich erscheinen Tausende von Publikationen, in denen die Cox-Regression den Eckpfeiler der Studie bildet.
Der Kaplan-Meier-Schätzer und die Cox-Regression sind die wichtigsten Werkzeuge, die man beherrschen sollte; deshalb konzentriert sich die weitere Darstellung auf diese beiden.
Überlebenszeitanalyse vs. logistische Regression
Mit der Überlebenszeitanalyse werden also dichotome (binäre) Ereignisse (Events) untersucht. Man untersucht, ob ein Ereignis eintritt oder ausbleibt. In dieser Hinsicht ähnelt die Überlebenszeitanalyse der logistischen Regression (siehe Logistische Regression). Tatsächlich wird auch die logistische Regression zur Untersuchung dichotomer Ereignisse verwendet. Täglich erscheinen Hunderte von Publikationen, in denen mit logistischer Regression Zusammenhänge zwischen diversen Prädiktoren und Tod oder anderen Events untersucht werden. Die logistische Regression ist jedoch (im Prinzip) immer die schlechtere Wahl gegenüber der Überlebenszeitanalyse, wenn es um das Überleben geht, und zwar weil die logistische Regression die Beobachtungszeit nicht berücksichtigen kann. Die Beobachtungszeit selbst ist der Schlüssel zur Überlebenszeitanalyse (tatsächlich ist es die Verteilung der Survival Time, die in der Überlebenszeitanalyse untersucht wird), und sie lässt sich nicht in eine logistische Regression einbeziehen. Veranschaulichen wir das mit einem (extremen) Beispiel:
Sie untersuchen die Wirkung eines Arzneimittels, das im Jahr 2013 an 50 von 100 Patienten mit Lungenkrebs verabreicht wurde. Diese Patienten wurden 2014 nachuntersucht, und zu diesem Zeitpunkt waren sämtliche Patienten verstorben. Unter denjenigen, die das Arzneimittel erhielten, und denjenigen, die es nicht erhielten, starben also gleich viele. Sie führen eine logistische Regression durch, in der das Überleben (als dichotomer Endpunkt) im Jahr 2014 betrachtet wird. Da alle Patienten verstorben sind, wird die logistische Regression anzeigen, dass das Arzneimittel wirkungslos ist, weil die Zahl der Verstorbenen 2014 in beiden Gruppen gleich war. Nehmen wir an, das mediane Überleben in der Gruppe ohne Arzneimittel betrug 1 Monat und in der Gruppe mit Arzneimittel 6 Monate. Zwar waren nach 12 Monaten alle verstorben, dennoch scheint das Arzneimittel das Leben verlängert zu haben. Mit einer korrekten Überlebenszeitanalyse könnten wir bestätigen, dass das Arzneimittel wirksam ist, und zwar weil die Überlebenszeitanalyse die Überlebenszeit selbst (Survival Time) einbeziehen kann!
Mit der Überlebenszeitanalyse (und insbesondere der Cox-Regression) hat man also eine größere Chance, Unterschiede im Überleben zu finden. Liegen Angaben zur Survival Time vor, sollte man die Überlebenszeitanalyse (insbesondere die Cox-Regression) stets der logistischen Regression vorziehen. (Es sei jedoch erwähnt, dass die logistische Regression unter besonderen Umständen der Cox-Regression äquivalent sein kann; dies wird in diesem Kapitel aber nicht behandelt.)
Event (Outcome, Endpunkt, Ereignis) in der Überlebenszeitanalyse
Der Endpunkt einer Überlebenszeitanalyse ist ein Ereignis (englisch: Event). Das Ereignis kann der Tod sein, ein Schlaganfall, eine Krebsdiagnose oder auch ein „weicheres“ Event wie der Beginn einer Arzneimitteltherapie oder die Entlassung aus dem Krankenhaus. Mit der Überlebenszeitanalyse lassen sich also Ereignisse jeder Art untersuchen. Dazu gehört sogar die Lebensdauer eines Computers. Die Art des Ereignisses selbst ist somit von untergeordneter Bedeutung, doch es liegt in der Verantwortung der Untersuchenden, ein klares und sinnvolles Ereignis zu definieren. Alle Personen der Population sollen vom Zeitpunkt ihres Einschlusses in die Studie bis zum Ende der Nachbeobachtung verfolgt werden. Wichtig ist, den Zeitpunkt des Ereignisses (so genau wie möglich) datieren zu können, damit die Beobachtungszeit mit hoher Auflösung berechnet werden kann. Es ist also deutlich besser, die Survival Time in Tagen statt in Monaten zu erfassen. Je gröber das Maß der Survival Time, desto geringer die Präzision der Analyse.
Prädiktoren, Kovariaten und unabhängige Variablen
Wenn mit der Überlebenszeitanalyse untersucht wird, wie verschiedene Variablen den Endpunkt beeinflussen, geschieht dies in der Regel mit der Cox-Regression (Cox Proportional Hazards Model). Die untersuchten Variablen heißen Prädiktoren, Kovariaten oder unabhängige Variablen. Alle drei Bezeichnungen sind gebräuchlich und meinen dasselbe.
Censoring (Zensierung)
Die Überlebenszeit (Survival Time) ist eine stetige Variable, und daher könnte es verlockend sein, das Überleben mit linearer Regression zu untersuchen. Die lineare Regression ist hier jedoch nicht anwendbar, und zwar wegen der Zensierung (engl.: Censoring). In der Regel erleben nicht alle Personen das untersuchte Ereignis; so ist es beispielsweise selten, dass alle Studienteilnehmer versterben. Personen, die die gesamte Beobachtungszeit überleben, stellen also ein Problem dar, weil wir nicht sagen können, ob oder wann sie sterben werden. Diese Personen werden zensiert (engl.: censored), wenn die Nachbeobachtung der Studie endet. Dasselbe Problem entsteht, wenn Studienteilnehmer aus der Studie ausscheiden (z. B. wegen Nebenwirkungen eines Arzneimittels oder weil sie ins Ausland ziehen etc.). Auch diese Personen werden zensiert (da wir nicht sagen können, ob oder wann sie sterben werden). Censoring bedeutet also, dass die Nachbeobachtung endet, bevor das Ereignis eingetreten ist. Man unterscheidet drei Arten von Censoring:
- Schließt eine Person die Studie ab, ohne dass das Ereignis eintritt, wird sie right censored (rechtszensiert). Das bedeutet, dass wir nur über das Schicksal des Patienten bis zu dem Zeitpunkt etwas aussagen können, an dem die Nachbeobachtung endet. Personen, die aus der Studie ausscheiden (gleich aus welchem Grund), werden ebenfalls right censored.
- Häufig interessiert uns eine bestimmte Exposition; eine Studie kann zum Beispiel untersuchen, wie Diabetes das Überleben beeinflusst. Oft ist jedoch unbekannt, wann die Diabeteserkrankung entstanden ist. Die Erkrankung kann viele Jahre vor der Diagnosestellung bestanden haben. Ist unbekannt, wann eine Exposition begann, ist das Individuum in dieser Hinsicht left censored (linkszensiert). Left Censoring bedeutet also, dass unklar ist, wann das Risiko des Individuums begann. Dies ist in der Regel jedoch kein größeres Problem.
- Ist ein Individuum sowohl left als auch right censored, ist es interval censored (intervallzensiert).
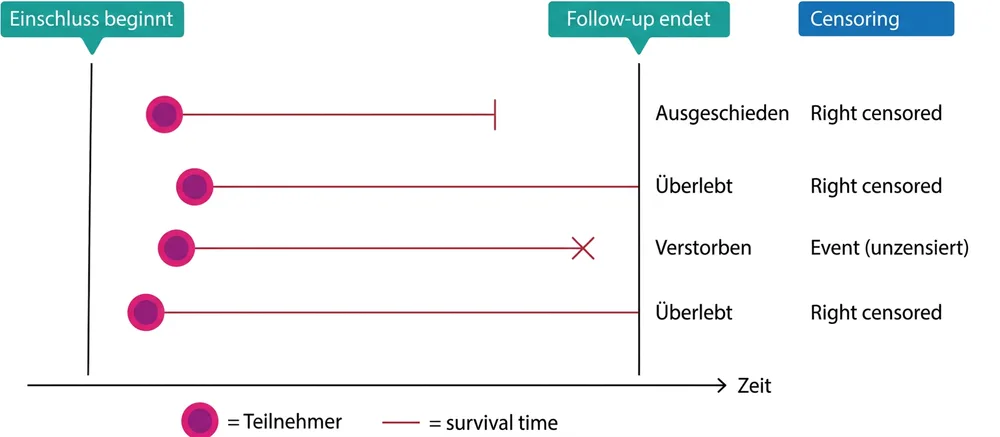
Informatives vs. nicht informatives Censoring
Das Censoring muss unabhängig sein von (1) den Kovariaten (Prädiktoren) des Individuums und (2) davon, wie lange das Individuum in der Studie bereits überlebt hat. Censoring während des Studienverlaufs (vor Abschluss der Nachbeobachtung) muss zufällig erfolgen, andernfalls liegt ein Bias in der Studie vor. Dazu ein Beispiel. Angenommen, wir untersuchen die Wirkung eines Blutdruckmedikaments auf die Mortalität. Das untersuchte Arzneimittel erweist sich als mit schweren Nebenwirkungen behaftet, sodass viele Personen, die es erhalten, die Studie abbrechen müssen. In diesem Fall wird das Censoring von einer Kovariate (einem Prädiktor) bestimmt, nämlich dem Arzneimittel, und dadurch entsteht ein Bias, weil die Patienten aus der Studie ausscheiden, bevor sie versterben können. Dies führt zu einer Unterschätzung der Zahl der Todesfälle und damit zu einer Überschätzung des Überlebens. Diese Art des Censoring heißt informatives Censoring, was bedeutet, dass das Censoring nicht zufällig war.
Das Censoring soll also nicht informativ sein, das heißt, es darf keinen Grund für das Censoring geben. Im Beispiel mit dem Blutdruckmedikament ist die Verteilung der Survival Time zwischen den Gruppen gleich, wenn das Censoring nicht informativ ist.
Survival Function und Hazard Function
Das Überleben (Survival Time) ist eine stetige Variable, die sich mit zwei einfachen Funktionen beschreiben lässt:
S(t) – Survival Function (Überlebensfunktion): S(t) ist die Wahrscheinlichkeit, dass eine Person nach dem Zeitpunkt t noch am Leben ist.
h(t) – Hazard Function (Hazardfunktion): h(t) gibt das momentane Risiko an, dass das Ereignis zum Zeitpunkt t eintritt, vorausgesetzt, die Person hat bis dahin überlebt.
Die Formel und der Zusammenhang zwischen S(t) und h(t) lauten wie folgt:
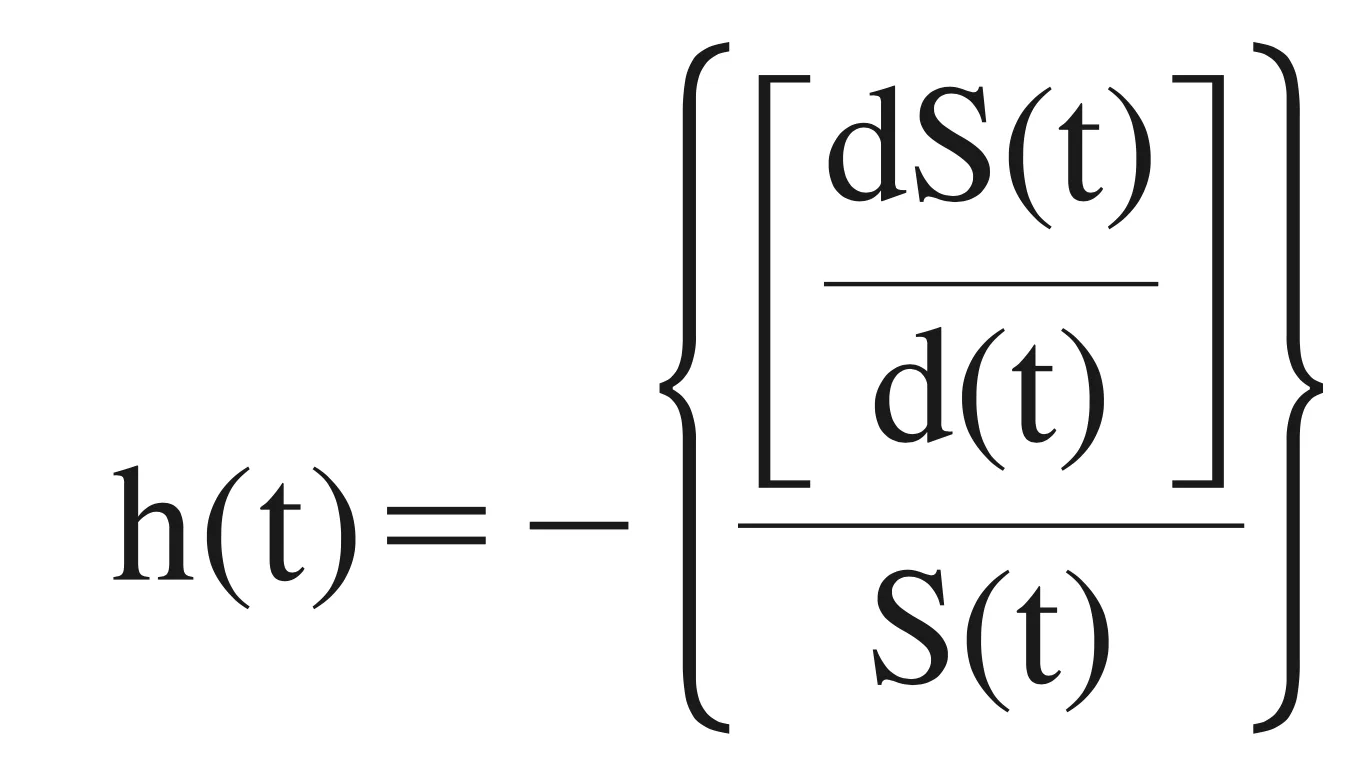
S(t) dient zur Erstellung deskriptiver Statistiken. Durch die Berechnung von S(t) lassen sich unter anderem Überlebenskurven und das mediane Überleben bestimmen. Das mediane Überleben ist der Zeitpunkt, zu dem 50 % der ursprünglichen Kohorte noch leben, d. h. S(t) = 0,5. Beachten Sie, dass in den meisten Untersuchungen mit Überlebenszeitanalyse sowohl Überlebenskurven als auch das mediane Überleben berichtet werden. Die Hazardfunktion wird dagegen in wissenschaftlichen Studien üblicherweise nicht dargestellt. Sie ist dennoch von grundlegender Bedeutung für die Überlebenszeitanalyse, wie später erläutert wird.
S(t) und der Kaplan-Meier-Schätzer (die Kaplan-Meier-Kurve)
In aller Regel ist es sinnvoll, das Überleben grafisch darzustellen, denn so wird sichtbar, wie der Überlebensprozess über die Zeit verläuft. Ob die Teilnehmer überwiegend zu Beginn, in der Mitte oder am Ende einer Studie versterben, lässt sich mit einer Grafik leicht erkennen. Die gebräuchlichste Methode zur Darstellung von S(t) ist der Kaplan-Meier-Schätzer.
Um eine Kaplan-Meier-Kurve zu erstellen, muss die Zeitskala (die Nachbeobachtungszeit) in Intervalle zerlegt werden (Abbildung 2). Jedes Intervall beginnt, wenn ein Event eintritt. Alle Zeitpunkte, zu denen Ereignisse eintreten (Event Times), werden vom ersten bis zum letzten Event der Reihe nach geordnet. Bei t1 tritt das erste Ereignis ein, bei t2 das zweite, bei t3 das dritte und so weiter. Die Studie beginnt bei t0, zu diesem Zeitpunkt ist noch kein Ereignis eingetreten. Bei t0 ist S(t) = 1,0, das heißt, die Überlebenswahrscheinlichkeit beträgt 100 %. Zur Berechnung von S(t) bei t1 wird folgende Rechnung durchgeführt:
(n1 – m1) / n1
n1 ist die Zahl der zu Beginn von t1 beobachteten Patienten.
m1 ist die Zahl der Events bei t1.
Dies ist also der Anteil der Patienten, die nach t1 überleben, unter den Patienten, die bis t1 überlebt haben.
Um die Wahrscheinlichkeit zu berechnen, nach t2 zu überleben, vorausgesetzt, man hat bis dahin überlebt, erfolgt die Berechnung in zwei Schritten:
(n2 – m2) / n2
n2 ist die Zahl der zu Beginn von t2 beobachteten Patienten.
m2 ist die Zahl der Events bei t2.
Dies ist also der Anteil der Patienten, die nach t2 überleben, unter denjenigen, die bis t2 überlebt haben. S(t) ist das Produkt der Wahrscheinlichkeiten, bis t2 zu überleben, also:
(n1 –m1)/n1 × (n2 – m2)/n2
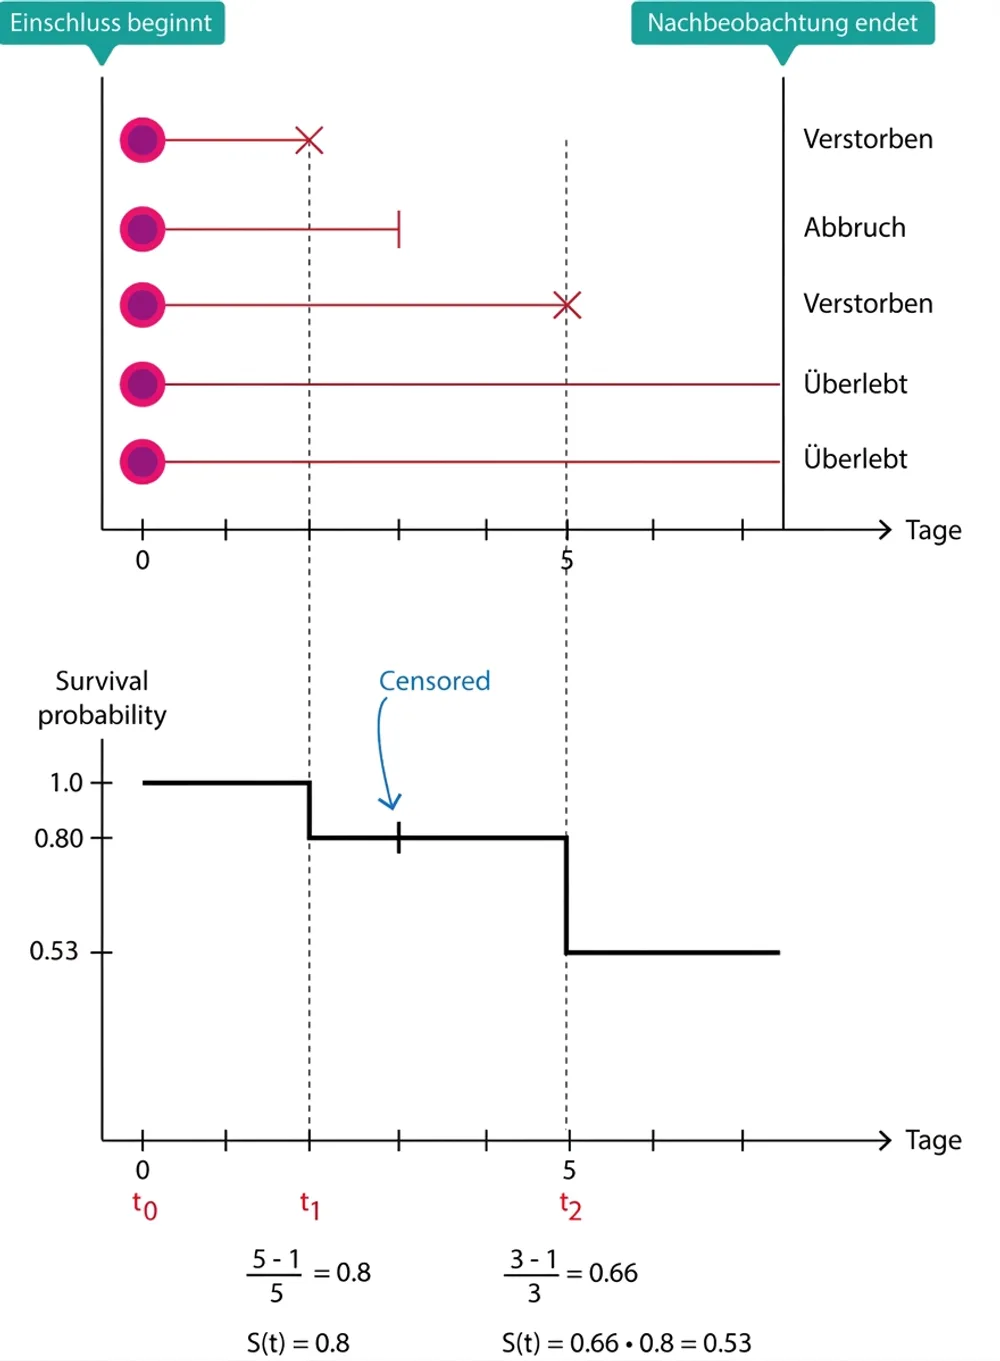
Die Überlebenskurve (Kaplan-Meier-Kurve) zeigt die Survival Probability auf der Y-Achse und die Zeit auf der X-Achse. Die Survival Probability ist S(t), also der Anteil, der zum jeweiligen Zeitpunkt noch lebt. Die Kurve beginnt immer bei Y = 1, da alle bis t1 (dem Zeitpunkt des ersten Events) überleben. Danach fällt die Kurve schrittweise ab, je mehr Personen versterben. Etwaige „+“ auf der Kurve markieren Zeitpunkte, zu denen Personen zensiert werden (d. h. die Nachbeobachtung endet, bevor ein Event eintritt). Wie Sie in der obigen Abbildung sehen, wird S(t) durch die Zensierung nicht beeinflusst. Die Kaplan-Meier-Kurve erreicht nur dann S(t) = 0, wenn alle Studienteilnehmer versterben. Das mediane Überleben ist schlicht der Anteil, der bei S(t) = 0,5 lebt.
Unterschiede zwischen Überlebenskurven testen: der Log-Rank-Test
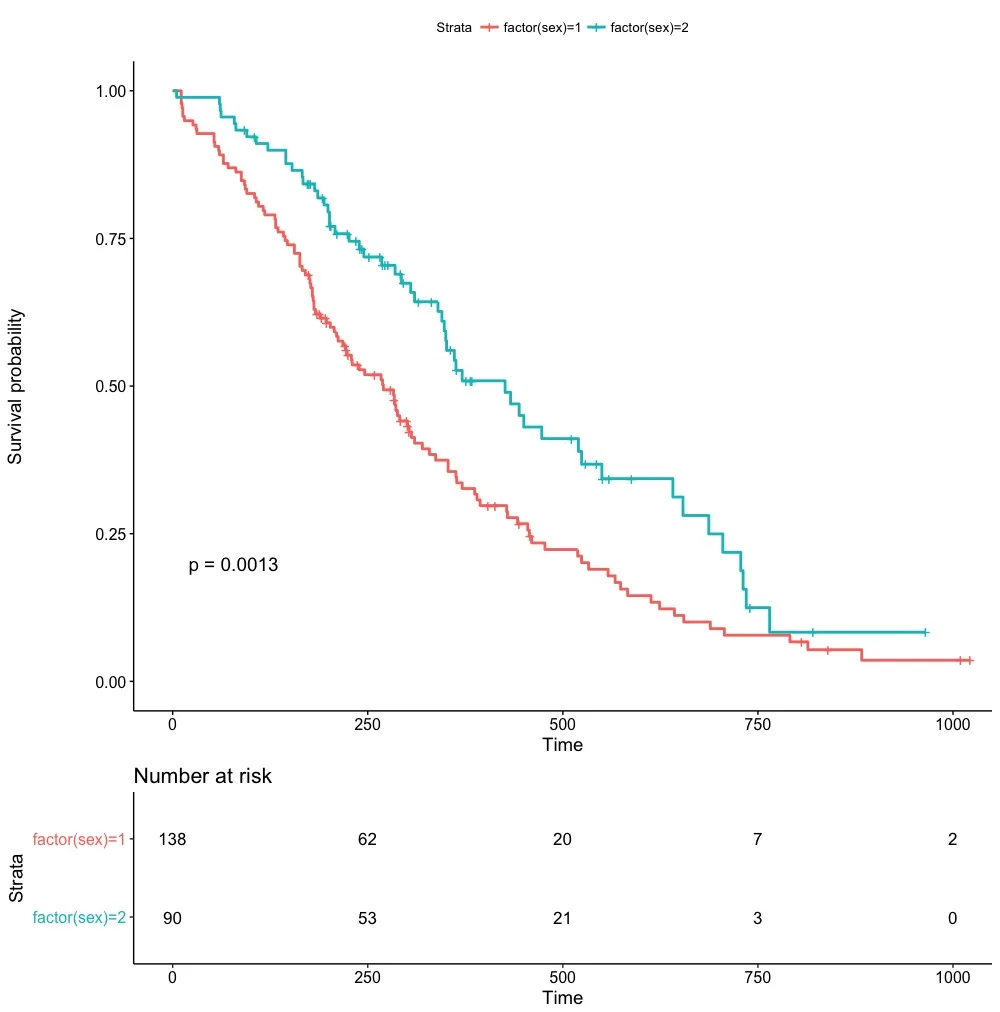
In der folgenden Abbildung wird das Überleben von Männern und Frauen verglichen.
R-Code für die obige Kaplan-Meier-Kurve
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)
## Beispieldaten laden und die Datenstruktur ansehen
data(lung)
str(lung)
## stellt sicher, dass sex eine kategoriale Variable ist, indem sie mit der Funktion "as.factor" dazu gezwungen wird
lung$sex <- as.factor(lung$sex)
## survfit-Objekt erstellen. In diesem Objekt wird die Überlebensfunktion erzeugt
fit <- survfit(Surv(time, status==2) ~ sex, data = lung)
## Kaplan-Meier-Kurve zeichnen
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)
Wie oben zu sehen ist, sind die Kurven voneinander getrennt, was bedeutet, dass sich das Überleben von Männern und Frauen unterscheidet. Zu jedem Zeitpunkt ist S(t) bei Frauen höher (die Linie der Frauen liegt über der Linie der Männer). Das bedeutet, dass Frauen ein besseres Überleben haben, und dies lässt sich visuell beurteilen. Wünschenswert ist es jedoch, mit einem statistischen Test zu prüfen, ob sich das Überleben unterscheidet. Hierfür verwendet man den Log-Rank-Test.
Der Log-Rank-Test folgt dem Prinzip des Hypothesentests. Man geht von der Nullhypothese aus, dass zwischen den Gruppen kein Unterschied besteht, und berechnet anschließend eine Wahrscheinlichkeit (p-Wert) dafür, dass die Nullhypothese zutrifft. Ist die Wahrscheinlichkeit <0,05, wird die Nullhypothese verworfen. Die Gruppen können auf einer beliebigen kategorialen Variablen mit zwei oder mehr Kategorien beruhen. Im obigen Beispiel gibt es nur zwei Gruppen, nämlich Männer und Frauen. Mit dem Log-Rank-Test lassen sich also zwei oder mehr Überlebenskurven vergleichen.
Die Kaplan-Meier-Kurve kann somit zur Untersuchung des Überlebens verwendet werden. Dies kann in der Gesamtpopulation oder in Subgruppen (z. B. Männer und Frauen) geschehen. In einer Kaplan-Meier-Berechnung kann man jedoch nicht für Kovariaten adjustieren; dazu ist eine Regressionsanalyse nötig.
Cox-Regression (Proportional Hazards Model)
Heute ist die Cox-Regression nahezu gleichbedeutend mit Überlebenszeitanalyse. Dies liegt an den zahlreichen Vorteilen der Methode gegenüber anderen Regressionsmodellen. Alternativen zur Cox-Regression, etwa die Weibull-Regression, liefern unter bestimmten Umständen genauere Parameterschätzer, allerdings um den Preis höherer Komplexität. Die Cox-Regression ist ein einfaches und leistungsfähiges Modell zur Untersuchung des Überlebens. Der Unterschied zwischen Cox-Regression und Kaplan-Meier-Analyse besteht darin, dass Erstere eben ein Regressionsmodell ist, sodass wir untersuchen können, wie verschiedene Prädiktoren das Überleben beeinflussen. Cox-Regressionen können, wie die gewöhnliche multiple Regression, einen oder mehrere Prädiktoren enthalten. Die Cox-Regression ist tatsächlich eine Variante des linearen Modells, wie im Folgenden erläutert wird.
In einer Cox-Regression wird der Zusammenhang zwischen Prädiktoren (Kovariaten) und Survival Time untersucht. Um zur Gleichung der Cox-Regression zu gelangen, gehen wir von der Hazard Function, h(t), und der Survival Function, S(t), aus.
- Die Hazard Function, h(t), für ein Ereignis zum Zeitpunkt t (also einem beliebigen Zeitpunkt) entspricht der Event Rate (der Geschwindigkeit, mit der Ereignisse eintreten) bei den Patienten, die das Ereignis noch nicht erlebt haben.
- Die Survival Function, S(t), ist die Wahrscheinlichkeit, das Ereignis (zum Zeitpunkt t) noch nicht erlebt zu haben.
Zwischen h(t) und S(t) besteht ein mathematischer Zusammenhang, der wie folgt lautet:
Die Cox-Regression geht von der Hazard Function aus und definiert folgendes Modell:
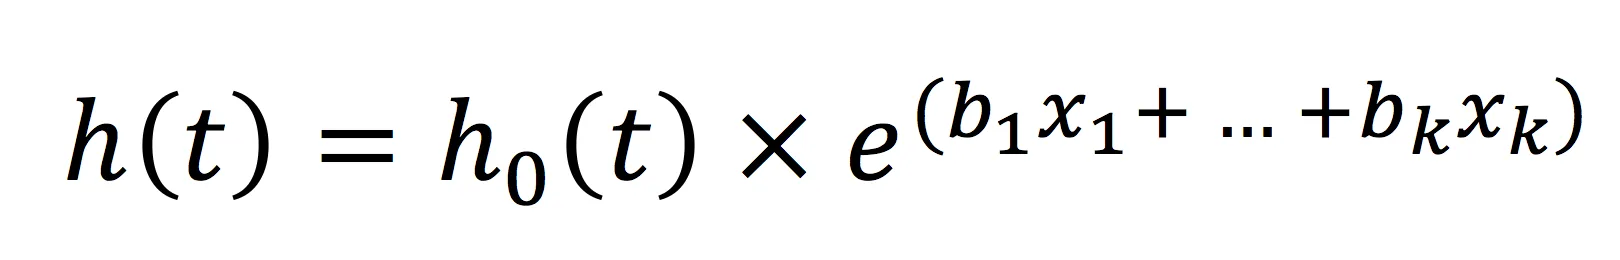
h0(t) ist der Baseline Hazard, und diese Größe kann etwas verzwickt sein. Der Baseline Hazard ist das Risiko, das ein Individuum hat, wenn alle Prädiktoren den Wert 0 haben. Dazu zwei Beispiele. (1) Stellen Sie sich vor, wir untersuchen, wie das Alter die Mortalität beeinflusst. In einer Cox-Regression mit dem Alter als einzigem Prädiktor wäre der Baseline Hazard das Risiko des Menschen im Alter = 0 Jahre. Nach der Geburt kommt mit zunehmendem Alter Risiko hinzu. (2) Stellen Sie sich vor, wir untersuchen stattdessen, wie der Blutdruck die Mortalität beeinflusst. In einem solchen Modell wäre der Baseline Hazard das Risiko des Individuums bei einem Blutdruck = 0, was biologisch nicht sinnvoll ist (kein lebender Mensch hat einen Blutdruck = 0). Der Baseline Hazard ist also das Risiko des Individuums, wenn alle Prädiktoren auf 0 gesetzt werden, was gleichbedeutend damit ist, dass das Modell keine Prädiktoren enthält. Der Baseline Hazard lässt sich somit als das Risiko in der „Ausgangslage“ auffassen.
x1, x2 ... xk sind die Prädiktoren (Kovariaten), mit denen die Hazard Function eines Individuums modelliert wird. Die Gesamtheit der Prädiktoren ähnelt somit einer gewöhnlichen multiplen (linearen) Regression. Die Prädiktoren können stetige oder kategoriale Variablen sein. Wie aus der obigen Formel hervorgeht, wird die gesamte Prädiktorsumme exponenziert (e).
Das Cox-Modell besagt also, dass der Hazard zum Zeitpunkt t das Produkt aus h0(t) und der Exponentialfunktion (e) der gemeinsamen Wirkung der Prädiktoren ist. Im nächsten Schritt teilen wir beide Seiten des Gleichheitszeichens durch den Baseline Hazard und logarithmieren zudem beide Seiten. Auf der rechten Seite des Gleichheitszeichens verschwindet h0(t), und die Exponenzierung entfällt. Auf der linken Seite des Gleichheitszeichens verbleibt der natürliche Logarithmus von h(t)/h0(t).
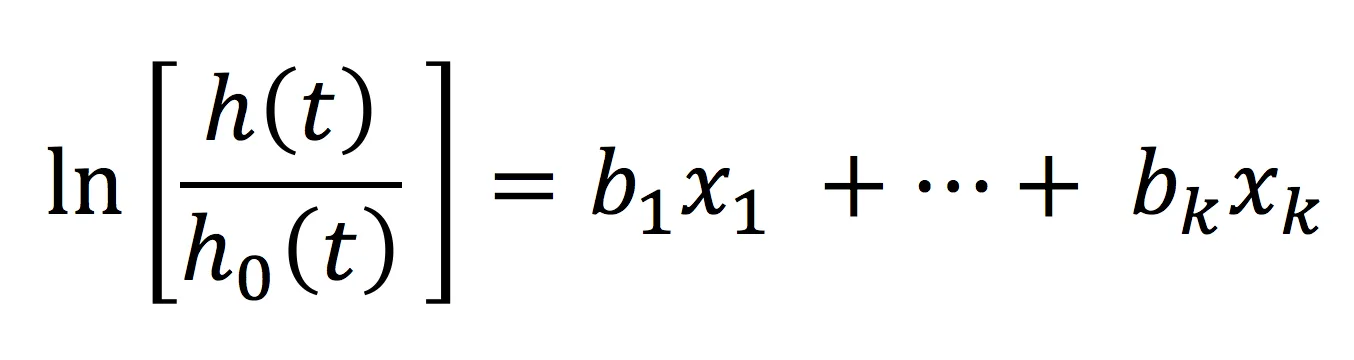
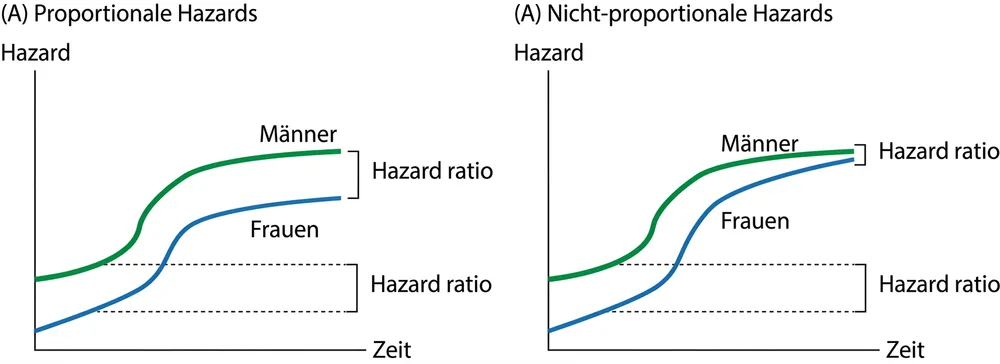
Die linke Seite der Gleichung ist der Hazard (das Risiko) des Individuums, die rechte Seite ist eine gewöhnliche lineare Regression. Dieses Vorgehen ist geradezu genial, denn wir sind nun bei einer Gleichung angelangt, mit der sich das Überleben als lineare Funktion der Prädiktoren des Individuums untersuchen lässt. Es war Sir David Cox, der die mathematischen Beweise hierfür vorlegte, und er betonte, dass die Gleichung nur gilt, wenn der Hazard proportional ist. Cox Proportional Hazards Model ist ein Synonym für Cox-Regression. Proportional Hazard bedeutet, dass das Verhältnis (der Quotient) der Hazard Functions zweier Individuen über die Zeit konstant sein muss. Dies gilt für alle Merkmale, die die Individuen in der Studie kennzeichnen. Dazu ein Beispiel. Untersuchen wir die Mortalität in Göteborg und nehmen Diabetes als Prädiktor in das Modell auf, so muss der Quotient der Hazard Functions von Diabetikern und Nicht-Diabetikern während der gesamten Nachbeobachtung konstant sein. Haben Diabetiker zu Beginn der Nachbeobachtung ein dreifach erhöhtes Sterberisiko, so muss dieses Risiko (dreifach) für Diabetiker während der gesamten Nachbeobachtung der Studie gleich hoch sein. Die Erklärung dafür ergibt sich aus der nächsten Gleichung, in der die Hazard Functions zweier Individuen verglichen werden:
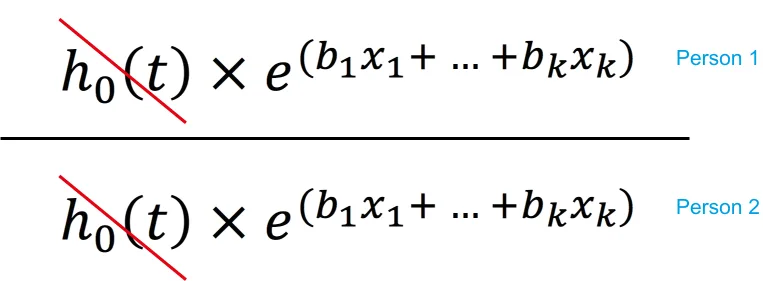
Dieser Quotient zweier Hazard Functions ist die Hazard Ratio (HR). Sie ist also der relative Unterschied im Risiko von Individuum 1 im Vergleich zu Individuum 2. Da h0(t) sowohl im Zähler als auch im Nenner vorkommt, kürzt er sich vollständig heraus. In der Gleichung kommt auch die Zeit nicht vor. Somit unterscheiden sich Individuum 1 und Individuum 2 nur durch die Werte der Prädiktoren; weder der Baseline Hazard noch die Zeit können die Hazard Ratio beeinflussen, die daher zwischen Individuum 1 und Individuum 2 konstant ist. Das bedeutet auch: Hätte einer der Prädiktoren (x1, x2 ... xk) eine über die Zeit variierende Wirkung, wäre die Voraussetzung der Proportional Hazards nicht erfüllt, und das Modell würde ungültig. In Abbildung 4 werden Proportional Hazards und Non-Proportional Hazards veranschaulicht.
Hazard Ratio (Hazardquotient)
Die Hazard Ratio wird berechnet, indem man den Hazard eines Individuums durch den Hazard eines anderen Individuums teilt (siehe Formel oben). Die Hazard Ratio wird berechnet, wenn ein Ereignis eintritt. Tritt ein Ereignis zum Zeitpunkt t ein, wird die Hazard Ratio berechnet, indem man den Hazard des Individuums, das das Ereignis erlebt hat, durch den Hazard der Übrigen teilt, die bis zum Zeitpunkt t ohne das Ereignis überlebt haben. Der Baseline Hazard kürzt sich (wie oben erläutert) aus dem Quotienten heraus, ebenso ist der Zeitpunkt irrelevant, da alle Individuen zum selben Zeitpunkt verglichen werden. Was die Individuen kennzeichnet, sind somit ihre Prädiktoren (x1, x2 ... xk). Damit lässt sich die Wirkung der Prädiktoren analysieren! In einer Cox-Regression schätzen wir also die Koeffizienten der Prädiktoren (x1, x2 ... xk), die den Einfluss dieser Prädiktoren auf das Überleben darstellen. Die Hazard Ratio, die man durch Division der Hazards zweier Individuen erhält, liegt logarithmiert vor, was sie schwer interpretierbar macht. Um dies zu beheben, wird der Koeffizient exponenziert. Beträgt der Regressionskoeffizient 0,5, so ist der exponenzierte Koeffizient e0,5 = 1,65. Wenn wir den Begriff Hazard Ratio verwenden, meinen wir eigentlich den exponenzierten Koeffizienten!
Interpretation der Hazard Ratio
- Bei einem stetigen Prädiktor ist die Hazard Ratio die Zunahme bzw. Abnahme des Hazards, wenn der Prädiktor X um eine Einheit steigt.
- Bei einer kategorialen Variablen ist die Hazard Ratio der Unterschied im Hazard zwischen zwei (oder mehr) Gruppen, wobei eine der Gruppen die Referenzgruppe ist.
Zum besseren Verständnis brauchen wir ein Beispiel, das wir selbst in R erstellen.
R-Code
library(survival)
## Wir erstellen eine Cox-Regression, die untersucht, wie age, sex und meal.cal die Mortalität beeinflussen
modell2 <- coxph(Surv(time, status==2) ~ age + factor(sex) + meal.cal, data = lung)
## Wir installieren und laden ein Package, das ansprechende Tabellen mit den Ergebnissen erstellt
install.packages("forestmodel")
library(forestmodel)
forest_model(modell2)
Ergebnisse des Modells
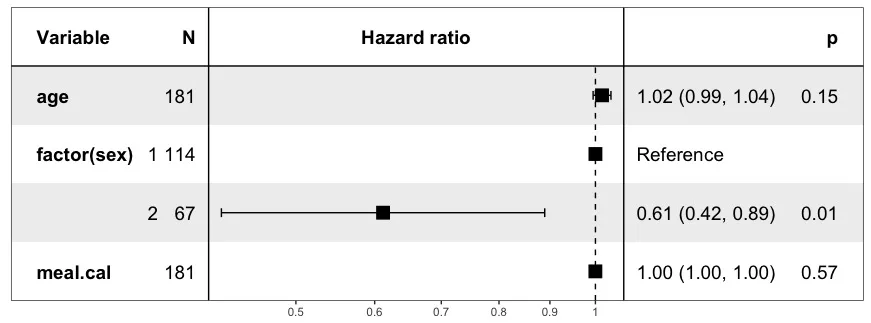
Dieses Modell hat also drei Prädiktoren: age, sex und meal.cal. Sex ist ein kategorialer Prädiktor mit den Stufen 1 (Männer) und 2 (Frauen). Age und meal.cal sind stetige Prädiktoren. Die Hazard Ratio wird sowohl grafisch (Mitte) als auch in Zahlen (vorletzte Spalte) dargestellt. Beachten Sie, dass die Hazard Ratio zusammen mit ihrem 95-%-Konfidenzintervall angegeben wird. So beträgt zum Beispiel die Hazard Ratio für sex 1,02 mit einem 95-%-Konfidenzintervall von 0,99 bis 1,04. Die letzte Spalte ist der p-Wert, der angibt, ob der Prädiktor einen statistisch signifikanten Zusammenhang mit der Mortalität aufweist. Dies ist eine typische Darstellung einer Cox-Regression. Die Spalte „N“ gibt an, wie viele Individuen in jeder Kategorie enthalten sind (diese Spalte kann ignoriert werden). Es folgt die Interpretation der Ergebnisse.
- Hazard Ratio für sex: In der Tabelle ist sex in zwei Zeilen dargestellt. Das liegt daran, dass sex eine kategoriale Variable mit zwei Stufen ist. Für Männer erhalten wir keine Koeffizienten (Hazard Ratio), weil Männer die Referenzkategorie sind. Bei allen kategorialen Variablen gibt es stets eine Referenzkategorie, mit der die übrigen Kategorien verglichen werden. Wir erhalten somit die Hazard Ratio für Frauen, und das Ergebnis lautet 0,61 mit einem Konfidenzintervall von 0,42 bis 0,89. Dies ist die Hazard Ratio für Frauen im Vergleich zu Männern. Die Hazard Ratio ist kleiner als 1, was bedeutet, dass Frauen ein geringeres Risiko haben als Männer. Subtrahieren wir 1 von 0,61 und multiplizieren die Differenz mit 100, erhalten wir den Risikounterschied in Prozent; (0,61–1,0)×100 = –39 %. Frauen haben im Vergleich zu Männern ein um 39 % geringeres Sterberisiko. Dies ist also der „Punktschätzer“, und er ist mit einer gewissen Unsicherheit behaftet. Deshalb erhalten wir auch ein 95-%-Konfidenzintervall, das anzeigt, dass Frauen (mit 95 % Sicherheit) ein um 58 % bis 11 % geringeres Risiko haben als Männer.
- Hätten wir einen Prädiktor mit mehr als 2 Stufen, wäre die Interpretation dieselbe; eine Kategorie ist die Referenz, und die übrigen Kategorien werden mit ihr verglichen.
- Das Konfidenzintervall für Frauen schließt den Wert 1,0 nicht ein. Beträgt die Hazard Ratio 1,0, sind Zähler und Nenner des Quotienten ja gleich groß, was bedeutet, dass zwischen den Gruppen kein Unterschied besteht. Ein Konfidenzintervall, das 1,0 einschließt, zeigt daher an, dass man nicht mit 95 % Sicherheit sagen kann, dass ein Unterschied zwischen den Gruppen besteht. Bei den Frauen ist 1,0 nicht im Konfidenzintervall enthalten, sodass wir mit 95 % Sicherheit sagen können, dass ein Unterschied zwischen Männern und Frauen besteht. Dies wird durch den p-Wert (0,01) gestützt, der angibt, dass das Geschlecht ein statistisch signifikanter Prädiktor ist.
- Dieses Modell enthält also neben sex auch age und meal.cal. Die Wirkung von sex ist damit für die Wirkung der übrigen Prädiktoren im Modell adjustiert (die übrigen Prädiktoren werden „konstant gehalten“).
- Age (Alter) ist ein stetiger Prädiktor. Daher wird die Hazard Ratio als Zunahme des Hazards pro Einheit Altersanstieg interpretiert. In dieser Studie wurde das Alter in Jahren gemessen, sodass die Hazard Ratio die Zunahme des Hazards für jedes Jahr ist, das die Teilnehmer älter werden. Das Ergebnis lautete 1,02 mit einem Konfidenzintervall von 0,99 bis 1,04. Da die Hazard Ratio (der Punktschätzer) 1,02 beträgt, bedeutet dies, dass das Sterberisiko mit jedem Lebensjahr der Teilnehmer um 2 % steigt. Wie stark das Risiko über 15 Jahre steigt, lässt sich leicht mit der Rechnung 1,0215 bestimmen, die eine Hazard Ratio von 1,35 ergibt (d. h. 35 % erhöhtes Risiko). In diesem Fall schließt das Konfidenzintervall jedoch 1,0 ein, da es von 0,99 bis 1,04 reicht, und deshalb können wir nicht sicher sagen, dass das Alter einen Effekt hat. Diese Aussage wird durch den p-Wert gestützt, der 0,15 beträgt und damit nicht signifikant ist.
In der Cox-Regression ist der Zusammenhang zwischen Prädiktor und Hazard also linear. Das Modell ist jedoch nicht vollständig parametrisch, da es einen Baseline Hazard gibt. Die Cox-Regression ist somit ein semiparametrisches Modell.
Konfidenzintervalle und p-Werte für die Hazard Ratio
In R und jeder anderen Statistiksoftware erhält man beim Erstellen des Modells automatisch Standardfehler (SE), p-Werte und Konfidenzintervalle. Das Konfidenzintervall ist ein sogenanntes Wald-Intervall, da zur Berechnung des Intervalls direkt die Schätzer aus dem Modell verwendet werden.
Untere Grenze: HR – 1,96×SE
Obere Grenze: HR + 1,96×SE
Dabei ist HR die Hazard Ratio und SE der Standardfehler.
Details zu Proportional Hazards
Proportional Hazard lässt sich auch über Interaktionen zwischen einem Prädiktor und der Zeit erklären. Erfüllt ein Prädiktor das Kriterium der Proportional Hazard, darf es keine statistisch signifikante Interaktion zwischen diesem Prädiktor und der Nachbeobachtungszeit (Survival Time) geben. Man kann also einen Interaktionsterm (Prädiktor×Nachbeobachtungszeit) bilden und prüfen, ob er statistisch signifikant ist. Ist die Interaktion nicht signifikant, bedeutet dies, dass der Prädiktor bei allen Werten von t (Nachbeobachtungszeit) dieselbe Wirkung auf die Hazard Function ausübt, und das Kriterium der Proportional Hazard ist erfüllt. Ist die Interaktion dagegen signifikant, bedeutet dies, dass die Wirkung des Prädiktors über die Zeit variiert, und dann verletzt diese Variable die Annahme der Proportional Hazard. Es gibt weitere Möglichkeiten, Proportional Hazards zu überprüfen, und zwar die folgenden:
- Beurteilung der Schoenfeld-Residuen
- Darstellung von log(-log S(t)) gegen t
Eigentlich sollte man die beiden letztgenannten Methoden den Interaktionstermen vorziehen. In R gibt es einfache Funktionen, die sowohl Schoenfeld-Residuen als auch Grafiken von log(-log S(t)) gegen t darstellen.
Stratifizierung (das stratifizierte Cox-Modell)
Die Cox-Regression bietet die Möglichkeit, für Variablen zu adjustieren, die nicht im Modell enthalten sind, und zwar durch Stratifizierung. Die Stratifizierung bei der Cox-Regression darf nicht mit der Stratifizierung bei der gewöhnlichen linearen (multiplen) Regression verwechselt werden.
Bei der gewöhnlichen linearen (multiplen) Regression bedeutet Stratifizierung, dass man anhand einer kategorialen Variablen separate Modelle erstellt. Dazu ein Beispiel. Angenommen, wir untersuchen, wie das Alter den Blutdruck beeinflusst, und verfügen außerdem über Angaben zum Körpergewicht. Wollen wir wissen, wie das Alter den Blutdruck in verschiedenen Gewichtskategorien beeinflusst, können wir die Analyse stratifizieren, indem wir eine Regression für Normalgewichtige, eine für Übergewichtige und eine für Personen mit Adipositas durchführen. Das sind also drei separate Modelle, die separate Koeffizienten für das Alter liefern.
Bei der Cox-Regression kann die Stratifizierung anders gehandhabt werden. Das Cox-Modell erlaubt es, die Daten (die Patienten) anhand einer kategorialen Variablen zu stratifizieren. Der Baseline Hazard darf zwischen diesen Strata variieren. Das Modell kann dann eine gemeinsame (kumulative) Wirkung des Alters über alle Strata schätzen. Wir erhalten dann nur einen Koeffizienten für das Alter statt separater Koeffizienten in jedem Stratum. Man kann sagen, dass die Wirkung des Alters über alle Strata „gepoolt“ (zusammengefasst) wird.
Es gibt mehrere Situationen, in denen es sinnvoll ist, das Modell zu stratifizieren. Dazu ein Beispiel. Verletzt eine Variable die Annahme der Proportional Hazard, kann man die Variable in zwei oder mehr geeignete Stufen kategorisieren und das Modell nach dieser Variablen stratifizieren. Damit hat man für die Variable adjustiert und muss sich keine Sorgen machen, dass sie die Annahme der Proportional Hazards verletzt. Der Nachteil ist, dass man für die Variable keine Regressionskoeffizienten erhält (wenn sie für die Analyse ohnehin nicht von Interesse ist, ist dies jedoch kein großer Nachteil.