
Cox-Regression
Die Cox-Regression ist geradezu ein Synonym für Überlebenszeitanalyse. Das liegt an den zahlreichen Vorteilen der Methode gegenüber anderen Regressionsmodellen. Die Alternativen zur Cox-Regression, etwa die Weibull-Regression, liefern unter bestimmten Umständen genauere Modelle, allerdings um den Preis einer höheren Komplexität. Die Cox-Regression ist ein einfaches und leistungsfähiges Modell zur Untersuchung des Überlebens. Der Unterschied zwischen der Cox-Regression und dem Kaplan-Meier-Schätzer besteht darin, dass Erstere ein Regressionsmodell ist. Wir können also untersuchen, wie mehrere Prädiktoren das Überleben beeinflussen. Cox-Regressionen können, ebenso wie die gewöhnliche multiple Regression, einen oder mehrere Prädiktoren enthalten.
Die Kapitel Überlebenszeitanalyse und Kaplan-Meier-Schätzer sollten vor diesem Kapitel gelesen werden. Um die Cox-Regression anzuwenden, ist es nicht notwendig, alle folgenden Formeln zu verstehen. Auf die mathematische Diskussion folgen Erläuterungen und praktische Beispiele zur Durchführung und Interpretation von Cox-Regressionen.
Mit der Cox-Regression wird der Zusammenhang zwischen Prädiktoren (Kovariaten) und der Survival Time (Beobachtungszeit) untersucht. Um die Cox-Regression zu verstehen, gehen wir von der Hazard-Funktion (hazard function), , und der Überlebensfunktion (survival function), , aus.
- : Die Überlebensfunktion (survival function) ist die Wahrscheinlichkeit, dass eine Person nach dem Zeitpunkt noch am Leben ist.
- Interpretation: Wie hoch ist die Wahrscheinlichkeit, dass ich in einem Jahr noch lebe?
- : Die Hazard-Funktion (hazard function, hazard rate) ist das momentane Risiko (die Wahrscheinlichkeit), dass das Ereignis zum Zeitpunkt eintritt, vorausgesetzt, die Person hat bis überlebt.
- Interpretation: Wie hoch ist die Wahrscheinlichkeit, dass ich in einem Jahr sterbe, vorausgesetzt, ich habe bis jetzt überlebt?
und haben Eigenschaften, die sie für die Untersuchung des Überlebens geeignet machen. Das zeigt sich nicht zuletzt an den relevanten Fragen, die die Funktionen beantworten (siehe Interpretation oben).
Die Survival Time (Überlebenszeit, T) ist eine stetige Variable (häufig als Anzahl von Tagen angegeben) und lässt sich daher mit einer kumulativen Verteilungsfunktion (cumulative distribution function, CDF) beschreiben:
beschreibt die Wahrscheinlichkeit, dass kleiner oder gleich ist. Die Überlebenszeit wird mit bezeichnet und lässt sich ebenfalls mit einer kumulativen Verteilungsfunktion beschreiben:
beschreibt die Wahrscheinlichkeit, dass das Ereignis spätestens zum Zeitpunkt eintritt. Die Wahrscheinlichkeit, dass ein neugeborenes Kind im Alter von 90 Jahren stirbt, liegt bei etwa 1 %. Erreicht das Kind jedoch das Alter von 89 Jahren, beträgt die Wahrscheinlichkeit, am 90. Geburtstag zu sterben, 10 %. Mit können wir schätzen, also die Wahrscheinlichkeit, dass das Individuum den Zeitpunkt überlebt:
ist die Wahrscheinlichkeit, den Zeitpunkt zu überleben.
Die Hazard-Funktion (hazard function) hat folgende Formel:
bedeutet, dass der Quotient gilt, wenn das Risiko (Hazard) über einen sehr kurzen Zeitraum betrachtet wird, d. h. wenn (die Differenz in ) gegen geht. Der Zähler von enthält |, was bedeutet, dass es sich um eine bedingte Wahrscheinlichkeit handelt. Der Zähler beschreibt die Wahrscheinlichkeit, dass das Ereignis in einem kleinen Zeitintervall zwischen und eintritt, unter der Bedingung, dass das Individuum bis überlebt hat. Der Nenner gibt die Länge des Zeitintervalls an (). Die Hazard-Funktion () entspricht somit der Event Rate (der Geschwindigkeit, mit der Ereignisse eintreten) bei Individuen, die das Ereignis noch nicht erlitten haben.
Der Zähler von bildet den Quotienten aus der Wahrscheinlichkeit, dass T im Intervall bis liegt, und . Letzteres entspricht , Ersteres lässt sich für kleine als umformulieren. Indem wir diesen Quotienten durch dividieren, erhalten wir folgende Formel:
Dies ist die einfache Hazard-Funktion. Sie besagt, dass die Geschwindigkeit, mit der Ereignisse zum Zeitpunkt eintreten, der Dichte (engl. density) der Ereignisse zum Zeitpunkt entspricht, dividiert durch die Wahrscheinlichkeit, bis zum Zeitpunkt zu überleben, ohne das Ereignis zu erleiden. Der Zähler ist eine Dichtefunktion (probability density function, PDF). Da die Ableitung von ist, lässt sich die Formel wie folgt schreiben:
Integriert man diese von bis und gilt , so kann man mit der folgenden Formel die Wahrscheinlichkeit, bis zum Zeitpunkt zu überleben, als Funktion des Hazards zu allen Zeitpunkten bis beschreiben.
Die obige Integralfunktion ist der kumulative Hazard (cumulative hazard, cumulative risk) und wird wie folgt formuliert:
Der kumulative Hazard ist das akkumulierte Risiko, das ein Individuum auf dem Weg von bis erwirbt.
Mit können wir stets berechnen und damit erhalten. Mit können wir stets den kumulativen Hazard berechnen und ihn exponenzieren, um zu erhalten.
Ein Individuum, das bis zum Zeitpunkt überlebt hat, interessiert sich in der Regel eher für seine bedingte Überlebenswahrscheinlichkeit als für die unbedingte. In der Praxis bedeutet das: Ein Individuum, das nach einer Krebsdiagnose bis zum Zeitpunkt überlebt hat, interessiert sich mehr für sein erwartetes Überleben ab dem Zeitpunkt . Zudem ist die Hazard-Funktion eine einfache und pragmatische Berechnung, wenn die Beobachtungen rechtszensiert sind.
Cox-Regression
Mit der Cox-Regression wird der Hazard eines Individuums mit den Prädiktoren (Kovariaten) wie folgt beschrieben:
Dabei ist der Baseline Hazard, also das Risiko des Individuums, wenn alle Variablen den Wert 0 haben (bei stetigen Variablen) bzw. auf der Referenzstufe liegen (bei kategorialen Variablen), und sind die exponenzierten Prädiktoren. Die einzige Größe oben, die enthält, ist der Baseline Hazard. Wie unten gezeigt wird, fällt der Baseline Hazard automatisch heraus, und damit wird der Hazard unabhängig von .
Haben alle Prädiktoren den Wert 0, fällt der gesamte Exponent weg, und die Formel lautet:
.
Die obige Formel ist die Definition des Baseline Hazards, also des Hazards, wenn alle Prädiktoren den Wert 0 haben. Der Baseline Hazard ist in der Cox-Regression uninteressant. Über ihn werden keine Annahmen getroffen, und er darf beliebig variieren. Der Grund dafür ist, dass die Cox-Regression darauf abzielt, Expositionen (etwa Behandlungen, Interventionen usw.) zu vergleichen. Werden zwei Individuen verglichen, heben sich ihre Baseline Hazards gegenseitig auf, wie unten gezeigt wird.
Logarithmiert man beide Seiten der Gleichung, erhält man ein Modell, in dem die Effekte der Prädiktoren additiv (d. h. sie haben einen unabhängigen Einfluss auf das untersuchte Outcome) und linear sind, was an die klassische lineare Regression erinnert.
Angenommen, wir untersuchen die Assoziation zwischen dem Prädiktor Geschlecht und dem Überleben. Das Geschlecht ist wie folgt definiert:
Für diese Variable ist Mann die Referenzgruppe. Die Cox-Regression für dieses Modell lautet:
Hazard für Männer:
Hazard für Frauen:
Hazard Ratio (HR, Hazard-Quotient)
Die Hazard Ratio (HR) wird als Quotient der Hazards der Gruppen berechnet, wobei die Referenzgruppe (Männer) den Nenner bildet:
Der Effekt von ist zu allen Zeitpunkten gleich. Die Formel setzt voraus, dass die Hazard Ratio nicht über die Zeit variiert, und funktioniert nur unter dieser Bedingung. Aus diesem Grund wird das Cox-Modell auch Cox Proportional Hazards Model genannt.
Die Cox-Regression bedeutet also, dass der Hazard (das Risiko) zum Zeitpunkt das Produkt aus dem Baseline Hazard und dem Exponenten des Gesamteffekts der Prädiktoren ist.
Cox-Regression in der Praxis
Baseline Hazard in der Cox-Regression
ist der Baseline Hazard, und diese Größe kann schwer zu verstehen sein. Der Baseline Hazard ist das Risiko, das das Individuum hat, wenn alle Prädiktoren den Wert 0 haben. Zwei Beispiele:
- Angenommen, wir untersuchen, wie das Alter die Mortalität beeinflusst. In einer Cox-Regression mit dem Alter als einzigem Prädiktor wäre der Baseline Hazard das Risiko, das ein Mensch im Alter von 0 Jahren hat. Nach der Geburt kommt mit zunehmendem Alter Risiko hinzu.
- Angenommen, wir untersuchen, wie der Blutdruck die Mortalität beeinflusst. In einem solchen Modell wäre der Baseline Hazard das Risiko des Individuums bei einem Blutdruck von 0, was biologisch nicht sinnvoll ist (kein lebender Mensch hat einen Blutdruck von 0). Das bedeutet, dass der Baseline Hazard das Risiko des Individuums ist, wenn alle Prädiktoren auf 0 gesetzt werden, was gleichbedeutend damit ist, dass das Modell keine Prädiktoren enthält.
Prädiktoren (Kovariaten) in der Cox-Regression
sind die Prädiktoren (Kovariaten), mit denen die Hazard-Funktion eines Individuums modelliert wird. Die Gesamtheit der Prädiktoren ähnelt damit einer gewöhnlichen multiplen (linearen) Regression. Die Prädiktoren können stetige oder kategoriale Variablen sein. Die Prädiktoren üben einen additiven Effekt aus, d. h. jeder einzelne Prädiktor hat einen (von den anderen Prädiktoren) unabhängigen Effekt auf das Outcome (). Darüber hinaus ist der Zusammenhang zwischen den Prädiktoren und dem Outcome linear. Die Annahmen der Additivität und Linearität lassen sich modifizieren (siehe unten).
Proportional Hazards
Wie oben erwähnt, ist der Hazard (das Risiko) zum Zeitpunkt das Produkt aus dem Baseline Hazard und dem Exponenten des Gesamteffekts der Prädiktoren. Dies gilt unter der Annahme, dass der Hazard über die Zeit proportional ist. Proportional Hazards bedeutet, dass das Verhältnis (der Quotient) der Hazard-Funktionen zweier Individuen über die Zeit konstant sein muss. Dies gilt für alle Merkmale, die die Individuen charakterisieren. Ein Beispiel folgt.
Untersuchen wir die Mortalität bei Personen mit oder ohne Diabetes, so muss der Quotient der Hazard-Funktionen von Diabetikern und Nicht-Diabetikern während der gesamten Nachbeobachtung konstant sein. Besteht zu Beginn der Nachbeobachtung für Diabetiker ein zweifach erhöhtes Sterberisiko, so muss für Diabetiker während der gesamten Nachbeobachtung der Studie ein ebenso hohes Risiko (zweifach erhöhtes Risiko) bestehen.
Der Quotient zweier Hazard-Funktionen ist die Hazard Ratio (HR). Sie ist also der relative Unterschied im Risiko zweier Individuen. Da sowohl im Zähler als auch im Nenner vorkommt, kürzt es sich heraus. In der Gleichung kommt auch die Zeit nicht vor. Somit unterscheiden sich Individuum 1 und Individuum 2 nur durch die Werte der Prädiktoren; weder der Baseline Hazard noch die Zeit können die Hazard Ratio beeinflussen, die daher zwischen Individuum 1 und Individuum 2 konstant ist. Das bedeutet auch: Hätte einer der Prädiktoren () einen über die Zeit variierenden Effekt, wäre die Forderung nach Proportional Hazards nicht erfüllt, und das Modell würde ungültig.
Hazard Ratio (Hazard-Quotient)
Die Hazard Ratio wird berechnet, indem man den Hazard eines Individuums durch den Hazard eines anderen Individuums dividiert (siehe Formel oben). Die Hazard Ratio wird berechnet, wenn ein Ereignis eintritt. Tritt ein Ereignis zum Zeitpunkt t ein, wird die Hazard Ratio berechnet, indem man den Hazard des Individuums, das das Ereignis erlitten hat, durch den Hazard der übrigen dividiert, die bis zum Zeitpunkt t ohne das Ereignis geblieben sind. Der Baseline Hazard fällt (siehe oben) aus dem Quotienten heraus, ebenso ist der Zeitpunkt irrelevant, da alle Individuen zum selben Zeitpunkt verglichen werden. Was die Individuen charakterisiert, sind somit ihre Prädiktoren (x1, x2 … xk). Auf diese Weise lässt sich der Effekt der Prädiktoren analysieren.
In einer Cox-Regression werden also die Koeffizienten der Prädiktoren () berechnet, d. h. der Einfluss dieser Prädiktoren auf das Überleben. Die Hazard Ratio, die man erhält, wenn man die Hazards zweier Individuen dividiert, ist logarithmiert, was ihre Interpretation erschwert. Um dies zu beheben, wird der Koeffizient exponenziert. Beträgt der Regressionskoeffizient 0,5, so ist der exponenzierte Koeffizient e0,5 = 1,65. Wenn wir den Begriff Hazard Ratio verwenden, meinen wir eigentlich den exponenzierten Koeffizienten.
Interpretation der Hazard Ratio
- Bei einem stetigen Prädiktor ist die Hazard Ratio die Zunahme bzw. Abnahme des Hazards, die eintritt, wenn der Prädiktor um eine Einheit steigt.
- Bei einer kategorialen Variablen ist die Hazard Ratio der Unterschied im Hazard zwischen zwei (oder mehr) Gruppen, wobei eine der Gruppen die Referenzgruppe ist.
Um dies besser zu verstehen, brauchen wir ein Beispiel, und dieses Beispiel erstellen wir selbst in R.
Beispiel einer Cox-Regression in R
Wir verwenden Daten aus einer klinischen Studie zum Kolonkarzinom (Dickdarmkrebs). Diese Daten sind im Package survival enthalten, das auch viele wichtige Funktionen für die Überlebenszeitanalyse bereitstellt.
## tidyverse laden
library(tidyverse)

## survival-Package laden
library(survival)

## Beispieldaten importieren
data(cancer)
## Erste Zeilen inspizieren
head(colon)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1Wir kodieren einige Variablen um, damit sie korrekt als kategorial klassifiziert werden:
## Einige kategoriale Variablen umkodieren
colon <- colon |>
  mutate(sex = recode_factor(sex, '1'='Man', '0'='Kvinna'),
         perfor = recode_factor(perfor, '1'='Yes', '0'='No'),
         obstruct = recode_factor(obstruct, '1'='Yes', '0'='No'))
Nun erstellen wir eine Cox-Regression mit der Funktion coxph(). Das Ergebnis wird im Objekt min_modell gespeichert. Beachten Sie, dass wir mit der Funktion Surv() ein Survival-Objekt angeben müssen. In Surv() legen wir fest, welche Variablen die Beobachtungszeit (time) und das Outcome (status) darstellen. In diesem Fall geben wir mit status==1 an, welcher Wert von status bedeutet, dass das Ereignis eingetreten ist.
min_modell <- coxph(Surv(time, status==1) ~ sex + age + nodes + perfor + obstruct, data=colon)

## Ergebnis ausgeben
summary(min_modell)Call:
coxph(formula = Surv(time, status == 1) ~ sex + age + nodes +
perfor + obstruct, data = colon)
n= 1822, number of events= 897
(36 observations deleted due to missingness)
coef exp(coef) se(coef) z Pr(>|z|)
sexKvinna 0.057961 1.059674 0.067077 0.864 0.38753
age 0.001363 1.001364 0.002822 0.483 0.62911
nodes 0.088342 1.092362 0.006342 13.929 < 2e-16 ***
perforNo -0.223009 0.800107 0.181919 -1.226 0.22025
obstructNo -0.249065 0.779529 0.082675 -3.013 0.00259 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
exp(coef) exp(-coef) lower .95 upper .95
sexKvinna 1.0597 0.9437 0.9291 1.2086
age 1.0014 0.9986 0.9958 1.0069
nodes 1.0924 0.9154 1.0789 1.1060
perforNo 0.8001 1.2498 0.5601 1.1429
obstructNo 0.7795 1.2828 0.6629 0.9167
Concordance= 0.635 (se = 0.009 )
Likelihood ratio test= 145.1 on 5 df, p=<2e-16
Wald test = 202.8 on 5 df, p=<2e-16
Score (logrank) test = 206.2 on 5 df, p=<2e-16Die obige Ausgabe ist zwar informativ, ihr fehlen aber einige Informationen, und sie ist optisch nicht ansprechend genug, um sie in einen Bericht zu übernehmen. Mit dem Package gtsummary können wir eine optisch ansprechende Tabelle erstellen, die sich leicht anpassen lässt. Die Funktionen in gtsummary funktionieren wie die übrigen Funktionen im tidyverse, d. h. man fügt schrittweise Ebenen mit Komponenten hinzu, wie unten gezeigt. Sie können vermutlich erraten, was die einzelnen Funktionen der Tabelle hinzufügen.
library(gtsummary)

min_modell |>
  tbl_regression(exponentiate = TRUE) |>
  add_global_p() |>
  bold_labels() |>
  italicize_levels() |>
  add_nevent() |>
  add_glance_source_note()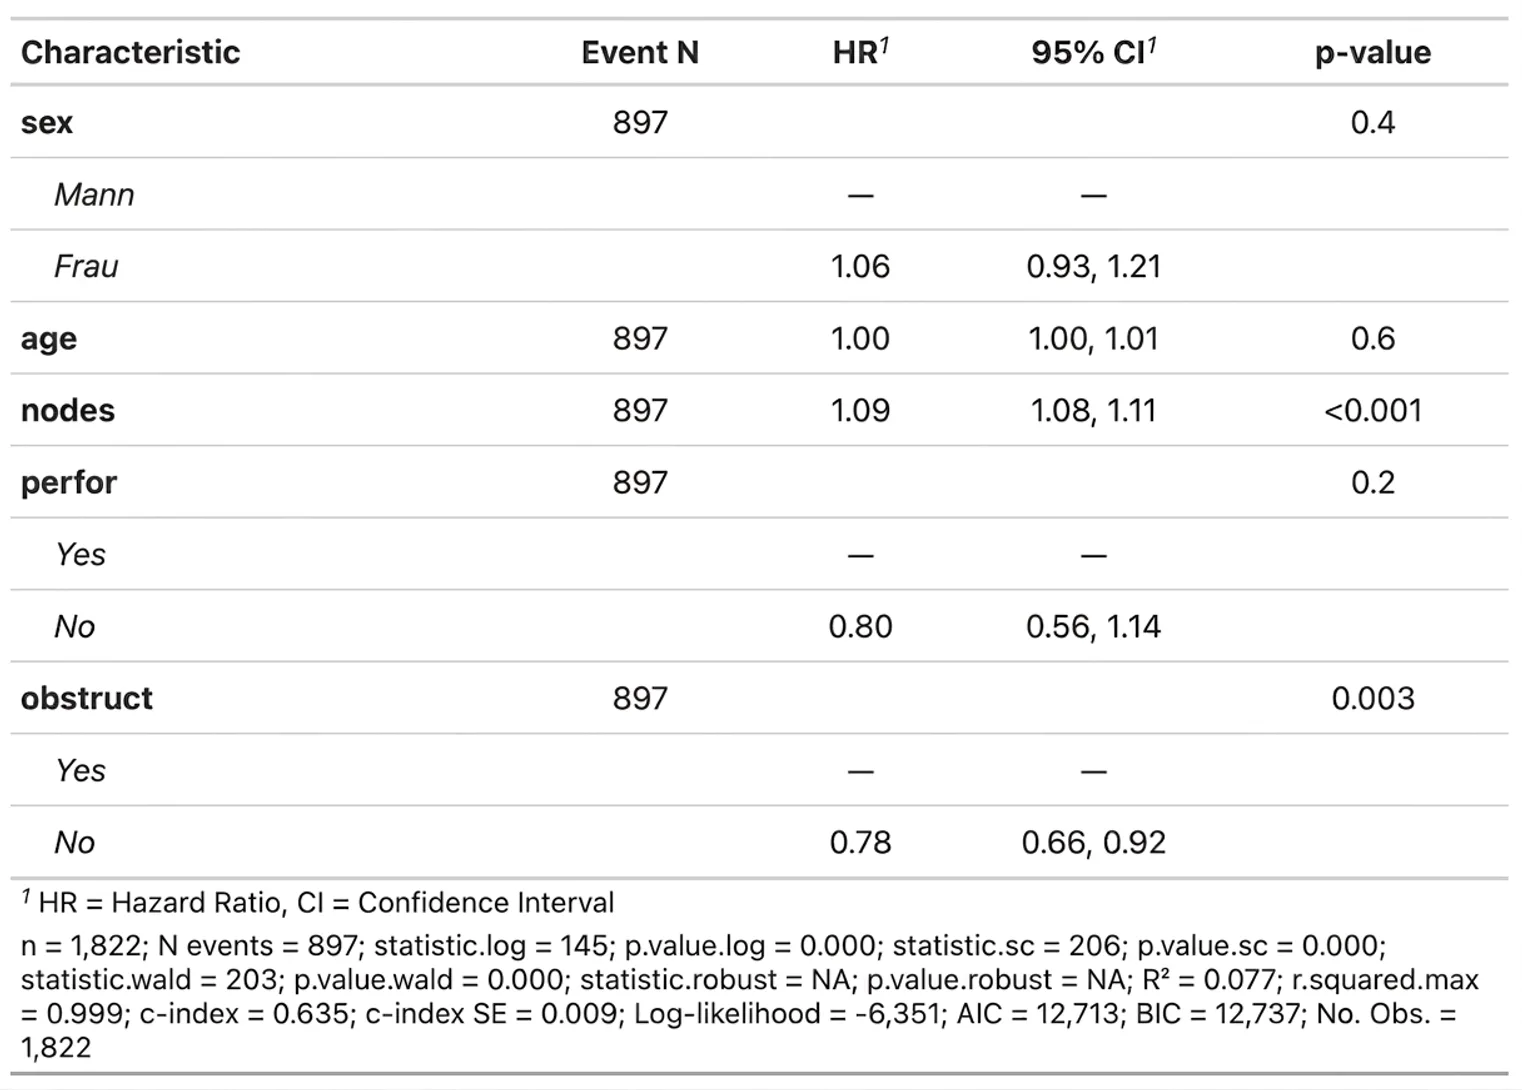
Interpretation der Cox-Regression
Das obige Modell hat fünf Prädiktoren: sex, age, nodes, perfor und obstruct. Sex ist ein kategorialer Prädiktor mit den Stufen Man (Mann) und Kvinna (Frau). Age und nodes sind stetige Prädiktoren. Die Hazard Ratio (HR) wird zusammen mit einem 95-%-Konfidenzintervall (95 % CI) angegeben. Die obigen Hazard Ratios werden wie folgt interpretiert:
- Für Männer ist keine Hazard Ratio angegeben. Das liegt daran, dass Männer die Referenzstufe der Variablen sex sind. Alle kategorialen Variablen haben eine Referenzstufe, mit der die übrigen Stufen verglichen werden.
- Die Hazard Ratio für Frauen beträgt 1,06, d. h. das relative Risiko ist für Frauen im Vergleich zu Männern 1,06-mal höher (also 6 % höher). Das Konfidenzintervall reicht von 0,93 bis 1,21. Das bedeutet, dass das wahre Risiko für Frauen mit 95 % Wahrscheinlichkeit zwischen 0,93 (d. h. das Risiko ist für Frauen 7 % niedriger als für Männer) und 1,21 (d. h. das Risiko ist für Frauen 21 % höher als für Männer) liegt. Dieses Konfidenzintervall schließt also den Wert 1,0 ein, was bedeutet, dass sowohl ein niedrigeres als auch ein höheres Risiko für Frauen im Vergleich zu Männern möglich ist. Deshalb ist die Variable sex nicht statistisch signifikant. Das zeigt auch der p-Wert von 0,4.
- Daraus folgt: Schließt ein Konfidenzintervall den Wert 1,0 ein, ist der Prädiktor nicht statistisch signifikant.
- Daraus folgt ebenfalls, dass ein kategorialer Prädiktor eine Referenzstufe haben muss, mit der die übrigen Stufen verglichen werden.
- Für die Variable age beträgt die Hazard Ratio 1,00, und auch das Konfidenzintervall schließt 1,00 ein, sodass die Variable kein statistisch signifikanter Prädiktor ist.
- Für die Variable nodes beträgt die Hazard Ratio 1,09, d. h. jedes Mal, wenn nodes um 1 Einheit steigt, erhöht sich das Risiko für das Ereignis (Tod) um 9 %. Das Konfidenzintervall reicht von 1,08 bis 1,11, d. h. der wahre Wert liegt mit 95 % Wahrscheinlichkeit zwischen 8 % und 11 % erhöhtem Risiko für das Ereignis pro Anstieg von nodes um 1 Einheit. Der p-Wert beträgt <0,001 und ist damit eindeutig signifikant.
- Für jeden Prädiktor im Modell ist die Hazard Ratio für die übrigen Variablen im Modell adjustiert. Der Effekt einer Erhöhung von nodes um 1 Einheit beträgt 1,09 (9 % erhöhtes Risiko), adjustiert für die übrigen Prädiktoren im Modell.
- Dieses Modell enthält also neben sex auch age und meal.cal. Damit ist der Effekt von sex für den Effekt der übrigen Prädiktoren im Modell adjustiert (die übrigen Prädiktoren werden „konstant gehalten“).
Das Konfidenzintervall in der Cox-Regression
Meist wird das Wald-Konfidenzintervall verwendet, eine einfache Berechnung mit dem Standardfehler (SE):
Untere Grenze: HR – 1,96×SE
Obere Grenze: HR + 1,96×SE
Dabei ist HR die Hazard Ratio und SE der Standardfehler (standard error).
Mehr zu Proportional Hazards (PH)
Proportional Hazards lassen sich auch über Interaktionen zwischen einem Prädiktor und der Zeit (Nachbeobachtungszeit) erklären. Erfüllt ein Prädiktor das Kriterium der Proportional Hazards, darf es keine statistisch signifikante Interaktion zwischen diesem Prädiktor und der Nachbeobachtungszeit (Survival Time) geben. Man kann also einen Interaktionsterm (Prädiktor × Nachbeobachtungszeit) bilden und prüfen, ob er statistisch signifikant ist. Ist die Interaktion nicht signifikant, übt der Prädiktor bei allen Werten von t (Nachbeobachtungszeit) denselben Effekt auf die Hazard-Funktion aus, und das Kriterium der Proportional Hazards ist erfüllt. Ist die Interaktion hingegen signifikant, variiert der Effekt des Prädiktors über die Zeit, und diese Variable verletzt die Annahme der Proportional Hazards. Es gibt weitere Möglichkeiten, die Proportional Hazards zu prüfen:
- Auswertung der Schoenfeld-Residuen
- Darstellung von log(-log S(t)) gegen t
Eigentlich sollte man die beiden letztgenannten Methoden den Interaktionstermen vorziehen. In R gibt es einfache Funktionen, die sowohl Schoenfeld-Residuen als auch Grafiken von log(-log S(t)) gegen t darstellen.
Zur Prüfung der PH-Annahme kann folgender Code verwendet werden:
library(survminer)

cox_ph <- cox.zph(min_modell)

ggcoxzph(cox_ph)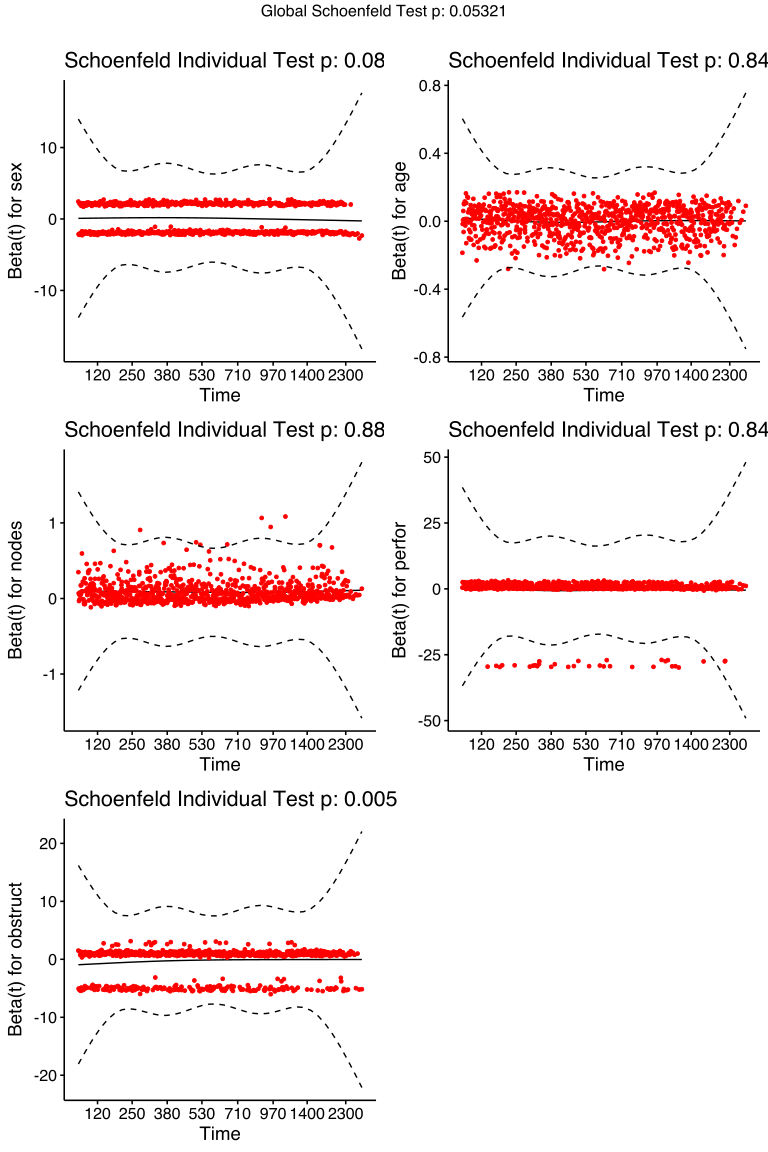
Die obigen Grafiken zeigen, wie für jeden einzelnen Prädiktor über die Zeit variiert. Es sollte keine Steigung und kein systematischer Trend weg von der horizontalen Linie erkennbar sein. Ist dies der Fall, ist der Effekt von über die Zeit konstant, und die Proportional-Hazards-Annahme ist erfüllt.
Verletzt eine Variable die PH-Annahme, lässt sich dies auf eine der folgenden Arten beheben:
- Eine Interaktion zwischen der Variablen und der Zeit in das Modell aufnehmen.
- Nach der Variablen stratifizieren, die die PH-Annahme verletzt. Der Nachteil dabei ist, dass man für eine Variable, nach der stratifiziert wird, keine Hazard Ratio erhält. Das ist allerdings nur dann ein Problem, wenn man sich gerade für die Hazard Ratio dieser Variablen interessiert.
Stratifizierte Cox-Regression
Die Cox-Regression bietet die Möglichkeit, für Variablen zu adjustieren, die nicht im Modell enthalten sind, und zwar durch Stratifizierung. Die Stratifizierung in der Cox-Regression darf nicht mit der Stratifizierung in der gewöhnlichen linearen (multiplen) Regression verwechselt werden.
Bei der gewöhnlichen linearen (multiplen) Regression bedeutet Stratifizierung, dass man anhand einer kategorialen Variablen separate Modelle erstellt. Angenommen, wir untersuchen, wie das Alter den Blutdruck beeinflusst, und haben zusätzlich Angaben zum Gewicht. Wollen wir wissen, wie das Alter den Blutdruck in verschiedenen Gewichtskategorien beeinflusst, können wir die Analyse stratifizieren, indem wir eine Regression für Normalgewichtige, eine Regression für Übergewichtige und eine Regression für Personen mit Adipositas durchführen. Das sind also drei separate Modelle, die separate Koeffizienten für das Alter liefern.
Bei der Cox-Regression lässt sich die Stratifizierung anders handhaben. Die Cox-Regression erlaubt es, die Daten (die Beobachtungen) anhand einer kategorialen Variablen zu stratifizieren. Der Baseline Hazard darf zwischen diesen Strata variieren. Das Modell kann dann einen gemeinsamen (kumulativen) Effekt des Alters über alle Strata schätzen. Wir erhalten dann nur einen Koeffizienten für das Alter statt separater Koeffizienten in jedem Stratum. Man kann sagen, dass der Effekt des Alters über alle Strata „gepoolt“ (zusammengefasst) wird.
Es gibt mehrere Situationen, in denen es sinnvoll ist, das Modell zu stratifizieren. Verletzt eine Variable die Annahme der Proportional Hazards, kann man die Variable in zwei oder mehr geeignete Stufen kategorisieren und das Modell nach dieser Variablen stratifizieren. Damit hat man für die Variable adjustiert und muss sich keine Sorgen machen, dass sie die Proportional Hazards verletzt. Der Nachteil ist, dass man für die Variable keine Regressionskoeffizienten erhält (ist sie für die Analyse ohnehin nicht von Interesse, ist das jedoch kein großer Nachteil.
Mit folgendem Code wird die Cox-Regression nach Geschlecht (sex) stratifiziert:
min_modell <- coxph(Surv(time, status==1) ~ strata(sex) + age + nodes + perfor + obstruct, data=colon)Wir geben das Ergebnis wie folgt mit der Funktion tbl_regression() aus:
min_modell|>
  tbl_regression(exponentiate = TRUE) |>
  add_global_p() |>
  bold_labels() |>
  italicize_levels() |>
  add_nevent() |>
  add_glance_source_note()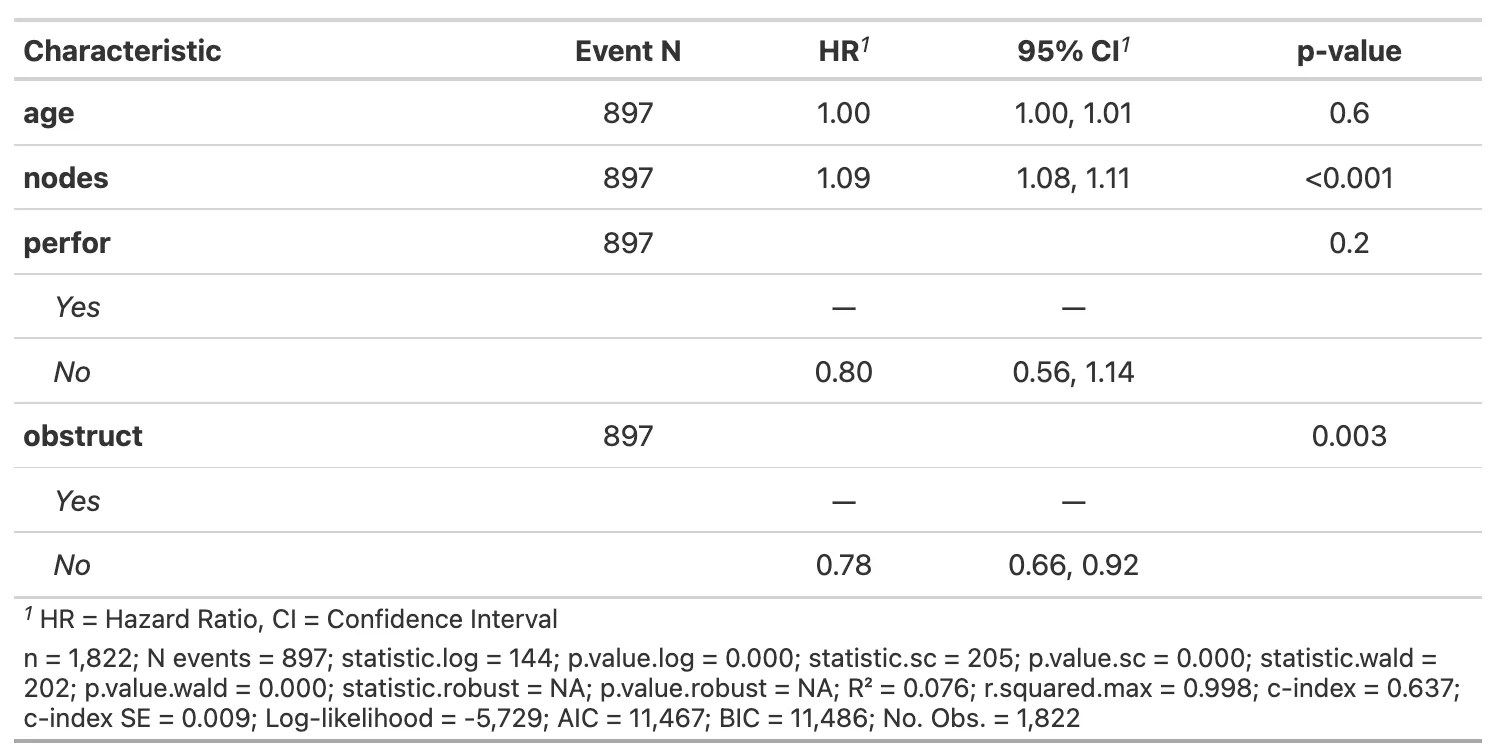
Wie oben ersichtlich, hat die Stratifizierung die Hazard Ratios der übrigen Prädiktoren im Modell nicht beeinflusst.
Literatur
Germán Rodríguez, Survival Models, Princeton university.
Cox DR and Oakes D (1984). Analysis of Survival Data. Chapman and Hall, New York.
Kalbfleisch JD and Prentice RL (2002). The Statistical Analysis of Failure Time Data. Second Edition. Wiley, New York.
Klein and Moeschberger (1997). Survival Analysis: Techniques for Censored and Truncated Data. Springer-Verlag, New York.
Lagakos SW (1979). General right censoring and its impact on the analysis of survival data, Biometrics 35:139-156.
Lawless JF (2003). Statistical Models and Methods for Lifetime Data. Wiley, New York.
Clark, T., Bradburn, M., Love, S., & Altman, D. (2003). Survival analysis part I: Basic concepts and first analyses. 232-238. ISSN 0007-0920.
M J Bradburn, T G Clark, S B Love, & D G Altman. (2003). Survival Analysis Part II: Multivariate data analysis – an introduction to concepts and methods. British Journal of Cancer, 89(3), 431-436.
Bradburn, M., Clark, T., Love, S., & Altman, D. (2003). Survival analysis Part III: Multivariate data analysis – choosing a model and assessing its adequacy and fit. 89(4), 605-11.
Clark, T., Bradburn, M., Love, S., & Altman, D. (2003). Survival analysis part IV: Further concepts and methods in survival analysis. 781-786. ISSN 0007-0920.