
Variablenselektion: Die richtigen Variablen einschließen
Ein Vorhersagemodell kann entweder dazu dienen, (1) den Effekt (die Assoziation) zwischen einem oder mehreren Prädiktoren () und dem Outcome zu schätzen, oder (2) ein Modell mit maximaler Vorhersagegüte zu erstellen. Im ersten Szenario, also wenn die Effekte der Prädiktoren geschätzt werden sollen, ist das Endergebnis selbstverständlich ebenfalls ein Vorhersagemodell, das aber vermutlich keine maximale Vorhersagegüte besitzt. Für die Effektschätzung muss ein Modell keine maximale Vorhersagegüte aufweisen; im Vordergrund sollten vielmehr leicht interpretierbare und verlässliche Ergebnisse stehen. In diesem Szenario kann die Variablenselektion auf Grundlage von Fachwissen erfolgen. Mit Sachkenntnis lässt sich ein Modell erstellen, das die notwendigen Kovariaten enthält, und das Modell sinnvoll spezifizieren. Die Variablenselektion kann also auf Fachwissen beruhen, wenn das Ziel des Modells die Effektschätzung ist. Im zweiten Szenario, also wenn maximale Vorhersagegüte angestrebt wird, ist die Variablenselektion etwas komplizierter, und dieses Kapitel befasst sich vorwiegend mit solchen Modellen.
Vorhersagemodelle sollten eine hohe Vorhersagegüte aufweisen und gleichzeitig sparsam hinsichtlich der Anzahl der benötigten Variablen sein. Der englische Fachbegriff für ein solches sparsames Modell (bezogen auf die Anzahl der Prädiktoren) lautet the parsimonious model. Je mehr Prädiktoren ein Modell enthält, desto schwieriger ist es für andere, das Modell anzuwenden, insbesondere wenn es schwer zu erhebende Prädiktoren umfasst. Außerdem kann Overfitting auftreten, wenn die Zahl der Prädiktoren zu groß ist.
Variablenselektion (engl. variable selection, feature selection) bedeutet, dass überflüssige Variablen methodisch eliminiert werden. Man beginnt dabei mit einer größeren Zahl von Variablen, den sogenannten Kandidatenvariablen (engl. candidate predictors), die schrittweise eliminiert werden, bis die wichtigsten übrig bleiben. Es gibt mehrere Methoden der Variablenselektion. Diese werden im Folgenden besprochen.
Stepwise variable selection: backward & forward stepwise selection
Die schrittweise (stepwise) Variablenselektion ist ein automatisierter Prozess, bei dem die Software entscheidet, welche Variablen in ein Regressionsmodell aufgenommen werden. Dies kann entweder mit forward stepwise selection oder mit backward stepwise selection geschehen.
- Forward stepwise selection bedeutet, dass das Modell mit 0 (null) Variablen beginnt und anschließend jeweils eine Variable hinzugefügt wird. Die hinzugefügte Variable verbleibt im Modell, wenn sie zu einem besseren Modell führt.
- Backward stepwise selection bedeutet, dass alle Kandidatenvariablen von Beginn an im Modell enthalten sind. Anschließend wird jeweils eine Variable eliminiert. Ausgeschlossen wird diejenige Variable, deren Entfernung das Modell am wenigsten beeinflusst (da die Eliminierung dieser Variablen die geringste Auswirkung auf das Modell hat). Dies wird wiederholt, bis keine Variable mehr entfernt werden kann, ohne dass das Modell signifikant schlechter wird.
- Bidirectional stepwise elimination ist eine Kombination aus beiden oben genannten Verfahren.
Um zu beurteilen, ob das Modell besser oder schlechter wird, muss ein Kriterium herangezogen werden. In den meisten Fällen wird das Akaike information criterion (AIC) verwendet. Das AIC ist ein Maß für das Gleichgewicht zwischen der Komplexität des Modells (Anzahl der Prädiktoren) und der Goodness-of-Fit (Vorhersagegüte). Je niedriger das AIC, desto besser das Modell.
Diese Methoden sollten grundsätzlich nie verwendet werden. Sie verstoßen nämlich gegen mehrere Prinzipien der statistischen Inferenz. Die Folgen der Anwendung einer stepwise selection sind (Harrell):
- R2-Werte sind verzerrt (zu hoch).
- Die Selektion der Variablen selbst beruht auf P-Werten (Signifikanztests), was eigentlich eine vorab spezifizierte Hypothese voraussetzt.
- Der Standardfehler (SE) ist verzerrt (zu klein).
- Konfidenzintervalle sind verzerrt (zu eng).
- P-Werte werden fälschlich zu klein, und es entstehen Probleme durch multiples Testen.
- Die Regressionskoeffizienten sind verzerrt (die Koeffizienten und damit der Effekt sind fälschlich zu groß).
Dennoch zeigen wir, wie stepwise variable selection in R durchgeführt wird. Installieren Sie zunächst das Package olsrr und laden Sie es. Im folgenden Beispiel erstellen wir ein lineares Modell mit den Daten mpg. Wir sagen hwy vorher, indem wir hwy ~. angeben, wobei . für "alle Variablen" in mpg steht. Anschließend können Sie mit der Funktion tidy() aus broom das Ergebnis betrachten. Danach wird ols_step_forward_aic() verwendet, um eine forward stepwise selection durchzuführen. Das Ergebnis wird anschließend visualisiert. Wir geben die Ergebnisse auch aus, um Informationen über zu erhalten. Die entsprechende Funktion für backward stepwise selection ist ols_step_backward_aic().
library(olsrr)
library(broom)
library(tidyverse)

## Erstellt das Modell
model <- lm(hwy ~., data = mpg)

## Ergebnisse des Modells vor der forward stepwise selection ansehen
tidy(model)

## Forward stepwise selection
forward<-ols_step_forward_aic(model)

plot(forward) + theme_bw()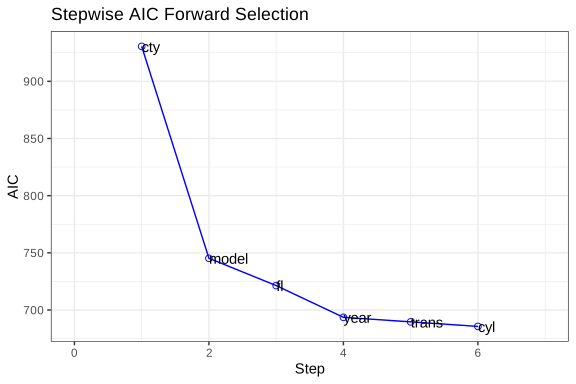
print(forward) Selection Summary
-------------------------------------------------------------------
Variable AIC Sum Sq RSS R-Sq Adj. R-Sq
-------------------------------------------------------------------
cty 930.567 7549.302 712.360 0.91378 0.91340
model 745.249 8026.474 235.189 0.97153 0.96598
fl 721.367 8056.430 205.232 0.97516 0.96970
year 693.609 8080.938 180.724 0.97812 0.97317
trans 689.636 8097.136 164.526 0.98009 0.97436
cyl 685.650 8101.292 160.370 0.98059 0.97487
-------------------------------------------------------------------Univariates Screening
Viele Forschende verwenden ein univariates Screening, um festzulegen, welche Variablen in das Modell aufgenommen werden. Dabei wird jeweils eine Variable getestet, und ist sie statistisch signifikant, wird sie in das endgültige Modell aufgenommen. Auch dies ist falsch, da die Variablenselektion nicht auf P-Werten beruhen sollte. Zudem kann es dazu führen, dass Variablen, die nur in Gegenwart anderer Variablen signifikant sind, ausgeschlossen werden. Mit dieser Methode können also wichtige Prädiktoren verloren gehen.
LASSO (least absolute shrinkage and selection operator)
LASSO ist ein Regressionsmodell, das zur Selektion von Variablen verwendet werden kann. LASSO berechnet den Parameter , mit dem komplexere Modelle bestraft werden, wodurch Variablen ausgeschlossen werden können.
In R wird das Package glmnet() verwendet, um LASSO durchzuführen. Das Package akzeptiert keinen Data Frame, sondern erwartet, dass Outcome und Prädiktoren in zwei getrennten Matrizen angegeben werden (siehe unten). Alle Variablen vom Typ character müssen in factor umgewandelt werden. Anschließend muss für Faktoren ein One-hot-Encoding erfolgen, das heißt, ein Faktor mit 4 Stufen wird in 4 verschiedene binäre Variablen umgewandelt (eine für jede Stufe der ursprünglichen Variablen). Folgen Sie den Kommentaren im Code unten, um nachzuvollziehen, welche Schritte durchgeführt werden.
## mltools laden, um Zugriff auf die Funktion one_hot() zu erhalten
library(mltools)
## data.table laden, um Zugriff auf die Funktion as.data.table() zu erhalten
library(data.table)
## glmnet laden, das lasso() enthält
library(glmnet)

## Wandelt alle character in factor um
mpg <- mpg %>% mutate_if(is.character, as.factor)

## One-hot encoding
mpg <- one_hot(as.data.table(mpg))

## Alle Prädiktoren kommen in eine Matrix
x <- as.matrix(select(mpg, -hwy))

## Das Outcome kommt in eine andere Matrix
y <- as.matrix(select(mpg, hwy))

my_lasso <- glmnet(x,y)
print(my_lasso)
Das Ergebnis sieht wie folgt aus (gekürzt). DF (degrees of freedom) ist die Anzahl der Freiheitsgrade, also die Anzahl der Prädiktoren. %Dev ähnelt dem Maß R2 (also einem Maß für die Vorhersagegüte).
Call:  glmnet(x = x, y = y)

   Df  %Dev Lambda
1   0  0.00 5.6800
2   1 15.51 5.1750
3   1 28.39 4.7160
4   1 39.09 4.2970
5   1 47.97 3.9150
6   1 55.34 3.5670
7   1 61.46 3.2500
..................
80 63 98.07 0.0037
81 63 98.07 0.0033
82 63 98.07 0.0030
83 63 98.07 0.0028
84 63 98.07 0.0025
85 64 98.07 0.0023
Für ein bestimmtes können wir mit folgendem Befehl sehen, welche Variablen im Modell enthalten sind:
coef(my_lasso, 1)83 x 1 sparse Matrix of class "dgCMatrix"
s1
(Intercept) 6.1476740
drv_4 -0.8684261
cty 1.0483884Die Prädiktoren im besten Modell lassen sich mit der Funktion plot_glmnet() aus dem Package plotmo visualisieren. Falls Sie plotmo nicht haben, müssen Sie es zuerst installieren (install.packages("plotmo")). Im Folgenden visualisieren wir die 5 besten Prädiktoren.
library(plotmo)
plot_glmnet(my_lasso, label=5)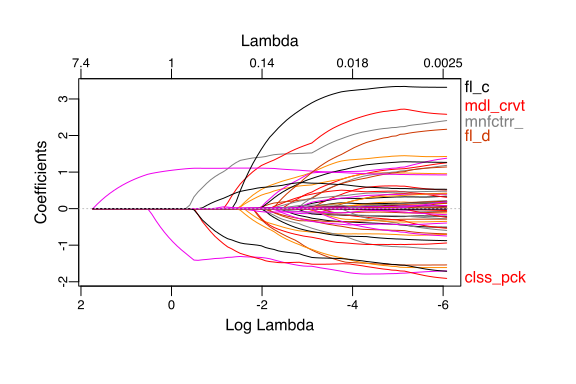
LASSO sollte eigentlich mit Kreuzvalidierung (cross validation) durchgeführt werden. Um den Prozess mit einer Kreuzvalidierung mit 5 Folds zu wiederholen, wird folgender Befehl verwendet:
cv_lasso_fit <- cv.glmnet(x = x, y = y,
                          alpha = 1,
                          nfolds = 5)
Das Ergebnis des LASSO können wir wie folgt visualisieren:
plot(cv_lasso_fit)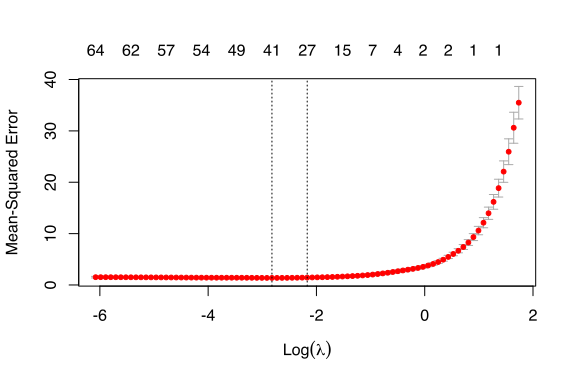
Die obige Grafik zeigt den MSE (mittlerer quadratischer Fehler) auf der Y-Achse, und die X-Achse zeigt log() mit einem Konfidenzintervall für jedes Modell. Es gibt zwei vertikale (gestrichelte) Linien. Die linke Linie zeigt, wo der niedrigste MSE liegt. Die rechte Linie liegt 1 Standardfehler höher (im MSE) und kennzeichnet Lambda für ein stärker regularisiertes Modell. Ein regularisiertes Modell weist weniger Overfitting auf und sagt Testdaten besser vorher.
Das für das Modell mit dem niedrigsten MSE lässt sich mit folgendem Befehl extrahieren:
cv_lasso_fit$lambda.min[1] 0.0213847Wir können Lambda für das Modell extrahieren, dessen MSE 1 Standardfehler höher liegt:
cvdata$lambda.1se[1] 0.071673Um zu sehen, um welche Variablen es sich handelt, schreibt man:
coef(cv_lasso_fit, cv_lasso_fit$lambda.1se)83 x 1 sparse Matrix of class "dgCMatrix"
s1
(Intercept) -64.0455866216
manufacturer_audi 1.5005369115
manufacturer_jeep -0.1174150053
manufacturer_land rover 0.1612552376
manufacturer_nissan -0.1059190236
manufacturer_pontiac 0.8169337991
model_4runner 4wd -0.5598256719
model_a4 quattro 0.5838794421
model_c1500 suburban 2wd -0.2756224964
model_caravan 2wd -0.3546136186
model_corvette 1.5663555709
model_f150 pickup 4wd -0.2270155529
model_forester awd 0.6830388254
model_grand prix 0.0193951129
model_maxima -0.6714694460
model_new beetle 0.2395820131
model_passat 0.2035794420
model_range rover 0.0072253567
model_toyota tacoma 4wd -0.1979795939
year 0.0353436525
cyl -0.0568519000
trans_auto(av) -0.4658374498
trans_auto(l3) -0.8101522067
trans_auto(l4) -0.0860617303
trans_auto(l5) 0.1494574949
trans_auto(s5) 0.5779641947
drv_4 -1.5127151569
drv_f 0.0009265857
cty 1.0643633366
fl_c 2.5131385470
fl_d 0.5011373754
fl_e -0.8901996792
class_2seater 0.0315777873
class_compact 0.0529440191
class_midsize 0.6824124438
class_pickup -1.4729080052
class_suv -1.2054913050Machine Learning zur Variablenselektion
Machine Learning, insbesondere Random Forest, kann ebenfalls zur Identifizierung wichtiger Variablen eingesetzt werden. Machine Learning (Random Forest) bietet eine natürliche Möglichkeit, die Stärke jedes Prädiktors zu quantifizieren, sodass sich alle Prädiktoren nach ihrer Vorhersagekraft ordnen lassen. Dies ist in klinischen Studien zunehmend verbreitet, und der Vorteil besteht darin, dass diese Methoden eine sehr große Zahl von Kandidatenvariablen bewältigen können (Tausende von Variablen sind problemlos möglich). Andere Methoden wie die Hauptkomponentenanalyse (principal component analysis, PCA) können ebenfalls verwendet werden, Random Forest bietet jedoch gegenüber diesen mehrere Vorteile. Diese Methoden werden in den jeweiligen Kapiteln besprochen.