
Maße der Vorhersagegüte
engl. performance metrics, evaluation metrics
In mehreren vorangegangenen Kapiteln wurde der Begriff Precision regelmäßig verwendet, um die Vorhersagefähigkeit von Modellen zu bezeichnen. Das ist eigentlich nicht korrekt, denn Precision ist ein spezifisches Maß der Vorhersagefähigkeit. Es gibt eine ganze Reihe von Maßen, die verschiedene Facetten der Vorhersagefähigkeit beschreiben. Diese Maße werden verwendet, um Modelle zu evaluieren und miteinander zu vergleichen (beispielsweise bei der Kreuzvalidierung). Welches Maß optimal ist, hängt von der Fragestellung und der Situation ab.
Aus dieser Perspektive gibt es drei Arten von Modellen:
- Klassifikationsmodelle (Klassifikation).
- Regressionsmodelle (Regression).
- Überlebenszeitmodelle (Überlebenszeitanalyse).
In diesem Zusammenhang bezieht sich Regression nicht auf das klassische lineare Regressionsmodell, sondern auf alle Modelle, die stetige Endpunkte vorhersagen (unabhängig davon, ob dies mit klassischen Regressionsmodellen, Machine Learning, Deep Learning oder einer anderen Methode geschieht). Mit Regression ist hier ein Modell mit stetiger Zielgröße gemeint.
Klassifikation bezeichnet alle Modelle, gleich welchen Typs, die eine kategoriale Zielgröße vorhersagen. In den meisten Fällen ist der Endpunkt binär (ja/nein, krank/gesund, tot/lebendig, etc.), er kann aber auch multinomial sein (>2 Kategorien).
Die dritte Art von Modell ist die Überlebenszeitanalyse, bei der der Endpunkt die Zeit bis zum Eintreten eines Ereignisses ist. Die Überlebenszeitanalyse nimmt eine Sonderstellung ein, weil der Endpunkt stetig ist (Zeit), in der Regel aber nicht alle Teilnehmenden das untersuchte Ereignis erleben bzw. davon betroffen sind. Wer das Ereignis während der Beobachtungszeit der Studie nicht erlebt bzw. nicht davon betroffen ist, wird zensiert. Deshalb ist das Modell kein gewöhnliches Klassifikationsmodell, und es sind eigene Maße der Vorhersagefähigkeit erforderlich.
Klassifikation
Konfusionsmatrix (Confusion matrix)
Die Konfusionsmatrix ist grundlegend für die Beurteilung von Klassifikationsmodellen. Diese einfache Kreuztabelle enthält mehrere wichtige Maße. Die folgende Kreuztabelle zeigt eine Konfusionsmatrix. Die Matrix wird wie folgt gelesen:
- True positive (TP): Sowohl das Modell als auch die Realität zeigen einen positiven Endpunkt.
- True negative (TN): Sowohl das Modell als auch die Realität zeigen einen negativen Endpunkt.
- False positive (FP): Das Modell sagt einen positiven Endpunkt vorher, in Wirklichkeit war der Endpunkt jedoch negativ.
- etc.
| Vorhergesagt positiv (PP) | Vorhergesagt negativ (PN) | |
|---|---|---|
| Tatsächlich positiv (P) | True positive (TP) | False negative (FN) |
| Tatsächlich negativ (N) | False positive (FP) | True negative (TN) |
Confusion matrix (Konfusionsmatrix).
Aus einer Konfusionsmatrix lassen sich folgende Parameter berechnen:
- Accuracy: Der Anteil der Positiven, die als positiv klassifiziert werden.
- Sensitivität:
- Formel:
- Bedeutung: Anteil der Positiven, die als positiv klassifiziert werden.
- Synonym: Recall, True Positive Rate, Hit Rate.
- Spezifität:
- Formel:
- Bedeutung: Anteil der Negativen, die als negativ klassifiziert werden.
- Synonym: True Negative Rate
- Positive Predictive Value (PPV):
- Formel:
- Bedeutung: Wahrscheinlichkeit eines positiven Endpunkts, wenn positiv vorhergesagt.
- Synonym: Precision
- Negative Predictive Value (NPV):
- Formel:
- Bedeutung: Wahrscheinlichkeit eines negativen Endpunkts, wenn negativ vorhergesagt.
- F-Score:
- Formel:
ROC und AUC-ROC
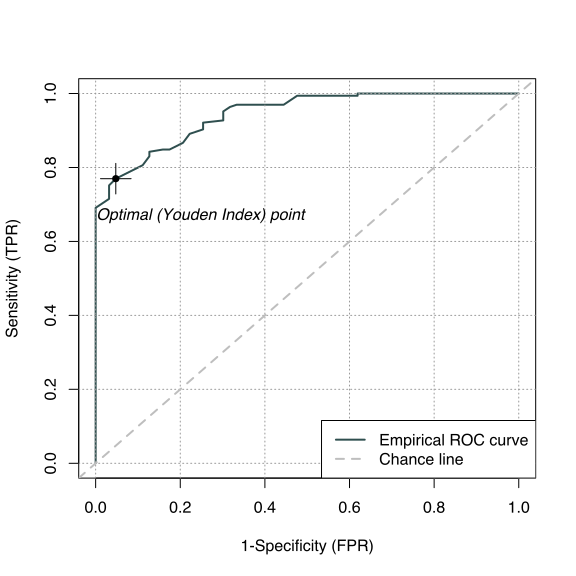
Eine ROC-Kurve ist eine grafische Darstellung der Vorhersagefähigkeit eines Klassifikationsmodells mit binärem Endpunkt. Sie veranschaulicht, wie sich die Vorhersagefähigkeit verändert, wenn die Entscheidungsschwelle angepasst wird. Die Entscheidungsschwelle ist der Grenzwert (für die Wahrscheinlichkeit), ab dem ein Fall als positiv klassifiziert wird. Sagt das Modell eine Wahrscheinlichkeit für einen positiven Endpunkt vorher, die über der Entscheidungsschwelle liegt, so sagt es einen positiven Endpunkt vorher. Wird die Entscheidungsschwelle auf 50 % Wahrscheinlichkeit gesetzt und für einen Fall eine Wahrscheinlichkeit von 49 % für einen positiven Endpunkt vorhergesagt, so wird das Modell einen negativen Endpunkt vorhersagen. Wird für den Fall dagegen eine Wahrscheinlichkeit von 51 % für einen positiven Endpunkt vorhergesagt, so wird das Modell einen positiven Endpunkt vorhersagen. Senkt man die Entscheidungsschwelle von 50 % auf 10 %, werden deutlich mehr Fälle als positiv klassifiziert; die Sensitivität steigt, die Spezifität sinkt jedoch. Die ROC-Kurve entsteht, indem man die Sensitivität gegen die FPR (False Positive Rate, die gleich 1-Spezifität ist) für alle Werte der Entscheidungsschwelle aufträgt. Es folgt ein Beispiel für eine ROC-Kurve.
Fläche unter der ROC-Kurve (AUC-ROC)
Beachten Sie die gestrichelte diagonale Linie in der obigen ROC-Kurve. Die Fläche unter der gestrichelten Linie beträgt 0,5 (die Fläche ist dimensionslos). Eine ROC-Kurve, die auf der diagonalen Linie liegt, hat keine Vorhersagefähigkeit. Die Vorhersagefähigkeit des Modells entspricht dann dem Zufall. Ein Modell, dessen ROC-Kurve oberhalb der Linie verläuft, ist besser als der Zufall. Die Fläche unter der ROC-Kurve kann also zusammenfassen, wie gut das Modell ist. ROC-Kurven nahe 1 sieht man äußerst selten; Beispiele für Analysen mit einer AUC-ROC nahe 1,0 sind PCR-Analysen auf Viren. Klinische Vorhersagemodelle haben in der Regel eine AUC-ROC zwischen 0,6 und 0,9. Modelle in der Finanzwirtschaft, der Psychologie und anderen Bereichen weisen ähnliche ROC-Ergebnisse auf.
Concordance index (C-Index)
Der C-Index ist eine Verallgemeinerung der ROC-Kurve. Der C-Index berücksichtigt Zensierung, was Voraussetzung für seine Anwendung in der Überlebenszeitanalyse ist. Der C-Index ist die globale Fähigkeit des Modells, die Überlebenszeit vorherzusagen.
Die Formel für den C-Index:
\begin{equation} \text{C-index} = \frac{ \sum_{i, j} \mathbb{1}_{T_j < T_i} \cdot \mathbb{1}_{\eta_j > \eta_i} \cdot \delta_j }{\sum_{i, j} \mathbb{1}_{T_j < T_i}\cdot \delta_j } \end{equation}
Die Cox-Regression und andere Modelle, die die Cox-Loss-Funktion verwenden, werden mit dem C-Index evaluiert.
Der C-Index wird analog zur ROC interpretiert. Ein C-Index von 1,0 bedeutet also, dass das Modell perfekt ist. Ein C-Index von 0,5 bedeutet, dass das Modell nicht besser ist als der Zufall.
Vertiefung: Uno et al.
Brier Score
Der Brier Score wird verwendet, um die Vorhersagefähigkeit eines Überlebenszeitmodells zum Zeitpunkt zu evaluieren. Der Brier Score gibt also an, wie gut das Modell zu einem bestimmten Zeitpunkt ist. Der Brier Score liegt zwischen 0 und 1. Der Brier Score ist der mittlere quadrierte Abstand zwischen beobachtetem Überleben und tatsächlichem Überleben; 0 bedeutet, dass das Modell optimal ist, da kein Unterschied zwischen Vorhersage und Beobachtung besteht.
Integrierter Brier Score
Der integrierte Brier Score liefert ein Gesamtmaß des Brier Score über alle Werte der Überlebenszeit (survival time).
Regression
Die folgenden Maße werden verwendet, um Modelle mit stetigen Zielgrößen zu evaluieren. Der Error, der in mehreren dieser Maße verwendet wird, ist die Differenz zwischen dem tatsächlichen Wert und dem vorhergesagten Wert von .
R2
R2 ist die durch das Modell erklärte Varianz. Dieses Maß ist zur Beurteilung von Modellen mit stetigen Zielgrößen sehr beliebt. R2 nimmt einen Wert zwischen 0 und 1 an, wobei 0 bedeutet, dass das Modell keine Varianz erklärt (d. h. das Modell hat keine Erklärungskraft), und 1 bedeutet, dass das Modell die gesamte Varianz erklärt.
\begin{equation} {R}^{2} = 1 - \frac { \sum_{i=1}^{n} (\ y_i -\hat{y_i} )^{2} } { \sum_{i=1}^{n} (\ y_i -\bar{y_i} )^{2} } \end{equation}
MAE (Mean Absolute Error)
Der MAE ist der Mittelwert des absoluten Messfehlers. Die Fehler (Errors) werden nicht quadriert, wodurch das Maß weniger empfindlich gegenüber einzelnen Ausreißern (großen Werten) ist.
\begin{equation} MAE = \frac{1}{n} \sum_{i=1}^{n} |{y_i}-\hat{y_i}| \end{equation}
MAPE (Mean Absolute Percent Error)
Der MAPE ist der MAE ausgedrückt in Prozent, ein Maß, das Menschen leicht verstehen. Der Nachteil des MAPE besteht darin, dass er bei Error = 0 nicht berechnet werden kann, weil eine Division (zur Berechnung des Prozentwerts) durch 0 einen unendlichen Wert ergibt. Außerdem neigt der MAPE dazu, Modelle zu bevorzugen, die niedrigere Werte von Y vorhersagen als die tatsächlichen Werte.
\begin{equation} MAPE = \frac{1}{n} \sum_{i=1}^{n} {\left|\frac{{y_i}-\hat{y_i}}{y_i}\right|} \end{equation}
RMSE (Root Mean Squared Error)
Der RMSE ist die Quadratwurzel aus dem Mittelwert der quadrierten Fehler. Der RMSE gibt an, wie weit die Vorhersagen vom tatsächlichen Wert entfernt sind, und zwar in derselben Einheit wie Y. Da der Error quadriert wird, haben einzelne Ausreißer (große Werte) einen größeren Einfluss auf den RMSE als auf MAE und MAPE.
\begin{equation} RMSE = \sqrt{\frac{1}{n} \sum_{i=1}^{n} ({y_i}-\hat{y_i}){^2}}\end{equation}